画像生成

228件
arXiv cs.AI ★4 画像生成 EN

Flow-OPD:フローマッチングモデルのためのオンポリシー蒸留

要約を読む要約を閉じる
📰ニュース

Flow-OPDが、テキストから画像生成モデルのマルチタスクアライメントにおける課題を解決しました。

🔍注目ポイント

オンポリシー蒸留をフローマッチングモデルに統合し、複数の専門家モデルの知識を単一の学生モデルに効率的に集約します。

🔮これからどうなる

テキストから画像生成モデルの性能が大幅に向上し、より高品質で多様な画像を生成できるようになります。

既存のモデルは報酬の希薄さや勾配干渉により性能が低下する問題がありました。
Flow-OPDは、単一報酬で専門家モデルを育成し、その知識をオンポリシーサンプリングとタスクルーティングで学生モデルに統合します。
これにより、GenEvalスコアが63から92へ、OCR精度が59から94へと大幅に向上しました。
arXiv cs.AI ★4 画像生成 EN

解釈可能で構成的な表現のための教師ありスパースオートエンコーダ

要約を読む要約を閉じる
📰ニュース

教師ありスパースオートエンコーダ(SAE)が、Stable Diffusion 3.5で画像の再構成と編集に成功しました。

🔍注目ポイント

L1ペナルティの課題を克服し、学習した特徴と人間の意味論を一致させる新しいSAEを開発しました。

🔮これからどうなる

AIモデルの内部動作がより理解しやすくなり、より直感的で高度な画像編集が可能になります。

SAEは機械学習モデルの解釈可能性を高める手法ですが、L1ペナルティによる再構成の困難さや、学習された特徴と人間の意味論の不一致が課題でした。
本研究では、ニューラルコラプス理論のフレームワークを適応させ、タスクを教師あり学習にすることでこれらの課題を解決しました。
これにより、訓練で見たことのない概念の組み合わせを持つ画像を再構成し、プロンプトなしで意味論的な画像編集が可能になりました。
arXiv cs.AI ★4 画像生成 EN

要因分解型Classifier-Free Guidance(FCFG)

要約を読む要約を閉じる
📰ニュース

拡散モデルにおける反実仮想生成の精度を向上させる新しいガイダンス手法が提案されました。

🔍注目ポイント

属性ごとに異なるガイダンス強度を適用することで、不必要な変化を抑え、より正確な反実仮想画像を生成します。

🔮これからどうなる

医療画像診断やシミュレーションなど、因果関係を考慮した画像生成の信頼性が向上するでしょう。

従来のClassifier-Free Guidance(CFG)は、すべての属性に一律のガイダンス強度を適用するため、反実仮想生成時に不自然な変化が生じる問題がありました。
FCFGは、因果グラフに基づいて属性ごとの制御を可能にし、この問題を解決します。
これにより、自然画像や医療画像データセットにおいて、反実仮想の健全性と可逆性が大幅に改善されました。
arXiv cs.AI ★3 画像生成 EN

マルチモーダル合成画像のための物理ベースのベンチマーク指標

要約を読む要約を閉じる
📰ニュース

マルチモーダル合成画像の評価において、物理法則に基づいた新しいベンチマーク指標「PCMDE」が提案されました。

🔍注目ポイント

既存指標の限界を克服するため、LLMの推論能力と知識ベースマッピング、VLMを組み合わせた評価手法です。

🔮これからどうなる

AI生成画像の品質評価がより高精度になり、特に専門分野や文脈依存の画像生成の信頼性が向上します。

BLEUやCLIPScoreなどの既存指標は、意味的・構造的精度を捉えきれない課題がありました。
PCMDEは、物体検出とVLMによる特徴抽出、適応的なコンポーネント融合、そしてLLMによる物理法則に基づいた構造的・関係的制約の適用という3段階で構成されます。
これにより、位置や整合性などの物理的整合性を評価に組み込むことが可能になります。
arXiv cs.AI ★4 画像生成 EN

拡散サンプリングのためのART:タイムステップスケジュールの強化学習アプローチ

要約を読む要約を閉じる
📰ニュース

拡散モデルの画像生成において、強化学習を用いてタイムステップの最適化手法「ART-RL」が開発されました。

🔍注目ポイント

連続時間強化学習とガウス分布ポリシーを組み合わせ、計算予算内でオイラー離散化誤差を最小化するタイムステップスケジュールを導き出します。

🔮これからどうなる

少ない計算ステップで高品質な画像を生成できるようになり、AI画像生成の効率と品質が向上します。

ART-RLは、時間変数のクロックスピードを制御し、計算をサンプリング経路に沿って再配分することで、総オイラー離散化誤差を最小化します。
一度オフラインで学習すれば、他のデータセットにも再学習なしで適用でき、推論コストを増やさずにFIDスコアを改善します。
arXiv cs.AI ★3 画像生成 EN

AdaCorrection:拡散トランスフォーマーのための適応型オフセットキャッシュ補正

要約を読む要約を閉じる
📰ニュース

拡散トランスフォーマーの画像・動画生成における推論速度を向上させる新手法「AdaCorrection」が発表されました。

🔍注目ポイント

AdaCorrectionは、キャッシュの有効性を時空間信号で推定し、キャッシュと新規アクティベーションを適応的にブレンドすることで、生成品質を維持しつつ高速化します。

🔮これからどうなる

高精細な画像・動画生成AIの推論コストが削減され、より手軽に高品質なコンテンツを生成できるようになります。

拡散トランスフォーマーは高品質な画像・動画生成で最先端ですが、反復的なノイズ除去のため推論が高コストでした。
既存のキャッシュ手法は静的な再利用スケジュールに依存し、生成品質の低下を招いていました。
AdaCorrectionは、追加の学習なしでリアルタイムにキャッシュを補正し、元のFIDスコアを維持しつつ適度な高速化を実現します。
ASCII.jp ★3 画像生成

ChatGPTの画像生成AIは本当に最強か Nano Bananaと比べて見えた“弱点”

要約を読む要約を閉じる
📰ニュース

ChatGPTの画像生成AI「GPT Image 2.0」が、実写人物の再現性で「Nano Banana Pro」に劣る点が指摘されました。

🔍注目ポイント

GPT Image 2.0はデザイン表現に優れる一方、実写人物の一貫性や顔の再現には課題があるようです。

🔮これからどうなる

ユーザーは画像生成AIを選ぶ際、用途に応じて最適なツールを使い分ける必要が出てくるでしょう。

記事では、ChatGPTの画像生成AI「GPT Image 2.0」と、実写人物の生成に特化した「Nano Banana Pro」を比較しています。
GPT Image 2.0はデザイン性の高い画像を生成する能力に長けていますが、実写人物の顔の再現性や、複数枚の画像で人物の一貫性を保つ点ではNano Banana Proに及ばないケースが見られました。
これにより、それぞれのAIが持つ得意分野と弱点が浮き彫りになりました。
GIGAZINE ★3 画像生成

AI生成画像の背景を透明化するのに役立つ画像背景削除ツール「Rembg」

要約を読む要約を閉じる
📰ニュース

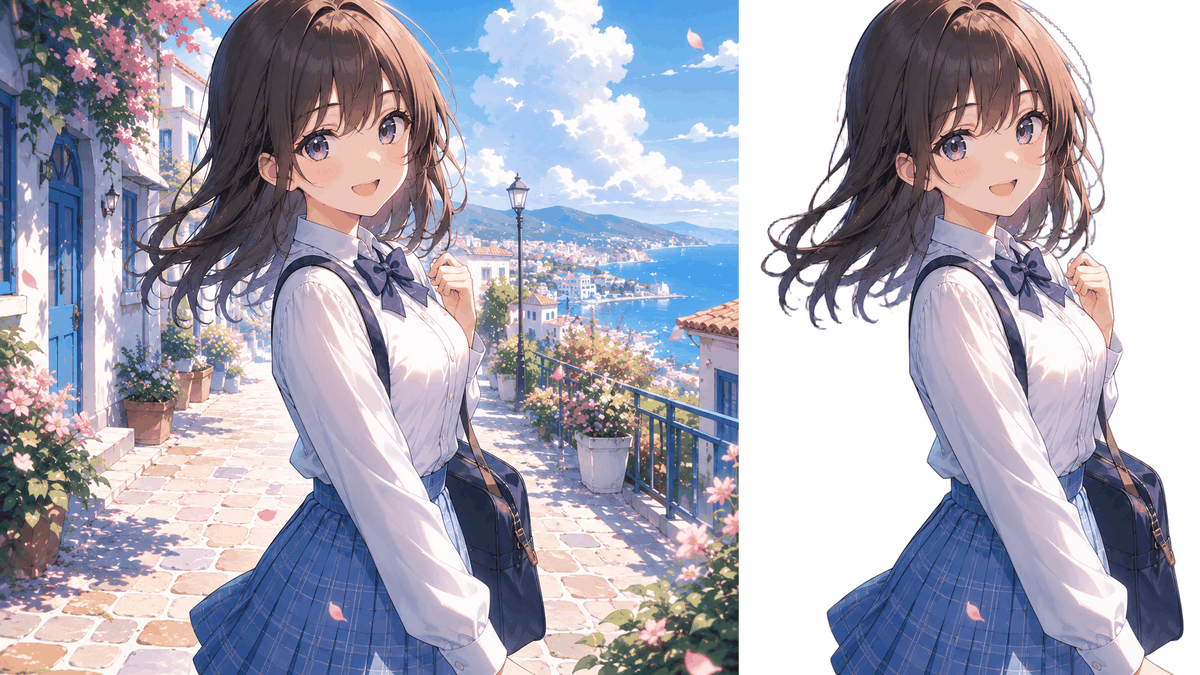
AI生成画像の背景を透明化するオープンソースツール「Rembg」が公開されました。

🔍注目ポイント

16種類以上のAIモデルを切り替え、人物やアニメキャラなど被写体に応じた高精度な背景除去が可能です。

🔮これからどうなる

画像生成AIで作成した素材の加工が容易になり、クリエイターの作業効率が向上します。

Stable Diffusionなどの画像生成AIは透過背景PNGを直接出力できないため、生成画像の利用には別途背景除去が必要でした。
Rembgはローカル環境で無料で利用でき、多様な被写体に対応するAIモデルを搭載しているため、幅広い用途で活用が期待されます。
arXiv cs.AI ★4 画像生成 EN

P-Guide: Parameter-Efficient Prior Steering for Single-Pass CFG Inference

要約を読む要約を閉じる
📰ニュース

P-Guideは、画像生成モデルのCFG推論を単一パスで高速化する新しいフレームワークです。

🔍注目ポイント

初期潜在状態を調整するだけで、従来のCFGと同等の高品質な生成を半分の推論時間で実現します。

🔮これからどうなる

画像生成AIの利用者は、より高速かつ効率的に高品質な画像を生成できるようになります。

Classifier-Free Guidance (CFG) は、画像生成の品質を高めるために不可欠ですが、各サンプリングステップで2回のフォワードパスが必要で計算コストが高いという課題がありました。
P-Guideは、このボトルネックを解消し、単一の推論パスで高品質なガイダンスを可能にします。
平均と分散を共同でモデリングすることで、データ不確実性に対するロバスト性も向上させています。
arXiv cs.AI ★4 LLM EN

MidSteer: Optimal Affine Framework for Steering Generative Models

要約を読む要約を閉じる
📰ニュース

生成AIの振る舞いを制御する新しい理論的枠組み「MidSteer」が発表されました。

🔍注目ポイント

MidSteerは、生成モデルの中間表現を操作し、望ましい概念への変換を最小限の変更で実現します。

🔮これからどうなる

生成AIの安全性や倫理的な利用を向上させ、より意図通りのコンテンツ生成が可能になります。

MidSteerは、概念消去手法LEACEを基盤とし、概念切り替えの理論を拡張したものです。
これにより、画像生成モデルや大規模言語モデルなど、様々なAIモデルで効果的に機能することが示されています。
既存手法の理論的ギャップを埋め、より汎用的な制御を可能にします。
arXiv cs.AI ★4 画像生成 EN

ViTok-v2: Scaling Native Resolution Auto-Encoders to 5 Billion Parameters

要約を読む要約を閉じる
📰ニュース

ViTok-v2が50億パラメータ規模の画像オートエンコーダとして、ネイティブ解像度での画像再構築性能を向上させました。

🔍注目ポイント

NaFlexによるネイティブ解像度対応とDINOv3知覚損失の導入で、高解像度画像での安定した学習と再構築を実現しました。

🔮これからどうなる

高解像度での画像生成や編集の品質が向上し、よりリアルで詳細なビジュアルコンテンツの作成が可能になるでしょう。

従来のViTオートエンコーダは学習解像度外で性能が低下し、敵対的損失に依存するため安定したスケーリングが困難でした。
ViTok-v2はこれらの課題を克服し、約20億枚の画像で学習され、過去最大の50億パラメータに達しました。
これにより、256p以上の解像度で最先端の再構築性能を達成しています。
arXiv cs.AI ★4 画像生成 EN

DBMSolver: A Training-free Diffusion Bridge Sampler for High-Quality Image-to-Image Translation

要約を読む要約を閉じる
📰ニュース

拡散モデルを用いた画像変換のサンプリング速度を大幅に向上させる新手法「DBMSolver」が発表されました。

🔍注目ポイント

拡散ブリッジモデルの構造を利用し、指数積分器で効率的な1次・2次解を導出し、サンプリング回数を最大5分の1に削減します。

🔮これからどうなる

高品質な画像変換がより高速に可能になり、リアルタイム処理やアプリケーションへの応用が加速するでしょう。

DBMSolverは、拡散ブリッジモデル(DBM)の基礎となる確率微分方程式(SDE)と常微分方程式(ODE)の半線形構造に着目しています。
これにより、トレーニング不要でサンプリングの関数評価回数(NFE)を大幅に削減し、同時に画像品質も向上させます。
インペインティング、スタイル変換、セマンティクスから画像への変換など、様々なタスクでその有効性が示されています。