画像生成

228件
OpenAI Blog ★3 画像生成 EN

Minne AtairuとSora:アーティストのビジョンを具現化するAI

要約を読む要約を閉じる
📰ニュース

学際的アーティストMinne Atairu氏が、OpenAIの動画生成AI「Sora」を活用し、自身の芸術的ビジョンを実現した。

🔍注目ポイント

Soraは、アーティストの創造性を刺激し、複雑なコンセプトや抽象的なアイデアを視覚的に表現する新たな手段を提供する。

🔮これからどうなる

アーティストは、時間やコストの制約なく、多様な表現を試せるようになり、アート制作のプロセスが大きく変化する可能性がある。

Minne Atairu氏は、Soraを用いて、自身の作品に登場するキャラクターや物語を動画として生成。
これにより、これまで実現が難しかった動きやシーンを容易に作成できた。
Soraの登場は、映像制作の民主化を加速させ、個人クリエイターの表現の幅を広げることに貢献する。
OpenAI Blog ★4 画像生成 EN

連続時間コンシステンシーモデルの簡素化、安定化、およびスケーリング

要約を読む要約を閉じる
📰ニュース

OpenAIが連続時間コンシステンシーモデルを簡素化・安定化・スケーリングし、拡散モデルと同等の画像品質を2ステップで実現しました。

🔍注目ポイント

わずか2回のサンプリングステップで、最先端の拡散モデルに匹敵する画像生成品質を達成した点が技術的ブレイクスルーです。

🔮これからどうなる

画像生成の高速化により、クリエイターの作業効率が向上し、リアルタイムでのAI画像活用が加速するでしょう。

コンシステンシーモデルは、拡散モデルの課題である多数のサンプリングステップを削減することを目指しています。
今回の進展により、計算コストを大幅に削減しつつ、高品質な画像を生成できるようになりました。
これは、AIモデルの効率性と実用性を高める重要な一歩です。
Hugging Face Blog ★4 画像生成 EN

DiffusersがStable Diffusion 3.5 Largeに対応

要約を読む要約を閉じる
📰ニュース

Hugging FaceのDiffusersライブラリが、最新の画像生成モデルStable Diffusion 3.5 Largeをサポートしました。

🔍注目ポイント

Diffusersは、Stable Diffusion 3.5 Largeを簡単に利用できる統合環境を提供し、開発者が最新モデルを迅速に導入できます。

🔮これからどうなる

開発者は最新の高性能画像生成モデルをより手軽に利用でき、多様なアプリケーション開発が加速するでしょう。

Stable Diffusion 3.5 Largeは、Stability AIが開発した最先端の画像生成モデルで、高品質な画像を生成できます。
Diffusersは、様々な拡散モデルを統一されたインターフェースで扱えるHugging Faceのオープンソースライブラリです。
今回の統合により、モデルのロードや推論が簡素化され、研究者や開発者にとっての利便性が向上します。
OpenAI Blog ★4 画像生成 EN

Consistency Models:高速な画像生成を可能にする新しいAIモデル

要約を読む要約を閉じる
📰ニュース

OpenAIが拡散モデルの課題を解決し、高速な画像生成を実現する「Consistency Models」を発表しました。

🔍注目ポイント

拡散モデルの反復サンプリングプロセスを不要にし、ワンステップで高品質な画像を生成できる点が画期的です。

🔮これからどうなる

AIによる画像・音声・動画生成がさらに高速化され、クリエイターの作業効率が大幅に向上するでしょう。

拡散モデルは画像生成分野で大きな進歩をもたらしましたが、その反復的なサンプリングプロセスが生成速度のボトルネックでした。
Consistency Modelsは、この問題を解決するために設計され、生成速度を劇的に向上させつつ、高品質な出力を維持します。
これにより、リアルタイムでのAI生成コンテンツの利用が現実味を帯びてきます。
Hugging Face Blog ★4 画像生成 EN

DiffusersがStable Diffusion 3を歓迎

要約を読む要約を閉じる
📰ニュース

Hugging FaceのDiffusersライブラリが、最新の画像生成モデルStable Diffusion 3に対応しました。

🔍注目ポイント

Diffusersの統一されたインターフェースを通じて、Stable Diffusion 3を簡単に利用・実験できる点が技術的ポイントです。

🔮これからどうなる

開発者や研究者は、より手軽に高性能な画像生成モデルを試したり、自身のプロジェクトに組み込んだりできるようになります。

Diffusersは、様々な拡散モデルを扱うためのオープンソースライブラリです。
Stable Diffusion 3は、テキストと画像の理解度を向上させ、より高品質な画像を生成できるとされています。
今回の統合により、Diffusersユーザーは最新モデルの恩恵をすぐに受けられます。
Hugging Face Blog ★4 画像生成 EN

Artificial Analysis Text to Image リーダーボード&アリーナのローンチ

要約を読む要約を閉じる
📰ニュース

Hugging Faceがテキストから画像を生成するモデルの性能を評価する新しいリーダーボードとアリーナを公開しました。

🔍注目ポイント

ユーザーが生成した画像を評価し、モデルの優劣を競い合うことで、客観的な性能比較が可能になります。

🔮これからどうなる

画像生成AIの開発者や研究者は、自身のモデルの客観的な評価指標を得て、改善に役立てることができます。

このリーダーボードは、ユーザーがテキストプロンプトを入力し、複数のモデルが生成した画像を比較評価する形式です。
これにより、モデルの品質や創造性、指示への忠実度などを多角的に評価できます。
Hugging Faceは、AIコミュニティ全体の進歩を加速させることを目指しています。
OpenAI Blog ★4 画像生成 EN

Soraの第一印象

要約を読む要約を閉じる
📰ニュース

OpenAIが開発した動画生成AI「Sora」をクリエイターに提供し、その活用方法を検証中。

🔍注目ポイント

テキストから高品質な動画を生成するSoraが、クリエイティブプロセスにどう貢献するかを評価。

🔮これからどうなる

動画制作の効率化や新たな表現手法の開拓により、クリエイターの創造性が向上する。

OpenAIは先月Soraを発表して以来、アーティストと協力してSoraが彼らの創造的なプロセスにどのように役立つかを学んでいます。
これにより、Soraの能力と限界を理解し、今後の開発に役立てることを目指しています。
Hugging Face Blog ★4 画像生成 EN

SegMoE: Segmind Diffusionエキスパート混合モデル

要約を読む要約を閉じる
📰ニュース

Segmindが、高速かつ高品質な画像生成を可能にする新しい拡散モデル「SegMoE」を発表しました。

🔍注目ポイント

Mixture-of-Experts (MoE) アーキテクチャを拡散モデルに適用し、推論速度を大幅に向上させつつ画質を維持しています。

🔮これからどうなる

画像生成AIの利用者は、より速く、より効率的に高品質な画像を生成できるようになります。

SegMoEは、複数の専門家(エキスパート)ネットワークを組み合わせることで、必要な部分のみを計算し、推論時間を短縮します。
特に、Stable Diffusion 1.5と比較して最大2.5倍の高速化を実現し、同時にFIDスコアも改善しています。
この技術は、リソースが限られた環境でも高性能な画像生成を可能にします。
Hugging Face Blog ★4 画像生成 EN

ONNX RuntimeとOliveでSD TurboおよびSDXL Turboの推論を高速化

要約を読む要約を閉じる
📰ニュース

Hugging FaceがONNX RuntimeとOliveを活用し、SD TurboおよびSDXL Turboの推論速度を大幅に向上させました。

🔍注目ポイント

最適化されたONNXモデルとOliveの自動最適化ツールチェーンにより、推論レイテンシが最大2倍短縮されました。

🔮これからどうなる

ユーザーはより高速で効率的な画像生成を体験でき、リアルタイムアプリケーションへの応用が広がります。

SD Turboはリアルタイム画像生成に特化したモデルで、SDXL Turboは高品質な画像生成が可能です。
ONNX Runtimeは機械学習モデルの推論を高速化するオープンソースライブラリであり、OliveはONNX Runtimeと連携してモデルを自動で最適化するツールです。
これらの技術を組み合わせることで、推論性能が飛躍的に向上しました。
Hugging Face Blog ★4 画像生成 EN

Hugging Face SpacesでGradioを使ってComfyUIワークフローを無料で実行

要約を読む要約を閉じる
📰ニュース

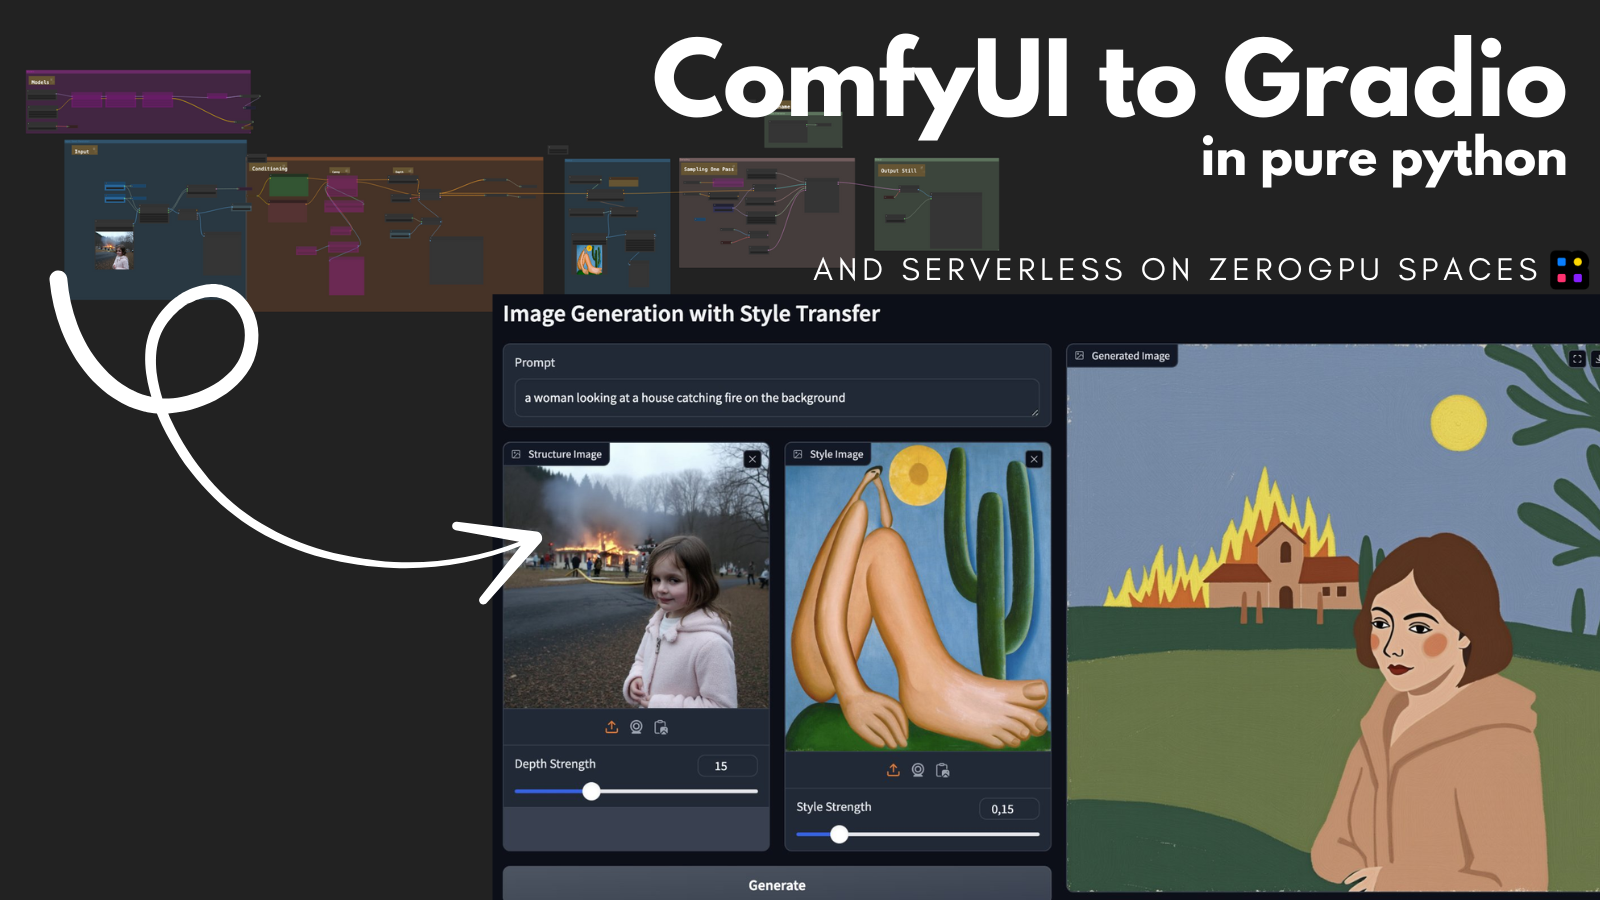
Hugging Face Spaces上でGradioを利用し、ComfyUIのワークフローを無料で実行できるようになった。

🔍注目ポイント

ComfyUIの複雑な画像生成ワークフローを、ブラウザから手軽に無料で利用できる環境が提供された。

🔮これからどうなる

画像生成AIの利用ハードルが下がり、より多くのユーザーが高度なワークフローを試せるようになる。

ComfyUIは、Stable Diffusionなどの画像生成モデルをノードベースで柔軟に操作できるツールです。
通常はローカル環境でのセットアップが必要ですが、Hugging Face SpacesとGradioの組み合わせにより、クラウド上で手軽に利用可能になりました。
これにより、GPUリソースがないユーザーでも高度な画像生成を体験できます。
Hugging Face Blog ★4 画像生成 EN

aMUSEdの紹介:効率的なテキストから画像生成

要約を読む要約を閉じる
📰ニュース

Hugging Faceが、より効率的なテキストから画像生成モデル「aMUSEd」を発表しました。

🔍注目ポイント

aMUSEdは、既存モデルより少ない計算リソースで高品質な画像を生成できるのが特徴です。

🔮これからどうなる

開発者はより低コストで画像生成AIを利用でき、クリエイターは高速な画像生成を享受できます。

aMUSEdは、GoogleのMUSEモデルをベースにしており、拡散モデルとは異なるアーキテクチャを採用しています。
これにより、推論速度が向上し、より少ないステップで画像を生成することが可能です。
特にリソースが限られた環境での利用に適しています。
Hugging Face Blog ★4 画像生成 EN

Latent Consistency LoRAでSDXLを4ステップで高速化

要約を読む要約を閉じる
📰ニュース

Latent Consistency LoRA (LC-LoRA) を用いて、SDXLモデルの画像生成ステップを大幅に削減しました。

🔍注目ポイント

LC-LoRAは、少ないステップで高品質な画像を生成できるよう、既存の拡散モデルを高速化する技術です。

🔮これからどうなる

ユーザーはより高速に高品質な画像を生成できるようになり、リアルタイムアプリケーションへの応用が期待されます。

拡散モデルは通常多くのステップを要しますが、LC-LoRAは潜在空間での一貫性を学習することで、わずか4ステップでの生成を可能にしました。
これにより、計算コストを削減しつつ、視覚的な品質を維持できます。
Hugging Faceは、この技術をSDXLに適用し、その効果を実証しました。