画像生成

228件
Hugging Face Blog ★3 画像生成 EN

SDXLのシンプルな最適化を探る

要約を読む要約を閉じる
📰ニュース

Hugging FaceがSDXLの推論速度を向上させるためのシンプルな最適化手法を公開しました。

🔍注目ポイント

モデルの構造変更なしに、推論時のメモリ使用量と計算量を削減する手法が示されています。

🔮これからどうなる

より多くのユーザーが低スペック環境でもSDXLを利用できるようになり、画像生成の敷居が下がります。

この最適化は、特にGPUメモリが限られている環境で効果を発揮します。
具体的には、モデルの一部をCPUにオフロードしたり、推論時のバッチサイズを調整したりするなどの手法が紹介されています。
これにより、より高速かつ効率的な画像生成が可能になります。
OpenAI Blog ★4 LLM EN

DALL·E 3がChatGPT PlusおよびEnterpriseで利用可能に

要約を読む要約を閉じる
📰ニュース

OpenAIの画像生成AI「DALL·E 3」がChatGPT PlusおよびEnterpriseユーザー向けに提供開始されました。

🔍注目ポイント

DALL·E 3は、ChatGPTとの連携により、より自然な会話で画像を生成できる点が画期的です。

🔮これからどうなる

ChatGPTユーザーは、テキストと画像をシームレスに組み合わせたクリエイティブな作業が容易になります。

DALL·E 3は、以前からMicrosoft Copilotで利用可能でしたが、今回ChatGPT PlusおよびEnterpriseユーザーにも展開されました。
OpenAIは、より広範なリリースに向けて安全対策を強化し、プロンプトの拒否やバイアスの軽減に取り組んでいます。
また、画像の出所を追跡するプロベナンス研究も進めています。
OpenAI Blog ★4 画像生成 EN

DALL·E 3システムカード

要約を読む要約を閉じる
📰ニュース

DALL·E 3の安全性評価とリスク軽減策をまとめたシステムカードが公開されました。

🔍注目ポイント

有害なコンテンツ生成を防ぐための安全対策と、その限界が詳細に記述されています。

🔮これからどうなる

ユーザーはDALL·E 3の安全性に関する理解を深め、より責任ある利用が期待されます。

DALL·E 3は、有害なコンテンツ(ヘイトスピーチ、暴力、性的コンテンツなど)の生成を抑制するよう設計されています。
しかし、完璧ではなく、特定のプロンプトでは意図しない出力が生じる可能性も指摘されています。
OpenAIは、継続的な改善とユーザーからのフィードバックを重視しています。
Hugging Face Blog ★4 画像生成 EN

JAXとCloud TPU v5eでStable Diffusion XLの推論を高速化

要約を読む要約を閉じる
📰ニュース

Hugging FaceがJAXとCloud TPU v5eを使い、Stable Diffusion XLの推論を大幅に高速化しました。

🔍注目ポイント

TPU v5eの効率的な並列処理能力とJAXの最適化により、推論速度が従来のGPUより向上しました。

🔮これからどうなる

より高速で低コストな画像生成が可能になり、クリエイターや開発者の生産性が向上します。

Stable Diffusion XLは高品質な画像生成モデルですが、推論には計算リソースが必要です。
Hugging FaceはGoogle CloudのTPU v5eをJAXフレームワークで活用し、この課題を解決しました。
これにより、推論コストを抑えつつ、生成時間を短縮できることが示されました。
Hugging Face Blog ★4 画像生成 EN

TRLを介したDDPOによるStable Diffusionモデルのファインチューニング

要約を読む要約を閉じる
📰ニュース

Hugging FaceがTRLライブラリを使い、DDPOでStable Diffusionモデルをファインチューニングする手法を発表しました。

🔍注目ポイント

DDPOは人間のフィードバックなしに、報酬モデルと強化学習で画像生成モデルを最適化できるのが特徴です。

🔮これからどうなる

これにより、より高品質で特定のニーズに合わせた画像生成モデルを効率的に開発できるようになります。

DDPO (Direct Preference Optimization for Diffusion Models) は、拡散モデルの性能を向上させるための新しい強化学習手法です。
従来のRLHF(人間のフィードバックによる強化学習)とは異なり、DDPOは人間の介入なしにモデルを最適化できるため、コストと時間を大幅に削減できます。
Hugging FaceのTRLライブラリは、このDDPOをStable Diffusionモデルに適用するためのツールを提供し、実践的な実装を容易にしています。
Hugging Face Blog ★4 画像生成 EN

Würstchenの紹介:画像生成のための高速拡散モデル

要約を読む要約を閉じる
📰ニュース

Würstchenは、少ない計算リソースで高品質な画像を生成できる新しい拡散モデルです。

🔍注目ポイント

潜在空間を効率的に利用し、高解像度画像を高速かつ低コストで生成する技術が特徴です。

🔮これからどうなる

画像生成AIの利用がより手軽になり、クリエイターや開発者のコスト負担を軽減します。

従来の拡散モデルは計算コストが高いという課題がありましたが、Würstchenは潜在空間の効率的な利用により、この問題を解決しました。
これにより、より多くの人が高性能な画像生成AIを利用できるようになります。
Hugging Faceで公開されており、誰でも試すことができます。
Hugging Face Blog ★4 画像生成 EN

T2I-AdaptersによるSDXLの効率的な制御可能生成

要約を読む要約を閉じる
📰ニュース

Hugging FaceがSDXL向けにT2I-Adaptersを導入し、より効率的で制御可能な画像生成を可能にしました。

🔍注目ポイント

T2I-Adaptersは、SDXLの画像生成において、参照画像やスケッチなどの追加情報を用いて、より詳細な制御を可能にする軽量なモジュールです。

🔮これからどうなる

ユーザーは、SDXLの強力な生成能力を維持しつつ、より少ない計算リソースで、望み通りの画像を生成できるようになります。

T2I-Adaptersは、ControlNetと同様の機能を提供しますが、より軽量で、SDXLの既存のモデル構造に簡単に統合できます。
これにより、特定のスタイルや構図を維持しながら、多様な画像を生成する際の柔軟性が向上します。
Hugging Faceは、この技術をオープンソースとして提供しており、研究者や開発者が自由に利用・改善できます。
Hugging Face Blog ★4 画像生成 EN

SD-SmallとSD-Tinyの知識蒸留コードと重みをオープンソース化

要約を読む要約を閉じる
📰ニュース

Hugging FaceがSD-SmallとSD-Tinyの知識蒸留コードと重みを公開しました。

🔍注目ポイント

大規模モデルの性能を維持しつつ、より小型で高速な画像生成モデルを実現する技術です。

🔮これからどうなる

リソースが限られた環境でも高品質な画像生成が可能になり、開発の敷居が下がります。

知識蒸留は、大規模な教師モデルの知識を小さな生徒モデルに転移させる手法です。
これにより、モデルサイズを大幅に削減しながら、元のモデルに近い性能を維持できます。
SD-SmallとSD-Tinyは、Stable Diffusionの小型版であり、推論速度の向上とメモリ使用量の削減が期待されます。
Hugging Face Blog ★4 画像生成 EN

MacでStable Diffusion XLをCore MLの高度な量子化で高速化

要約を読む要約を閉じる
📰ニュース

Mac上でStable Diffusion XL (SDXL) をCore MLと高度な量子化技術を用いて高速に動作させる方法が発表されました。

🔍注目ポイント

Core MLの量子化技術を応用し、SDXLのモデルサイズと推論速度を最適化。MacのNeural Engineを最大限活用します。

🔮これからどうなる

Macユーザーは、高性能な画像生成AIであるSDXLを、より高速かつ効率的にローカル環境で利用できるようになります。

Hugging Faceが開発したこの技術は、SDXLのモデルをCore ML形式に変換し、さらに8ビットおよび4ビットの量子化を適用することで、ファイルサイズを大幅に削減しつつ、推論速度を向上させます。
これにより、MacBook AirのようなデバイスでもSDXLを実用的な速度で実行可能です。
Hugging Face Blog ★4 画像生成 EN

Diffusers 1周年おめでとう!

要約を読む要約を閉じる
📰ニュース

Hugging FaceのDiffusersライブラリが1周年を迎えました。

🔍注目ポイント

拡散モデルを簡単に扱えるオープンソースライブラリとして、画像生成AIの普及に貢献しました。

🔮これからどうなる

研究者や開発者が拡散モデルをより手軽に利用し、新たなAIアプリケーション開発を加速させます。

Diffusersは、Stable Diffusionなどの主要な拡散モデルをサポートし、少ないコードでモデルのロードや推論、学習が可能です。
コミュニティの貢献により、多くのモデルや機能が追加され、画像生成AIの民主化を推進しています。
Hugging Face Blog ★4 画像生成 EN

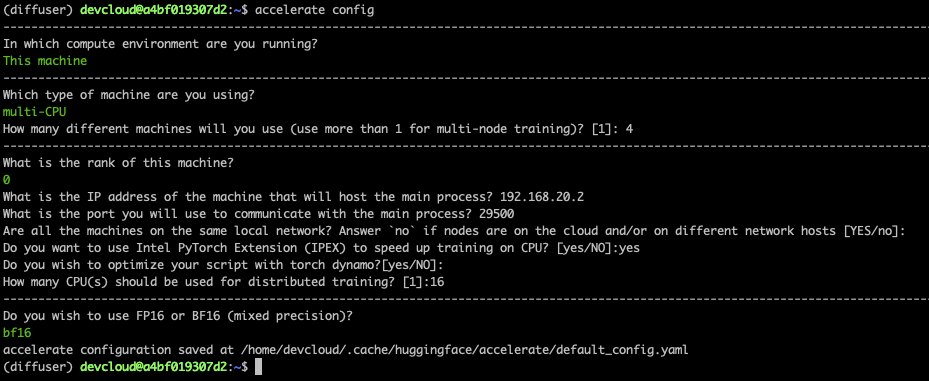
Intel CPU上でのStable Diffusionモデルのファインチューニング

要約を読む要約を閉じる
📰ニュース

Intel CPUでStable Diffusionモデルを効率的にファインチューニングする手法が公開されました。

🔍注目ポイント

IPEXとOptimum Intelライブラリを活用し、CPUでもGPUに近い性能で学習が可能です。

🔮これからどうなる

高性能GPUがなくても、多くの人が画像生成AIのカスタマイズにアクセスしやすくなります。

Hugging FaceとIntelが協力し、Intelの最新CPU向けに最適化されたライブラリを提供。
これにより、Stable DiffusionのLoRAファインチューニングが、GPUなしでも高速かつ低コストで実行できるようになります。
特に、クラウド環境でのコスト削減や、個人でのAIモデル開発の敷居を下げる効果が期待されます。
Hugging Face Blog ★4 画像生成 EN

倫理と社会ニュースレター #4: テキストから画像へのモデルにおけるバイアス

要約を読む要約を閉じる
📰ニュース

テキストから画像を生成するAIモデルに存在するバイアスについて解説しています。

🔍注目ポイント

多様なプロンプトで生成された画像から、性別や人種、職業などのステレオタイプが再現される問題が指摘されています。

🔮これからどうなる

AIモデルの利用者が意図せず差別的なコンテンツを生成するリスクがあり、社会的な公平性に影響を与えます。

Hugging Faceの倫理と社会ニュースレターの第4号で、テキストから画像へのモデルにおけるバイアスが特集されました。
モデルが学習データから既存の社会的な偏見を吸収し、特定のプロンプトに対してステレオタイプな画像を生成する傾向があることが示されています。
この問題は、AI技術の公平な利用と社会への影響を考える上で重要です。