
画像生成

228件
OpenAI Blog ★4 画像生成 EN

DALL·Eがベータ版として公開

要約を読む要約を閉じる
📰ニュース

画像生成AI「DALL·E」がベータ版として一般公開されました。

🔍注目ポイント

待機リストから100万人が招待され、無料クレジットと追加購入オプションが提供されます。

🔮これからどうなる

より多くのクリエイターや一般ユーザーがDALL·Eを利用し、画像生成AIの普及が加速します。

OpenAIは今後数週間で、待機リストに登録している100万人をDALL·Eのベータ版に招待します。
ユーザーは毎月補充される無料クレジットで画像を生成でき、さらに115世代分のクレジットを15ドルで購入することも可能です。
OpenAI Blog ★4 画像生成 EN

DALL·E 2: 創造性を拡張する

要約を読む要約を閉じる
📰ニュース

DALL·E 2の研究プレビューで、3,000人以上のアーティストが創作活動に活用。

🔍注目ポイント

DALL·E 2が多様なアーティストの創造性を広げ、新たな用途を発見している。

🔮これからどうなる

アーティストはAIツールで表現の幅を広げ、創作プロセスが変化する可能性。

OpenAIのDALL·E 2は、118カ国以上の3,000人を超えるアーティストに早期アクセスを提供。
彼らはDALL·Eを自身のクリエイティブなワークフローに組み込み、ツールの新たな活用方法を発見。
このフィードバックは、DALL·Eの機能開発における重要な意思決定に貢献している。
OpenAI Blog ★3 画像生成 EN

DALL·E 2の事前学習におけるリスク軽減策

要約を読む要約を閉じる
📰ニュース

DALL·E 2の画像生成モデルにおけるリスクを減らすための対策が講じられました。

🔍注目ポイント

コンテンツポリシー違反を防ぐための様々なガードレールを導入し、安全な利用を目指しています。

🔮これからどうなる

より多くの人がDALL·E 2を安全に利用できるようになり、悪用リスクが低減されます。

OpenAIは、強力な画像生成モデルであるDALL·E 2を広く一般に公開するにあたり、潜在的なリスクを認識していました。
そのため、生成される画像が同社のコンテンツポリシーに違反しないよう、事前学習段階で複数の緩和策を導入しました。
これにより、不適切なコンテンツの生成を防ぎ、ユーザーが安心して利用できる環境を整備しています。
OpenAI Blog ★3 画像生成 EN

DALL·E 2 研究プレビューのアップデート

要約を読む要約を閉じる
📰ニュース

DALL·E 2の早期ユーザーが300万枚以上の画像を生成し、安全性プロセスが改善されました。

🔍注目ポイント

ユーザーからのフィードバックにより、画像生成AIの安全性と倫理的な利用に関する知見が深まっています。

🔮これからどうなる

毎週最大1,000人の新規ユーザーが追加され、より多くの人がDALL·E 2を利用できるようになります。

DALL·E 2は、テキストから画像を生成するAIモデルです。
今回のアップデートは、早期アクセスユーザーからの利用状況とフィードバックに基づいて行われました。
これにより、AIの安全性向上と、より広範なユーザーへの展開が可能になります。
OpenAI Blog ★5 画像生成 EN

CLIP潜在変数を用いた階層的テキスト条件画像生成

要約を読む要約を閉じる
📰ニュース

OpenAIがテキストから画像を生成する新しいモデル「DALL-E 2」を発表しました。

🔍注目ポイント

CLIPの潜在表現を利用し、画像生成とテキスト理解を組み合わせることで、高品質な画像を生成します。

🔮これからどうなる

クリエイターやデザイナーは、テキスト入力だけで多様な画像を生成できるようになります。

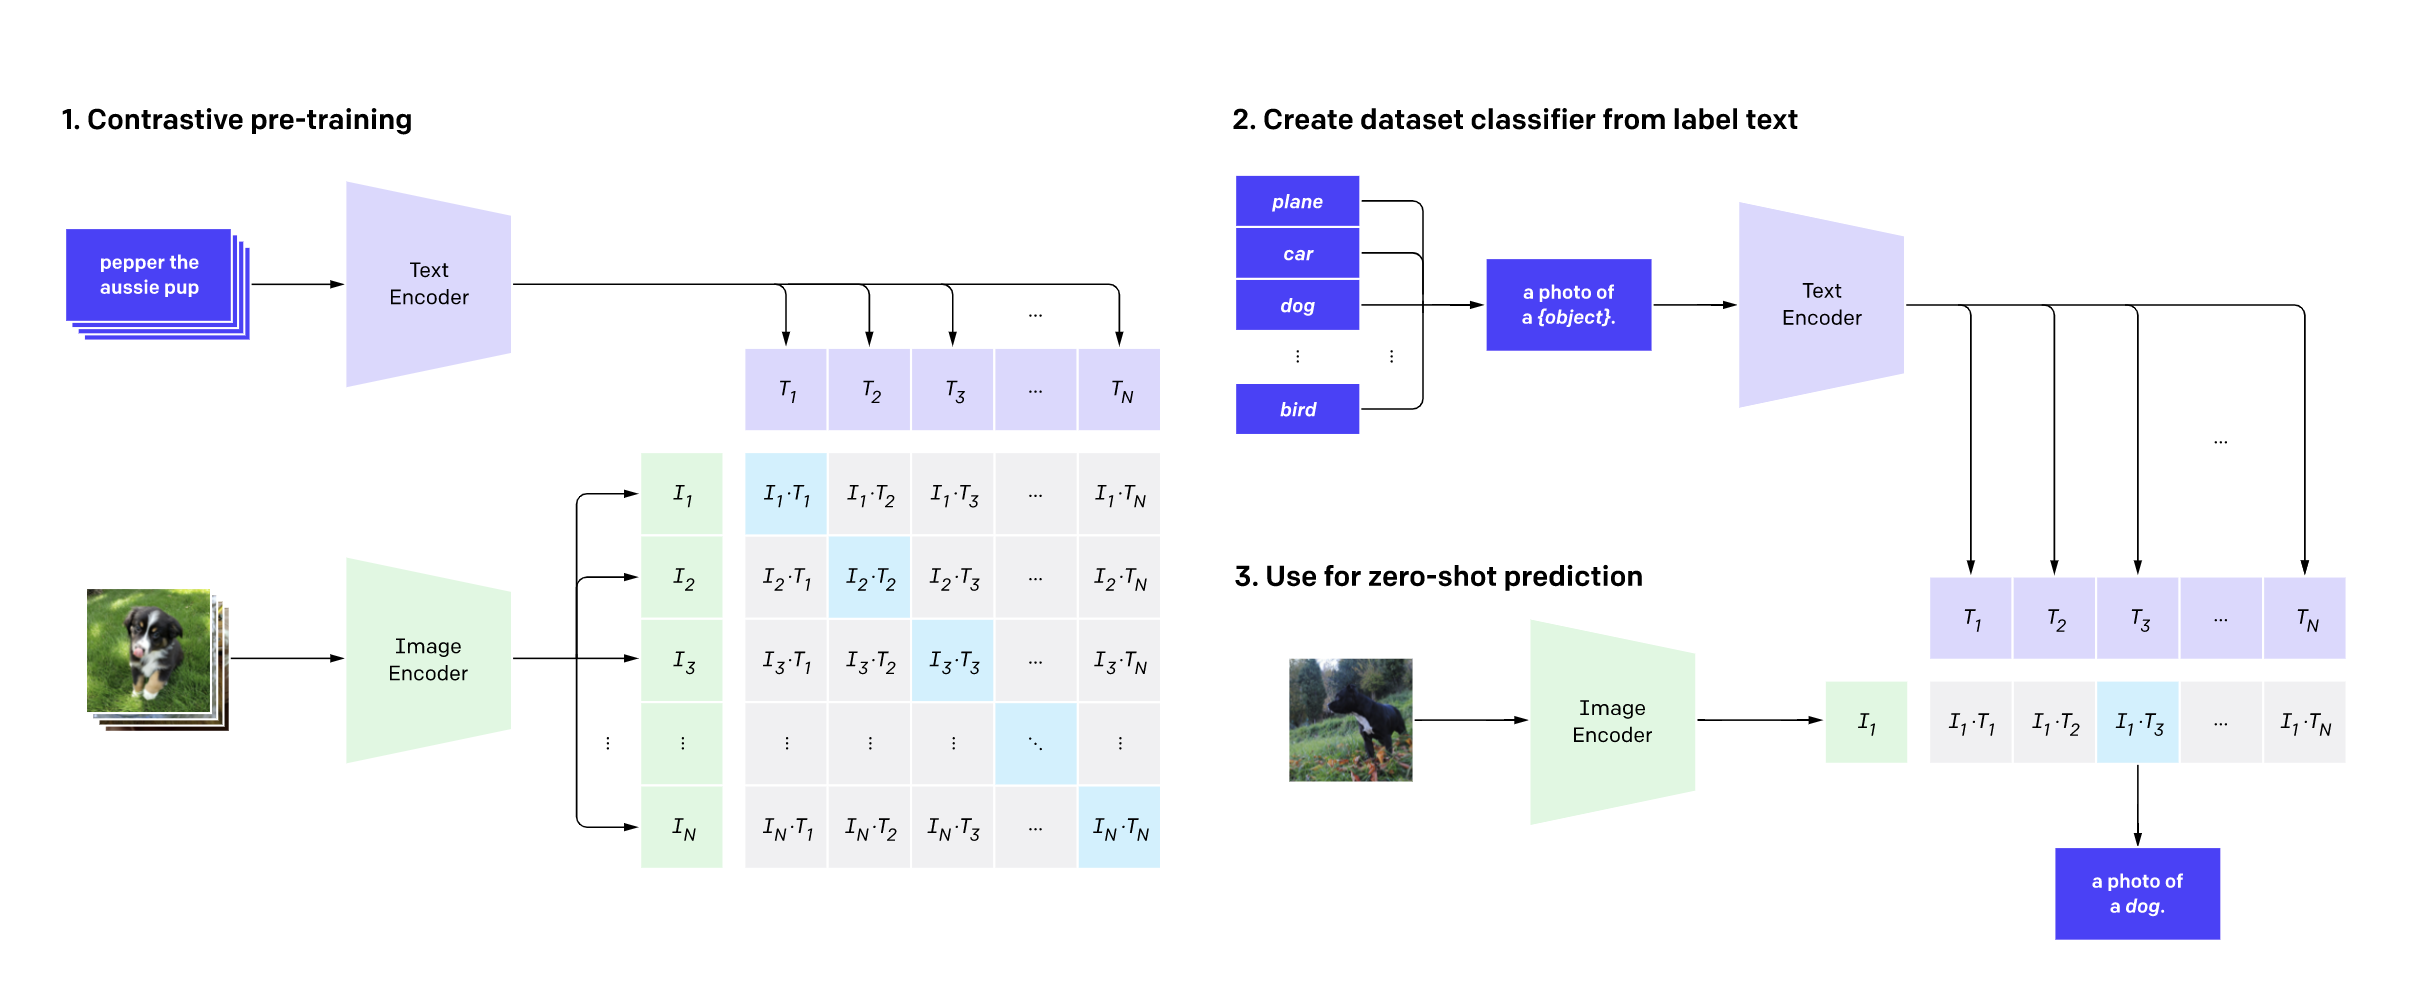
DALL-E 2は、テキスト記述からリアルな画像やアートを生成できるだけでなく、既存の画像を編集したり、バリエーションを作成したりすることも可能です。
これは、以前のDALL-Eよりも高解像度で、よりリアルな画像を生成できる点が特徴です。
Hugging Face Blog ★4 画像生成 EN

リモートセンシング(衛星)画像とキャプションを用いたCLIPのファインチューニング

要約を読む要約を閉じる
📰ニュース

リモートセンシング画像とキャプションのデータセットでCLIPモデルがファインチューニングされました。

🔍注目ポイント

衛星画像特有の視覚情報を理解し、テキストとの関連付け精度が向上した点が技術的ポイントです。

🔮これからどうなる

地球観測データの解析や災害監視など、幅広い分野でのAI活用が加速するでしょう。

Hugging Faceブログで紹介されたこの取り組みは、既存のCLIPモデルを衛星画像に特化させることで、より高精度な画像認識とテキスト検索を可能にします。
これにより、広大な地理空間データの分析が効率化され、環境モニタリングや都市計画への応用が期待されます。
OpenAI Blog ★5 画像生成 EN

DALL·E: テキストから画像を生成

要約を読む要約を閉じる
📰ニュース

OpenAIがテキストキャプションから画像を生成するニューラルネットワーク「DALL·E」を発表しました。

🔍注目ポイント

自然言語で表現できる幅広い概念を画像として具現化できる点が画期的な技術です。

🔮これからどうなる

クリエイターやデザイナーがアイデアを視覚化するプロセスを劇的に変える可能性があります。

DALL·Eは、テキストの記述に基づいて、現実世界に存在するオブジェクトだけでなく、架空の概念や組み合わせも画像として生成できます。
これにより、テキストから画像を生成するAIの可能性を大きく広げました。
OpenAI Blog ★4 画像生成 EN

Image GPT

要約を読む要約を閉じる
📰ニュース

OpenAIが言語モデルと同じTransformerで画像を生成・補完できることを発見しました。

🔍注目ポイント

大規模Transformerモデルがピクセルシーケンス学習で、言語モデル同様に一貫した画像を生成できる点です。

🔮これからどうなる

教師なし学習で画像認識の高性能な特徴抽出が可能になり、様々な画像AI開発に貢献します。

言語モデルと同じTransformerアーキテクチャを画像ピクセルシーケンスに適用することで、自然な画像生成や補完を実現しました。
生成品質と画像分類精度に相関があることを示し、最良の生成モデルが教師なし設定でトップの畳み込みネットワークに匹敵する特徴を持つことを証明しています。
OpenAI Blog ★4 画像生成 EN

Glow: より優れた可逆生成モデル

要約を読む要約を閉じる
📰ニュース

OpenAIが可逆1x1畳み込みを用いた新しい生成モデル「Glow」を発表しました。

🔍注目ポイント

可逆な1x1畳み込みにより、高解像度画像の生成と効率的なサンプリングを可能にしました。

🔮これからどうなる

データ属性の操作や、よりリアルな画像生成技術の発展に貢献するでしょう。

Glowは、既存の可逆生成モデルを拡張し、アーキテクチャを簡素化しています。
これにより、高解像度でリアルな画像を生成できるだけでなく、効率的なサンプリングもサポートします。
また、データの属性を操作できる特徴を発見することも可能です。
OpenAIはモデルのコードとオンライン可視化ツールを公開しています。
OpenAI Blog ★4 画像生成 EN

最適輸送を用いてGANを改善

要約を読む要約を閉じる
📰ニュース

OpenAIが最適輸送理論を応用し、GANの画像生成品質と安定性を大幅に向上させる新手法を発表しました。

🔍注目ポイント

従来のGANの課題だったモード崩壊や訓練不安定性を、最適輸送の概念でデータ分布間の距離を正確に測ることで解決しました。

🔮これからどうなる

より高品質で多様な画像を生成できるようになり、クリエイティブ産業やデータ拡張など幅広い分野に恩恵をもたらします。

GANは敵対的学習によってリアルな画像を生成しますが、学習が不安定で多様な画像を生成しにくいという問題がありました。
OpenAIは、データ分布間の最適な変換方法を示す「最適輸送」の考え方をGANに導入。
これにより、生成器と識別器の学習を安定させ、より多様で高品質な画像生成を実現しました。
OpenAI Blog ★4 画像生成 EN

PixelCNN++: 離散ロジスティック混合尤度とその他の改良によるPixelCNNの改善

要約を読む要約を閉じる
📰ニュース

PixelCNN++は、PixelCNNを改良し、画像生成の質を向上させたモデルです。

🔍注目ポイント

離散ロジスティック混合尤度と条件付き畳み込みを導入し、生成画像のシャープさと多様性を高めました。

🔮これからどうなる

より高品質な画像生成が可能になり、画像圧縮や超解像度化など幅広い応用が期待されます。

PixelCNNは、ピクセル単位で画像を生成する自己回帰モデルですが、生成される画像がぼやけやすいという課題がありました。
PixelCNN++は、この課題を解決するため、ピクセル値を離散的なロジスティック分布の混合で表現する手法と、条件付き畳み込み層を導入しました。
これにより、よりシャープでリアルな画像を生成できるようになりました。
OpenAI Blog ★4 画像生成 EN

変分損失オートエンコーダ

要約を読む要約を閉じる
📰ニュース

OpenAIが、データ圧縮と生成を両立する新しいモデル「変分損失オートエンコーダ(VLAE)」を発表しました。

🔍注目ポイント

従来のVAEの課題だった「圧縮効率」と「再構築品質」のトレードオフを改善し、より高精度なデータ表現を実現しています。

🔮これからどうなる

高画質画像や複雑なデータの効率的な保存・生成が可能になり、AIモデルの学習データ準備やコンテンツ生成に役立ちます。

VLAEは、情報理論に基づき、データ圧縮と再構築のバランスを最適化する新しい損失関数を導入しています。
これにより、従来のVAEよりも少ない情報量で元のデータを忠実に再現できるようになりました。
特に高解像度画像や動画など、情報量の多いデータの扱いに強みを発揮します。