画像生成

228件
GIGAZINE ★3 画像生成

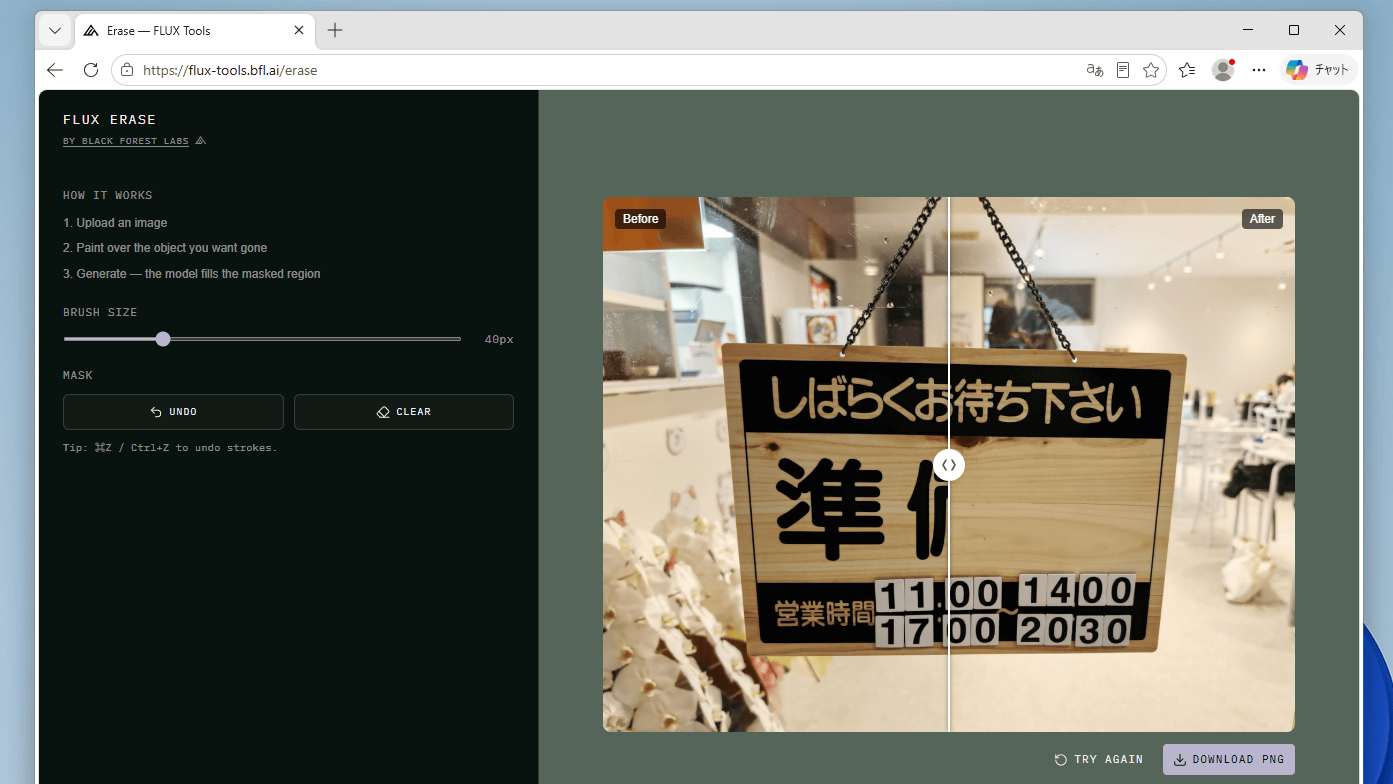
画像生成AI「FLUX」の開発元が不要物削除ツール「Erase」を発表、無料で使えるデモアプリもあり

要約を読む要約を閉じる
📰ニュース

画像生成AI「FLUX」開発元が、画像内の不要物を削除するAIツール「Erase」を発表しました。

🔍注目ポイント

高度な画像生成技術を持つ開発元が、無料で利用可能なデモアプリを通じて高精度な不要物削除機能を提供します。

🔮これからどうなる

写真編集の専門知識がない一般ユーザーでも、手軽に高品質な画像修正が可能になり、日常のSNS投稿などがより魅力的になります。

Black Forest Labsは、高性能な画像生成AI「FLUX」で知られており、その技術を応用して「Erase」を開発しました。
このツールは、画像内のオブジェクトを自然に除去し、背景と馴染ませることで、まるで最初から存在しなかったかのような仕上がりを実現します。
無料で試せるデモアプリが提供されているため、誰もがその性能を体験できます。
GIGAZINE ★3 画像生成

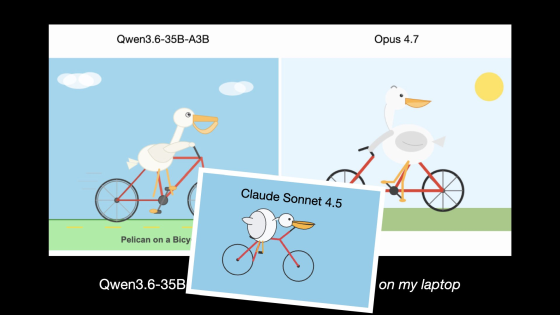
AIベンチマーク「自転車に乗ったペリカンを描く」をGemini 3.1 ProやQwen3.6-35B-A3Bにやってもらうとこうなる

要約を読む要約を閉じる
📰ニュース

AIベンチマークとして「自転車に乗ったペリカンを描く」テスト結果が公開されました。

🔍注目ポイント

Gemini 3.1 ProやQwen3.6-35B-A3Bなど複数のAIモデルで画像生成能力を比較評価しています。

🔮これからどうなる

AIモデルの画像生成能力の進化度合いをユニークな視点から把握できるようになります。

ソフトウェア開発者のサイモン・ウィリソン氏が考案したこのベンチマークは、PyCon US 2026のライトニングトークで発表されました。
複雑な指示に対するAIの理解度と創造性を測ることを目的としており、従来のベンチマークとは異なるアプローチでAIの性能を評価しています。
The Verge AI ★3 画像生成 EN

GoogleがAI画像編集の課題解決を目指す新アプリ「Pics」を発表

要約を読む要約を閉じる
📰ニュース

GoogleがWorkspace向けに、AI画像生成と編集を効率化する新アプリ「Pics」をリリースしました。

🔍注目ポイント

Picsは、画像の一部変更時にプロンプト全体を書き直す手間を省く新機能を搭載しています。

🔮これからどうなる

ユーザーはAI画像編集の反復作業を大幅に効率化でき、より直感的な画像作成が可能になります。

Google Picsは、AIで生成された画像の微調整を容易にすることを目的としています。
従来のAI画像編集では、わずかな変更でもプロンプト全体を再入力する必要がありましたが、Picsではクリック操作で特定の要素を修正できるようになります。
これにより、クリエイティブな作業の生産性向上が期待されます。
GIGAZINE ★4 画像生成

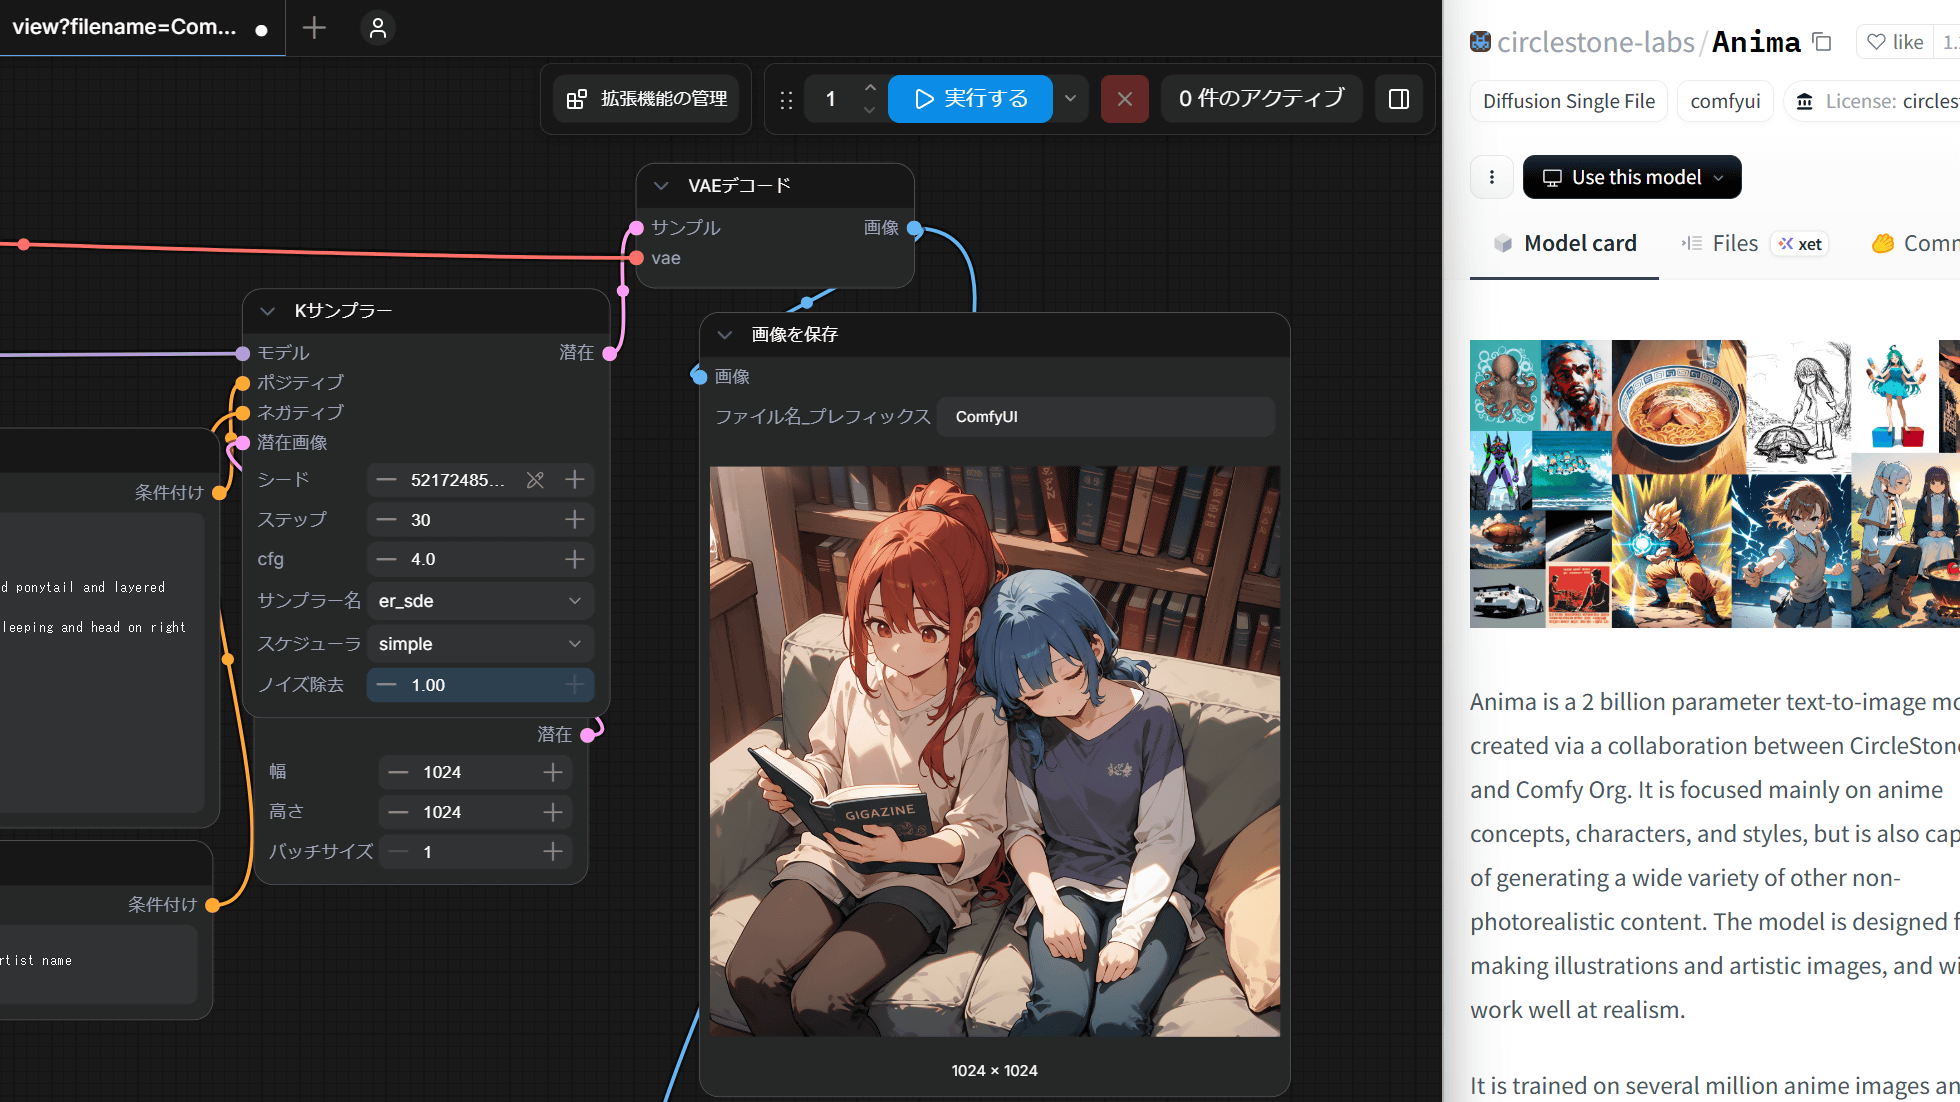
アニメ・イラストに強い画像生成AI「Anima」の正式版がついに登場、タグ・自然言語両対応でSDXLやIllustrious系モデルが動作するPCなら余裕でローカル実行可能

要約を読む要約を閉じる
📰ニュース

アニメ・イラストに特化した画像生成AI「Anima」の正式版が公開されました。

🔍注目ポイント

タグと自然言語の両方に対応し、高いプロンプト追従性で高品質な画像を生成できます。

🔮これからどうなる

イラストレーターやクリエイターは、より意図通りのアニメ・イラストを効率的に作成できるようになります。

CircleStone Labsが2026年5月15日に「Anima-Base」を公開しました。
プレビュー版からプロンプト追従性の高さが評価されており、SDXLやIllustrious系モデルが動作するPCであればローカル実行が可能です。
ComfyUIでの利用手順やプロンプトのコツも公開されています。
GIGAZINE ★3 画像生成

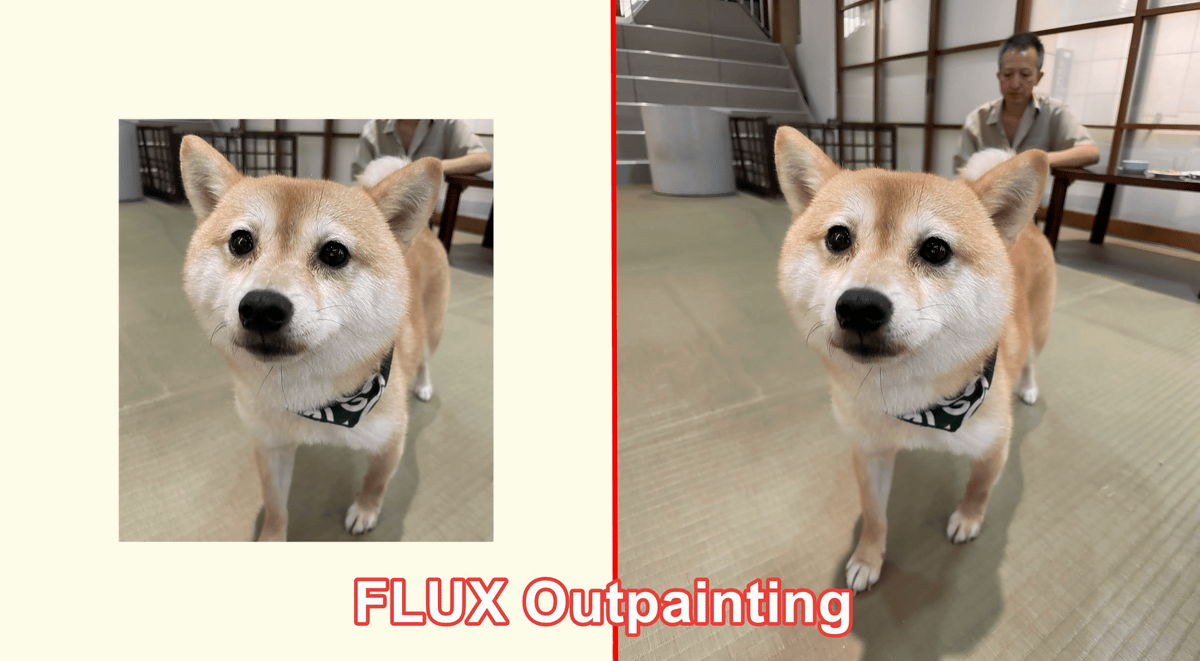
画像生成AI「FLUX.2」によるアウトペインティングに特化した「FLUX Outpainting」が登場、実際に試してみた

要約を読む要約を閉じる
📰ニュース

画像生成AI「FLUX.2」を活用したアウトペインティング特化ツール「FLUX Outpainting」が登場しました。

🔍注目ポイント

FLUX Outpaintingは、既存画像の外部を自然に描き足し拡張するアウトペインティング機能をAPI経由で提供します。

🔮これからどうなる

クリエイターは、既存の画像をより広範囲に拡張し、新たな構図や表現を容易に生み出せるようになります。

Black Forest Labsが開発したFLUX Outpaintingは、同社の画像生成AI「FLUX.2」の技術を応用しています。
これにより、ユーザーはAPIを通じてプログラム的にアウトペインティング機能を利用でき、ワークフローへの組み込みが容易になります。
GIGAZINEでは実際に試用し、その性能を検証しています。
The Decoder ★4 画像生成 EN

アリババのQwen-Image-2.0、圧縮率を倍増させ生成ステップを40から4に削減

要約を読む要約を閉じる
📰ニュース

アリババが画像モデルQwen-Image-2.0を発表し、画像圧縮率を倍増させ、生成ステップを大幅に削減しました。

🔍注目ポイント

独自のトランスフォーマーで学習を安定させ、自動プロンプト拡張モジュールを搭載し、生成ステップを40から4に短縮しました。

🔮これからどうなる

より高速かつ効率的な画像生成が可能になり、ユーザーは少ない入力で高品質な画像を生成できるようになります。

Qwen-Image-2.0は、競合モデルの2倍の圧縮率を実現し、学習安定化のためにトランスフォーマーを再設計しました。
また、短いユーザー入力を詳細なプロンプトに自動拡張する専用モジュールを備えています。
蒸留版では、画像生成に必要なノイズ除去ステップが40から4に削減されました。
The Decoder ★4 画像生成 EN

Luma、Uni-1.1画像モデルAPIを公開、OpenAIやGoogleに匹敵する価格と品質

要約を読む要約を閉じる
📰ニュース

Lumaが画像生成モデル「Uni-1.1」のAPIを公開し、OpenAIやGoogleと競合する価格と品質を提供します。

🔍注目ポイント

Uni-1.1は2048ピクセル解像度で1画像あたり0.04ドルから利用可能で、画像生成の品質で主要モデルに迫ります。

🔮これからどうなる

開発者は高品質な画像生成機能を低コストでアプリケーションに組み込めるようになり、クリエイティブな表現が広がります。

LumaのUni-1.1は、画像生成モデルの評価指標であるArenaリーダーボードでGoogleとOpenAIに次ぐ3位にランクインしています。
APIにはウェブ検索、推論機能、最大9枚の参照画像サポートが含まれており、多様な用途に対応可能です。
arXiv cs.AI ★4 画像生成 EN

DDIMがDDPMより幻覚を起こしやすい理由:逆ダイナミクスの理論的分析

要約を読む要約を閉じる
📰ニュース

DDIMがDDPMよりも幻覚(ハルシネーション)を起こしやすい原因を理論的に解明しました。

🔍注目ポイント

DDIMの逆ODEが特定の条件下でモード間の領域に停滞し、DDPMの確率性がこの停滞を回避すると証明しました。

🔮これからどうなる

拡散モデルの画像生成品質向上に繋がり、よりリアルで正確な画像生成が可能になるでしょう。

本研究は、DDPMとDDIMという2つの主要な拡散サンプラーにおける幻覚現象を、ガウス混合モデルを対象に逆ODEとSDEを分析することで理論的に解明しました。
DDIMが特定の臨界時間以降に最も近い2つのモードを結ぶセグメントに停滞するのに対し、DDPMの確率性がこの領域からの脱出を助け、幻覚を回避することを示しています。
この知見に基づき、DDIMに確率的ステップを追加することで幻覚を回避できる可能性も示唆しています。
arXiv cs.AI ★4 LLM EN

Qwen3-VL-Seg: 視覚言語グラウンディングでオープンワールド参照セグメンテーションを実現

要約を読む要約を閉じる
📰ニュース

Qwen3-VL-Segは、言語指示に基づいて画像内の特定の領域をピクセルレベルで高精度にセグメンテーションする新しいフレームワークです。

🔍注目ポイント

MLLMの予測するバウンディングボックスを構造的事前情報として活用し、軽量なマスクデコーダーでピクセルレベルのセグメンテーションを実現します。

🔮これからどうなる

ユーザーはより自然な言葉で画像内の複雑なオブジェクトを正確に選択・編集できるようになり、画像編集やAR/VR体験が向上します。

既存のMLLMはバウンディングボックス止まりで、ピクセルレベルのセグメンテーションには不十分でした。
Qwen3-VL-Segは、わずか17Mの追加パラメータで、多段階の空間特徴注入やボックスガイドによるピクセル融合を行う軽量デコーダーを導入しています。
SA1B-ORSという大規模なオープンワールドトレーニングデータセットと、ORS-Benchという評価ベンチマークも構築されました。
arXiv cs.AI ★4 画像生成 EN

人物画像アニメーションのための暗黙的選好アライメント

要約を読む要約を閉じる
📰ニュース

人物画像アニメーションにおいて、高精度な手の動きを生成する新手法「IPA」が発表されました。

🔍注目ポイント

厳密な選好ペアデータなしで、高品質な自己生成サンプルを最大化し、手の領域に特化した最適化を行います。

🔮これからどうなる

アニメーション制作のコストを大幅に削減し、より自然でリアルな人物アニメーションの生成が可能になります。

人物画像アニメーションにおける手の動きの複雑さは長年の課題でした。
従来の強化学習は厳密な選好ペアを必要としましたが、手の領域ではデータ収集が困難でした。
IPAは、この選好ペアの必要性を排除し、データ効率の高い学習フレームワークを提供します。
arXiv cs.AI ★4 画像生成 EN

APEX:画像品質評価のための仮定不要な射影ベース埋め込み検査指標

要約を読む要約を閉じる
📰ニュース

画像生成モデルの品質評価において、従来の指標の課題を解決する新しい評価フレームワーク「APEX」が発表されました。

🔍注目ポイント

APEXは、スライスワッサースタイン距離を基盤とし、仮定不要で高次元空間に拡張可能な画像品質評価手法です。

🔮これからどうなる

生成AIの画像品質をより正確に評価できるようになり、開発者はモデル改善の指針を得やすくなります。

従来の画像品質評価指標(FIDなど)は、古い特徴量やパラメトリックな仮定に制約されていました。
APEXは、CLIPやDINOv2といった最新の基盤モデルを特徴抽出器として活用し、これらの制約を克服します。
理論的・経験的証拠により、高次元空間へのスケーラビリティと視覚的劣化に対する優れた堅牢性が示されています。
arXiv cs.AI ★4 画像生成 EN

SCOPE:複雑な画像生成のための構造化分解と条件付きスキルオーケストレーション

要約を読む要約を閉じる
📰ニュース

テキストから画像を生成するモデルにおいて、複雑な意図を忠実に再現する新フレームワーク「SCOPE」が提案されました。

🔍注目ポイント

セマンティックな要件を構造化された仕様として維持し、未解決または違反した要件に対して検索、推論、修復スキルを条件付きで呼び出す点が技術的ポイントです。

🔮これからどうなる

より複雑で詳細な指示に基づいた画像を生成できるようになり、クリエイターやデザイナーの表現の幅が大きく広がります。

既存のテキスト画像生成モデルは視覚的忠実度が高いものの、複雑な意図の実現には課題がありました。
SCOPEは、生成プロセス全体でセマンティックなコミットメント(要件)を追跡し、それらを解決するためのスキルを動的に調整します。
これにより、エンティティや制約レベルの仕様を持つ新しいベンチマーク「Gen-Arena」で既存モデルを大幅に上回る性能を示しました。