LLM

6680件
Hugging Face Blog ★4 LLM EN

Hugging Faceのtransformers、accelerate、bitsandbytesを用いた大規模Transformer向け8ビット行列乗算のやさしい入門

要約を読む要約を閉じる
📰ニュース

大規模Transformerモデルのメモリ効率を大幅に向上させる8ビット行列乗算が導入されました。

🔍注目ポイント

bitsandbytesライブラリとHugging Faceのツール群を組み合わせ、モデルの精度を維持しつつメモリ使用量を削減します。

🔮これからどうなる

より多くのユーザーが限られたGPUリソースで大規模モデルを扱えるようになり、AI研究開発が加速します。

8ビット量子化は、モデルの重みを低精度で表現することでメモリ消費を抑える技術です。
Hugging Faceのtransformers、accelerateライブラリとbitsandbytesを組み合わせることで、既存のモデルを簡単に8ビット化し、推論だけでなくファインチューニングも可能になります。
これにより、RTX 3090のようなコンシューマー向けGPUでも大きなモデルを動かせるようになります。
Hugging Face Blog ★4 LLM EN

Sentence Transformersモデルの訓練とファインチューニング

要約を読む要約を閉じる
📰ニュース

Hugging FaceがSentence Transformersモデルの訓練とファインチューニングに関するガイドを公開しました。

🔍注目ポイント

事前学習済みモデルを特定のタスクやデータセットに合わせて効率的に調整する手法が解説されています。

🔮これからどうなる

開発者はより高性能な埋め込みモデルを簡単に作成・利用できるようになります。

Sentence Transformersは、文や段落を意味的に類似したベクトル空間にマッピングするモデルです。
このガイドでは、Hugging Face TransformersライブラリとDatasetsライブラリを活用し、カスタムデータセットでモデルを訓練・ファインチューニングする具体的な手順が示されています。
これにより、検索、クラスタリング、意味的類似度計算などのタスクで高い性能を発揮するモデルを構築できます。
Hugging Face Blog ★4 LLM EN

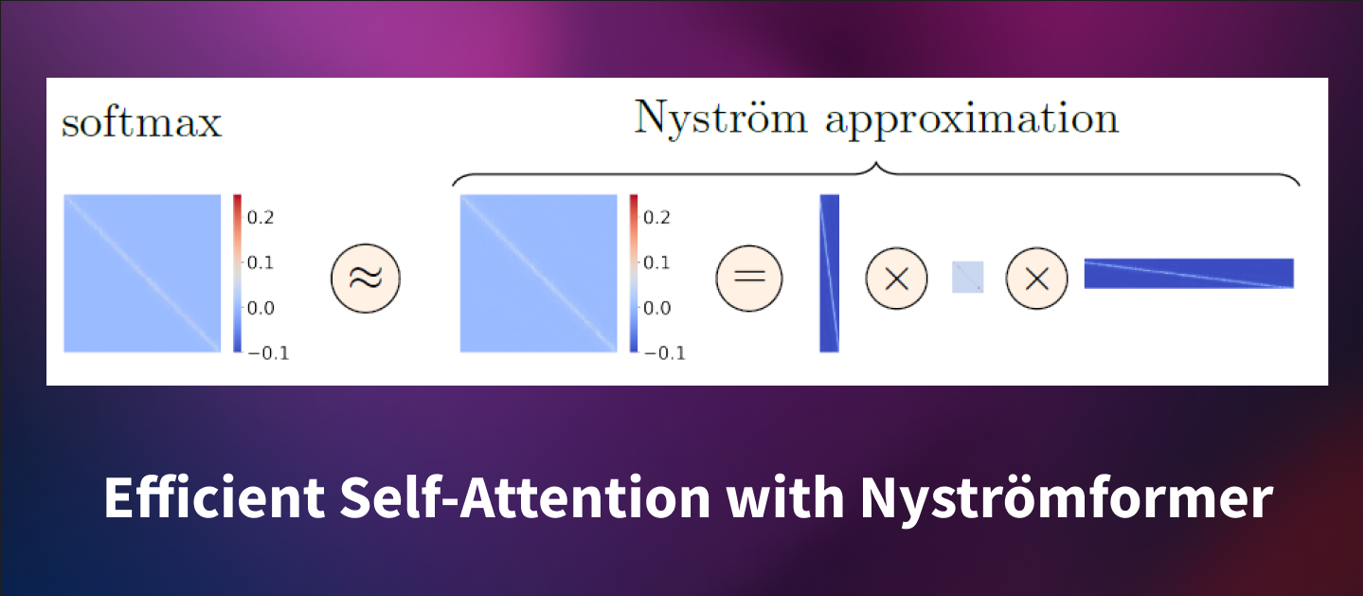
Nyströmformer: Nyström法による線形時間・メモリでの自己注意近似

要約を読む要約を閉じる
📰ニュース

Transformerの自己注意メカニズムをNyström法で近似し、計算量とメモリ使用量を線形に削減しました。

🔍注目ポイント

Nyström法を用いることで、二次関数的に増加する自己注意の計算コストを大幅に効率化しています。

🔮これからどうなる

大規模なTransformerモデルの学習や推論がより高速かつ低コストになり、利用が拡大するでしょう。

Transformerモデルは自然言語処理分野で大きな成功を収めていますが、その核となる自己注意メカニズムは入力シーケンス長に対して計算量が二次関数的に増加するという課題がありました。
Nyströmformerは、Nyström法という数学的手法を用いて、この自己注意の計算を線形時間・線形メモリに近似することで、効率的なモデルを実現しています。
OpenAI Blog ★4 LLM EN

言語モデルの「穴埋め」効率的なトレーニング

要約を読む要約を閉じる
📰ニュース

OpenAIが、テキストの途中の欠落部分を埋める言語モデルの効率的なトレーニング手法を発表しました。

🔍注目ポイント

テキストの途中を埋める「インフィル」タスクにおいて、従来の左から右への生成モデルよりも効率的な学習を実現しました。

🔮これからどうなる

コード補完や文章校正など、既存のテキストを編集・補完するAIツールの性能向上に貢献するでしょう。

この手法は、テキストの欠落部分を予測する際に、前後の文脈をより効果的に利用できるようにモデルを訓練します。
これにより、従来のモデルに比べて少ない計算リソースで高い精度を達成できる可能性があります。
特に、プログラミングにおけるコードの自動補完や、執筆における文章の推敲支援など、具体的な応用が期待されます。
Hugging Face Blog ★4 LLM EN

TensorFlowとXLAによる高速なテキスト生成

要約を読む要約を閉じる
📰ニュース

TensorFlowとXLAを組み合わせることで、テキスト生成の速度が大幅に向上しました。

🔍注目ポイント

XLAのコンパイルとTensorFlowの効率的なオペレーションにより、推論速度が最大4倍に向上した点が技術的ポイントです。

🔮これからどうなる

開発者はより高速なAIアプリケーションを構築でき、ユーザーは応答性の高いサービスを体験できるようになります。

Hugging Faceは、TensorFlowモデルのテキスト生成において、XLA (Accelerated Linear Algebra) を活用することで、特にバッチサイズが小さい場合に推論速度が劇的に改善されることを発見しました。
これは、XLAが計算グラフを最適化し、GPUなどのハードウェアに特化したコードを生成するためです。
これにより、リアルタイム性が求められるアプリケーションでのAI利用がさらに加速します。
OpenAI Blog ★4 LLM EN

コード合成大規模言語モデルのためのハザード分析フレームワーク

要約を読む要約を閉じる
📰ニュース

OpenAIがコード合成LLMの潜在的な危険性を評価するハザード分析フレームワークを公開しました。

🔍注目ポイント

このフレームワークは、LLMが生成するコードのセキュリティ、プライバシー、信頼性などのリスクを体系的に特定・評価します。

🔮これからどうなる

開発者はより安全なコード生成AIを構築でき、ユーザーはAI生成コードの信頼性を高めることができます。

OpenAIは、コード合成LLMがソフトウェア開発に革命をもたらす一方で、脆弱性や悪意のあるコード生成のリスクも認識しています。
このフレームワークは、これらのリスクを事前に特定し、軽減策を講じるためのガイドラインを提供します。
具体的には、誤ったコード、脆弱なコード、悪意のあるコードの生成といったシナリオを分析対象とします。
Hugging Face Blog ★4 LLM EN

Advantage Actor Critic (A2C)

要約を読む要約を閉じる
📰ニュース

強化学習アルゴリズムであるA2Cは、Actor-Critic手法を効率化したものです。

🔍注目ポイント

複数のエージェントが並行して経験を収集し、学習を安定化・高速化する点が特徴です。

🔮これからどうなる

複雑な環境でのAIの学習効率が向上し、より高性能なAI開発に貢献します。

A2Cは、Actor(行動選択)とCritic(価値評価)の2つのネットワークを持つActor-Criticフレームワークに基づいています。
特に、同期的な並列処理を用いることで、経験の収集と勾配計算を効率的に行い、学習の安定性と速度を向上させます。
これは、非同期的なA3Cの課題を解決するアプローチとして注目されています。
Hugging Face Blog ★4 LLM EN

敵対的データを用いてモデルを動的に訓練する方法

要約を読む要約を閉じる
📰ニュース

敵対的データを使ってモデルを動的に訓練する手法が紹介されました。

🔍注目ポイント

モデルの訓練中に敵対的サンプルを生成し、それを使ってモデルをリアルタイムで強化する点が革新的です。

🔮これからどうなる

AIモデルの堅牢性が向上し、より信頼性の高いAIシステムが構築できるようになります。

この手法は、モデルが予測を誤りやすいデータを特定し、そのデータでモデルを再訓練することで、未知の攻撃に対する耐性を高めます。
特に、自然言語処理モデルの安全性向上に貢献すると期待されています。
Hugging Face Blog ★4 LLM EN

BLOOMトレーニングの裏側にある技術

要約を読む要約を閉じる
📰ニュース

大規模言語モデルBLOOMのトレーニングに使われた技術的詳細が公開されました。

🔍注目ポイント

数千個のGPUを効率的に連携させ、大規模モデルを安定して学習させるための分散学習技術が特徴です。

🔮これからどうなる

オープンソースの大規模モデル開発が加速し、研究者や開発者がより高性能なモデルを構築しやすくなります。

BLOOMは、Hugging FaceとBigScienceが共同で開発した多言語対応の1760億パラメータを持つ大規模言語モデルです。
このブログ記事では、モデル並列化、データ並列化、最適化手法など、BLOOMのトレーニングを可能にした具体的な技術的アプローチが詳細に解説されています。
特に、DeepSpeedやMegatron-LMといった既存のフレームワークをどのように活用し、カスタマイズしたかが説明されています。
Hugging Face Blog ★5 LLM EN

世界最大のオープン多言語モデル「BLOOM」を発表

要約を読む要約を閉じる
📰ニュース

Hugging Faceが世界最大のオープン多言語大規模言語モデル「BLOOM」を発表しました。

🔍注目ポイント

1760億パラメータを持ち、46の自然言語と13のプログラミング言語に対応する多言語対応が特徴です。

🔮これからどうなる

研究者や開発者が大規模言語モデルの恩恵を享受し、AI研究の透明性とアクセシビリティが向上します。

BLOOMは、Hugging FaceとBigScienceワークショップが共同で開発したモデルで、AI研究の民主化を目指しています。
モデルのトレーニングデータセットやコードも公開されており、倫理的なAI開発に貢献することが期待されています。
Hugging Face Blog ★3 LLM EN

Twitterセンチメント分析入門

要約を読む要約を閉じる
📰ニュース

Hugging FaceのTransformersライブラリと事前学習済みモデルを使って、Twitterデータのセンチメント分析を行う方法が解説されています。

🔍注目ポイント

Transformersライブラリと事前学習済みモデルを活用することで、複雑な機械学習の知識がなくても手軽にセンチメント分析を実装できる点がすごいです。

🔮これからどうなる

企業は顧客の声をリアルタイムで把握し、製品改善やマーケティング戦略に活かせるようになります。個人開発者もSNS分析ツールを簡単に作れます。

このガイドでは、Twitter APIからデータを取得し、Hugging Faceのパイプライン機能を使ってテキストの感情をポジティブ、ネガティブ、ニュートラルの3段階で分類する手順が紹介されています。
特に、BERTなどの大規模言語モデルをファインチューニングすることなく利用できる点が特徴です。
Pythonコード例も豊富で、初心者でも実践しやすい内容となっています。
Hugging Face Blog ★4 LLM EN

DeepSpeedを活用した大規模モデルトレーニングの高速化

要約を読む要約を閉じる
📰ニュース

Hugging Face AccelerateがDeepSpeedとの統合を強化し、大規模モデルのトレーニングを高速化しました。

🔍注目ポイント

DeepSpeedの最適化技術により、メモリ効率と計算速度が向上し、より大きなモデルを効率的に学習できます。

🔮これからどうなる

研究者や開発者は、リソースを抑えつつ大規模なAIモデルをより迅速に開発・実験できるようになります。

DeepSpeedはMicrosoftが開発したディープラーニング最適化ライブラリで、大規模モデルの学習におけるメモリ消費と計算コストを大幅に削減します。
Hugging Face Accelerateとの統合により、ユーザーは最小限のコード変更でDeepSpeedの恩恵を受けられるようになりました。
これにより、GPUメモリの制約を緩和し、学習時間を短縮することが可能です。