プロダクト

11865件
Hugging Face Blog ★4 LLM EN

Hugging Face HubにおけるSentence Transformers

要約を読む要約を閉じる
📰ニュース

Hugging Face HubがSentence Transformersモデルをネイティブにサポートするようになりました。

🔍注目ポイント

Sentence TransformersモデルをHubに直接アップロード・共有・利用できるようになり、MLコミュニティでの活用が促進されます。

🔮これからどうなる

開発者はSentence Transformersモデルの発見、共有、利用が容易になり、自然言語処理アプリケーション開発が加速します。

Sentence Transformersは、テキストを固定長のベクトル埋め込みに変換するモデルで、意味的類似性検索やクラスタリングに広く利用されています。
今回の統合により、Hugging Faceの豊富なツール群(Transformersライブラリ、Datasets、Spacesなど)とシームレスに連携し、モデルの管理とデプロイが簡素化されます。
Hugging Face Blog ★4 LLM EN

実践的なFew-shot学習:GPT-NeoとHugging Face Accelerated Inference API

要約を読む要約を閉じる
📰ニュース

Hugging FaceがGPT-NeoとAccelerated Inference APIを用いたFew-shot学習の実践例を紹介しました。

🔍注目ポイント

少量のデータでモデルを特定のタスクに適応させるFew-shot学習の有効性を示しています。

🔮これからどうなる

開発者は少ないデータで高性能なAIモデルを構築できるようになり、開発コストが削減されます。

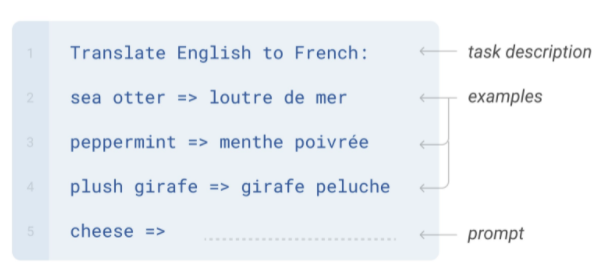
Few-shot学習は、事前学習済みモデルに少数の例を与えるだけで、新しいタスクを学習させる手法です。
Hugging FaceのAccelerated Inference APIは、このFew-shot学習を効率的に実行するためのインフラを提供し、GPT-Neoのような大規模言語モデルの活用を容易にします。
これにより、特定のドメインに特化したAIアプリケーションの開発が加速されます。
Hugging Face Blog ★3 研究 EN

Hugging FaceモデルとGradio 2.0の活用と組み合わせ

要約を読む要約を閉じる
📰ニュース

Hugging FaceモデルをGradio 2.0で簡単に利用・組み合わせる方法が紹介されました。

🔍注目ポイント

Gradio 2.0の新しいAPIにより、複数のモデルを直感的に連携させ、複雑なデモを構築できます。

🔮これからどうなる

開発者はAIモデルのデモ作成が容易になり、研究者やユーザーはモデルの試用が加速します。

Gradio 2.0は、Hugging Faceモデルとの統合を強化し、より柔軟なUI構築を可能にしました。
特に、複数のモデルをパイプラインのように接続し、入力から出力まで一貫したデモを作成する機能が向上しています。
これにより、ユーザーは複雑なAIアプリケーションの動作を視覚的に理解しやすくなります。
Hugging Face Blog ★3 研究 EN

CPU上でのBERT推論のスケーリングアップ(パート1)

要約を読む要約を閉じる
📰ニュース

Hugging FaceがCPU上でのBERT推論を高速化する手法について解説しました。

🔍注目ポイント

推論速度を向上させるため、モデル量子化やONNX Runtimeの活用が技術的ポイントです。

🔮これからどうなる

リソースが限られた環境でも、より多くのユーザーがBERTモデルを利用できるようになります。

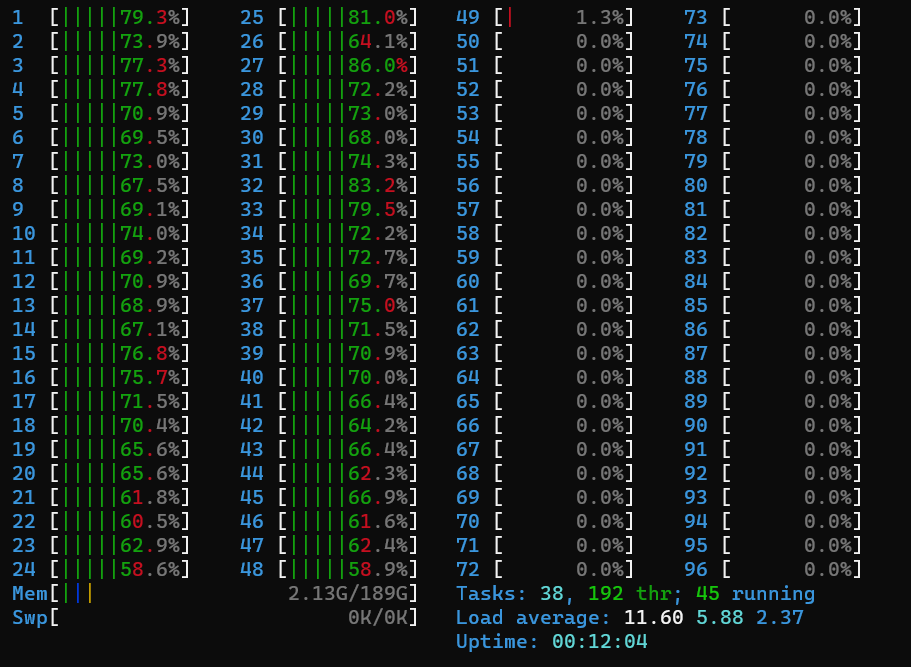
本記事は、CPU環境でのBERTモデルの推論パフォーマンスを最大化するための具体的なアプローチを紹介しています。
特に、モデルのサイズを削減する量子化技術と、推論エンジンとしてONNX Runtimeを使用することの利点に焦点を当てています。
これにより、クラウドやエッジデバイスでのAIモデルの展開がより効率的になります。
Hugging Face Blog ★4 研究 EN

🤗 Accelerateの紹介

要約を読む要約を閉じる
📰ニュース

Hugging Faceが大規模モデルの分散学習を簡素化するライブラリ「Accelerate」を発表しました。

🔍注目ポイント

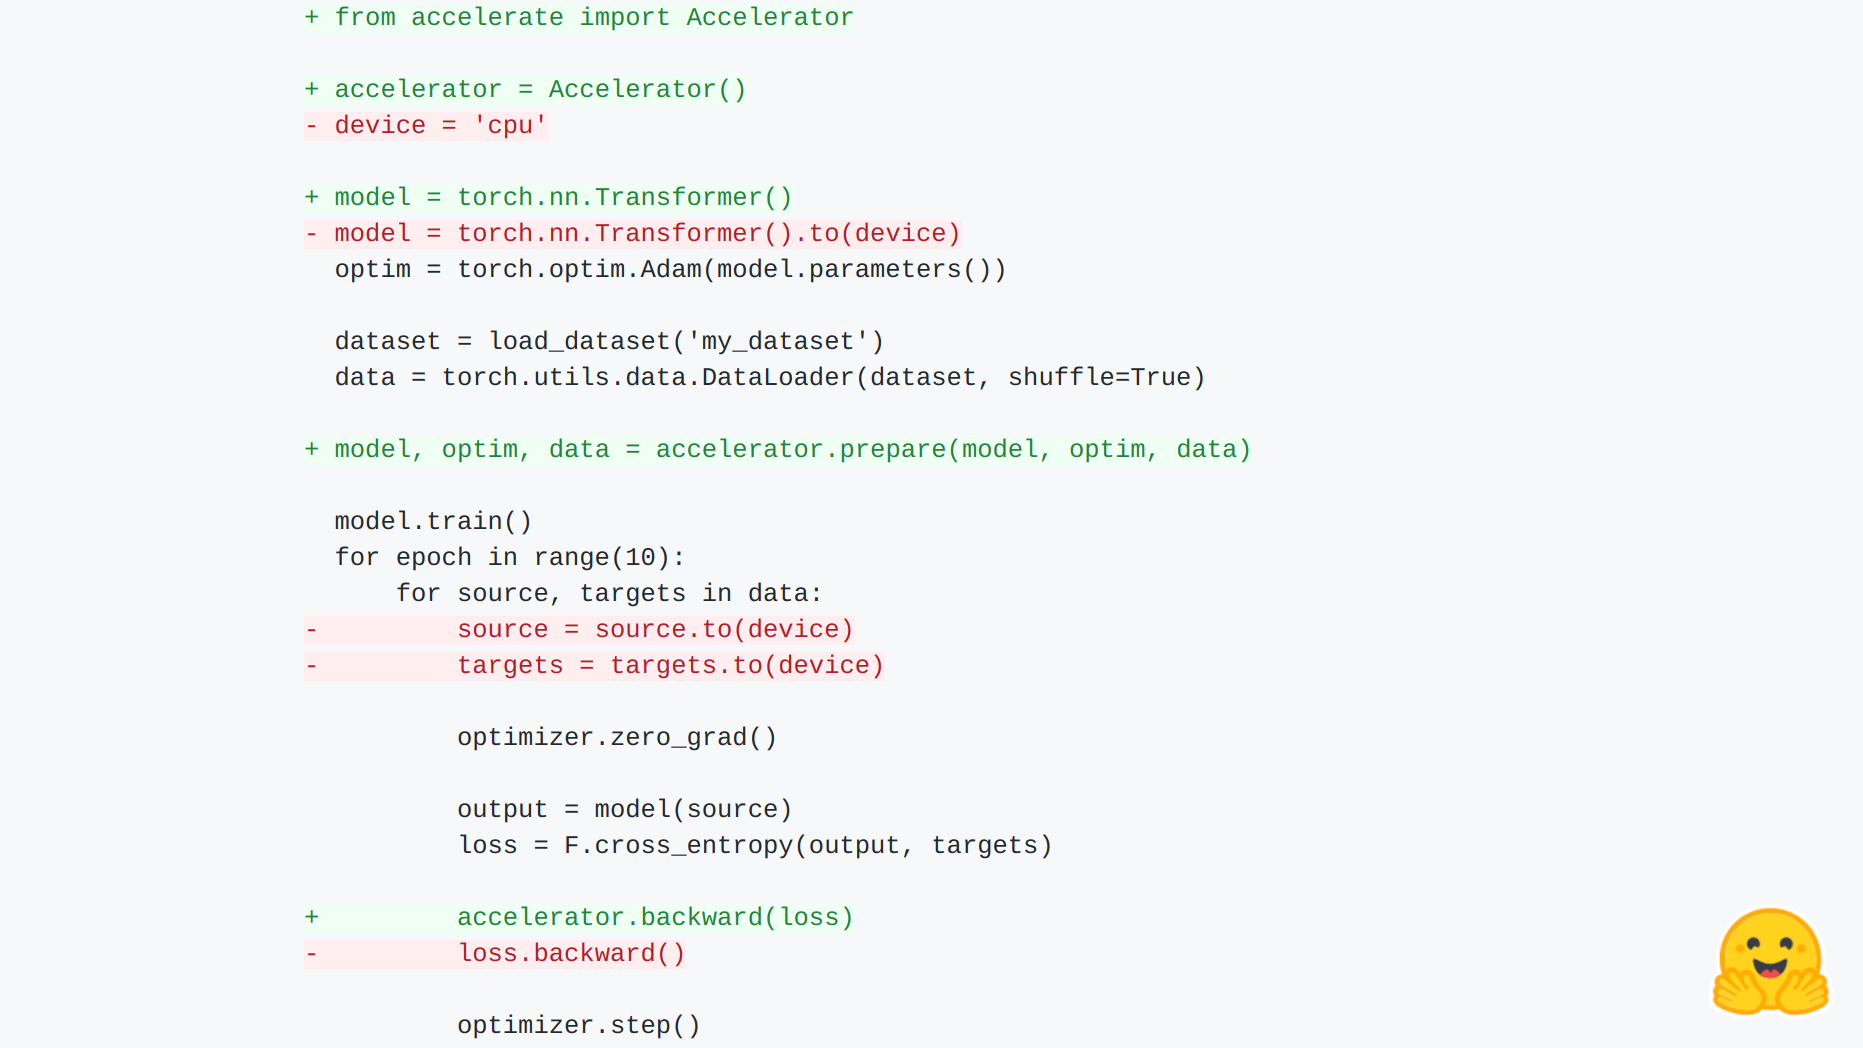
PyTorchの学習ループを最小限の変更で、様々な分散環境に対応させられるのが特徴です。

🔮これからどうなる

研究者や開発者は、インフラ設定に時間を取られず、モデル開発に集中できるようになります。

Accelerateは、PyTorchのネイティブな分散学習機能やDeepSpeed、FSDPなど、多様なバックエンドを抽象化します。
これにより、単一のスクリプトでGPU、TPU、マルチノード環境での学習が可能になり、コードの移植性が大幅に向上します。
特に大規模言語モデルや拡散モデルの学習において、複雑な分散設定の手間を省くことができます。
OpenAI Blog ★4 LLM EN

GPT-3が次世代アプリを動かす

要約を読む要約を閉じる
📰ニュース

300以上のアプリがOpenAIのAPIを通じてGPT-3を活用し、高度なAI機能を提供しています。

🔍注目ポイント

GPT-3の強力な言語生成能力が、様々なアプリに組み込まれ実用化されている点です。

🔮これからどうなる

開発者は複雑なAIモデルを自作せずとも、アプリに高度なAI機能を容易に導入できるようになります。

OpenAIのAPIを通じて、GPT-3は検索、会話、テキスト補完といった機能を提供しています。
これにより、開発者はAIの専門知識がなくても、革新的なアプリケーションを迅速に構築できるようになりました。
GPT-3の汎用性の高さが、幅広い分野での活用を可能にしています。
Hugging Face Blog ★4 LLM EN

Amazon SageMakerとHugging Faceのパートナーシップ

要約を読む要約を閉じる
📰ニュース

Amazon SageMakerとHugging Faceが提携し、機械学習モデルのデプロイを簡素化。

🔍注目ポイント

Hugging FaceのモデルをSageMaker上で簡単に利用・デプロイできる統合ソリューションを提供。

🔮これからどうなる

開発者はより迅速に最先端のAIモデルを本番環境に導入できるようになる。

この提携により、Hugging FaceのTransformerライブラリやモデルハブがSageMakerと深く統合されます。
これにより、開発者はHugging Faceの豊富なモデル資産をSageMakerの堅牢なインフラ上で効率的に活用し、スケーラブルなAIアプリケーションを構築できるようになります。
特に、大規模言語モデル(LLM)や画像生成モデルなどのデプロイが容易になります。
Hugging Face Blog ★4 LLM EN

Google Cloud上でのサーバーレスTransformerパイプライン構築記

要約を読む要約を閉じる
📰ニュース

Google Cloud上でサーバーレスなHugging Face Transformerパイプラインを構築した事例が紹介されました。

🔍注目ポイント

Cloud RunとCloud Buildを利用し、GPUなしで高速かつコスト効率の良い推論環境を実現しています。

🔮これからどうなる

企業や開発者は、大規模言語モデルのデプロイと運用をより手軽に行えるようになります。

著者は当初、GPUインスタンスでのデプロイを検討しましたが、コストと管理の複雑さからサーバーレスを選択。
Cloud Runのコンテナ起動の速さとスケーラビリティが決め手となりました。
特に、推論時にのみリソースが消費されるため、アイドル時のコストを大幅に削減できます。
Hugging Face Blog ★4 LLM EN

Hugging Faceで🤗 Transformersを使って英語ASR向けにWav2Vec2をファインチューニング

要約を読む要約を閉じる
📰ニュース

Hugging Faceが提供するWav2Vec2モデルを英語の自動音声認識(ASR)タスク向けにファインチューニングする方法が公開されました。

🔍注目ポイント

Transformersライブラリを活用し、事前学習済みWav2Vec2モデルを特定のデータセットで効率的にカスタマイズできる点が技術的ポイントです。

🔮これからどうなる

開発者は高品質な英語ASRモデルを比較的容易に構築できるようになり、音声認識技術の応用範囲が広がります。

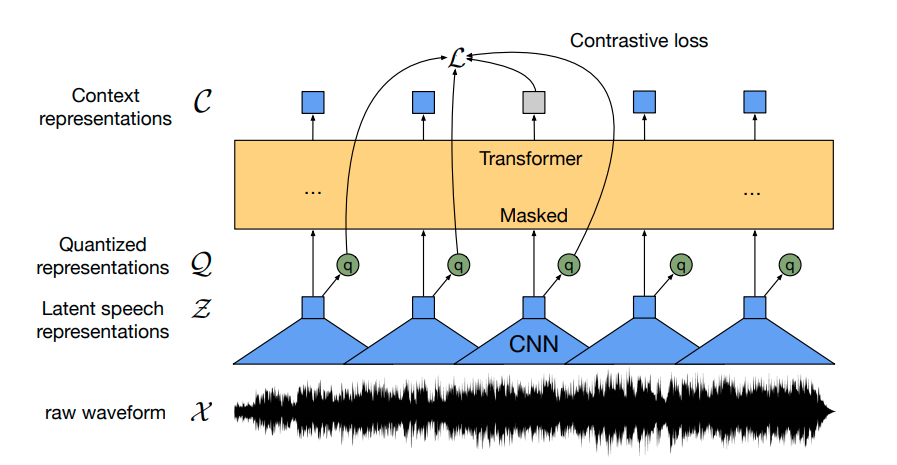
Wav2Vec2はFacebook AIが開発した自己教師あり学習モデルで、大量の音声データから特徴を学習します。
Hugging Faceは、このモデルをTransformersライブラリを通じて簡単に利用・ファインチューニングできる環境を提供しており、本記事はその具体的な手順を解説しています。
これにより、専門的な知識がなくても、特定のユースケースに合わせたASRモデルを構築することが可能になります。
Hugging Face Blog ★3 研究 EN

Hugging Face TransformersにおけるTensorFlowモデルの高速化

要約を読む要約を閉じる
📰ニュース

Hugging Face TransformersでTensorFlowモデルの推論速度が向上しました。

🔍注目ポイント

XLAコンパイルとtf.function活用でモデル実行グラフを最適化し高速化を実現。

🔮これからどうなる

TensorFlowユーザーはHugging Faceモデルをより高速に利用でき開発効率が向上。

Hugging Face TransformersはPyTorchとTensorFlow両対応だが、TFモデルの最適化が課題だった。
今回のアップデートでXLAコンパイラとtf.functionデコレータを積極的に利用し、計算グラフを事前コンパイル。
これにより、特に大規模モデルでの推論時間が大幅に短縮される。
OpenAI Blog ★4 研究 EN

Kubernetesを7,500ノードにスケール

要約を読む要約を閉じる
📰ニュース

OpenAIがKubernetesクラスターを7,500ノードに拡張することに成功しました。

🔍注目ポイント

大規模モデルの学習・推論を支える、極めて高いスケーラビリティを持つインフラを構築しました。

🔮これからどうなる

GPT-3やDALL·Eのような大規模AIモデルの開発と運用がさらに効率化されます。

このスケーリングは、GPT-3、CLIP、DALL·Eといった大規模モデルだけでなく、ニューラル言語モデルのスケーリング法則のような小規模で反復的な研究にも利用されています。
これにより、AI研究開発の効率と速度が大幅に向上することが期待されます。
Hugging Face Blog ★4 LLM EN

Hugging Face API顧客向けにTransformer推論を100倍高速化した方法

要約を読む要約を閉じる
📰ニュース

Hugging FaceがAPI顧客向けにTransformerモデルの推論速度を最大100倍高速化しました。

🔍注目ポイント

推論のバッチ処理、モデルの最適化、専用ハードウェアの活用により、大幅な高速化を実現しました。

🔮これからどうなる

API利用者はより高速で効率的なAIモデルの利用が可能になり、開発コスト削減にも繋がります。

Hugging Faceは、大規模言語モデル(LLM)などのTransformerモデルの推論を高速化するため、バッチ処理の最適化、モデルの量子化やプルーニング、さらにNVIDIA A100 GPUなどの高性能ハードウェアの導入を行いました。
これにより、特にトラフィックの多いモデルで顕著なパフォーマンス向上を達成しています。