研究

5297件
Hugging Face Blog ★4 LLM EN

Idefics2の紹介:コミュニティ向けの強力な8Bビジョン言語モデル

要約を読む要約を閉じる
📰ニュース

Hugging Faceがコミュニティ向けに強力な8Bビジョン言語モデル「Idefics2」を発表しました。

🔍注目ポイント

Idefics2は、80億パラメータで画像とテキストを同時に理解し、推論する能力を持つオープンモデルです。

🔮これからどうなる

開発者は、より高性能なマルチモーダルAIをオープンソースで利用でき、多様なアプリケーション開発が加速します。

Idefics2は、前モデルのIdefics1から大幅に改善され、より効率的なアーキテクチャと高性能なデータセットで訓練されています。
これにより、OCR、視覚的質問応答、画像キャプション生成など、幅広いタスクで優れた性能を発揮します。
商用利用も可能なApache 2.0ライセンスで提供されます。
Hugging Face Blog ★4 LLM EN

Vision Language Models (VLM) の解説

要約を読む要約を閉じる
📰ニュース

画像とテキストの両方を理解するAIモデル、Vision Language Models (VLM) の基本が解説されました。

🔍注目ポイント

VLMは、画像とテキストを統合的に処理することで、単一モダリティモデルでは不可能な高度なタスクを可能にします。

🔮これからどうなる

ユーザーは、画像とテキストを組み合わせた複雑な質問応答やコンテンツ生成がより容易になります。

VLMは、画像エンコーダとテキストエンコーダを組み合わせ、両者の情報を統合するアーキテクチャを持ちます。
これにより、画像キャプション生成、視覚的質問応答(VQA)、画像検索など、多岐にわたる応用が可能です。
Hugging Faceは、これらのモデルの理解と利用を促進しています。
OpenAI Blog ★3 AI倫理 EN

OpenAIがNTIAにオープンモデルの重みについてコメント

要約を読む要約を閉じる
📰ニュース

OpenAIが米商務省通信情報庁(NTIA)に対し、デュアルユース基盤モデルの重みの公開に関する情報提供依頼に応答しました。

🔍注目ポイント

AIモデルの重み公開がもたらす潜在的なリスクとメリットについて、OpenAIの公式見解が示されました。

🔮これからどうなる

AIモデルの安全性とオープン性のバランスに関する今後の政策議論に、OpenAIの意見が影響を与える可能性があります。

NTIAは、広範に利用可能な重みを持つデュアルユース基盤モデルに関する情報提供を求めていました。
OpenAIはこの要請に対し、モデルの重み公開がセキュリティ、悪用リスク、イノベーション促進に与える影響について、自社の立場を表明しました。
これはAI規制の議論において重要な一歩となります。
Hugging Face Blog ★4 ロボット EN

Pollen-Vision: ロボティクスにおけるゼロショットビジョンモデルの統一インターフェース

要約を読む要約を閉じる
📰ニュース

ロボットが様々な視覚タスクをゼロショットで実行できる統一インターフェース「Pollen-Vision」が開発されました。

🔍注目ポイント

異なるゼロショットビジョンモデル(SAM, DINO, CLIPなど)を単一のAPIで統合し、ロボット制御を容易にします。

🔮これからどうなる

ロボット開発者は、複雑な視覚モデルの統合なしに、より汎用的なロボットアプリケーションを迅速に構築できます。

Pollen-Visionは、Hugging FaceのTransformersライブラリに触発され、多様な視覚モデルを抽象化し、ロボットの知覚と行動を連携させます。
これにより、ロボットは未知の物体を認識し、操作する能力を向上させ、産業から家庭まで幅広い分野での応用が期待されます。
Hugging Face Blog ★3 LLM EN

Hugging Face Transformers 超初心者向け入門

要約を読む要約を閉じる
📰ニュース

Hugging Face Transformersライブラリの基本的な使い方を解説する入門記事です。

🔍注目ポイント

事前学習済みモデルを数行のコードで簡単に利用できる手軽さが特徴です。

🔮これからどうなる

AIモデル開発の敷居が下がり、より多くの人が最先端のAI技術を活用できるようになります。

Hugging Face Transformersは、自然言語処理(NLP)タスク向けの事前学習済みモデルを豊富に提供するオープンソースライブラリです。
モデルのダウンロードから推論実行まで、簡単なAPIで実現できるため、初心者でもすぐに実践できます。
本記事は、その基本的な概念とコード例を通じて、ライブラリの導入を促します。
Hugging Face Blog ★4 LLM EN

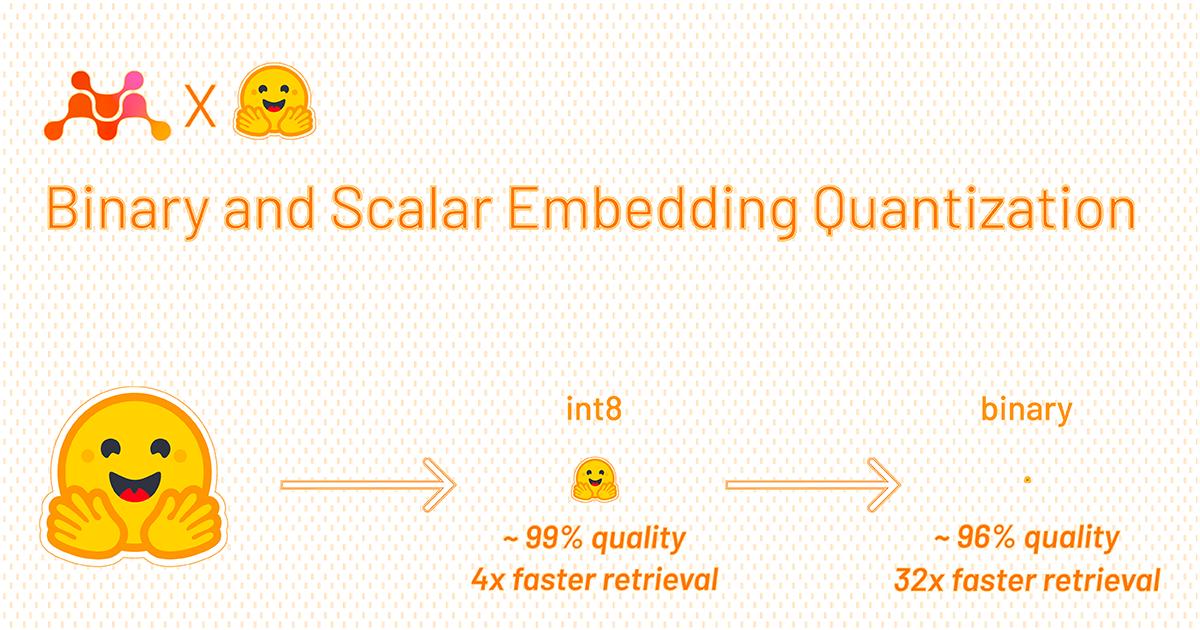
バイナリおよびスカラー埋め込み量子化による検索の大幅な高速化と低コスト化

要約を読む要約を閉じる
📰ニュース

Hugging Faceが埋め込み量子化技術を導入し、検索速度とコストを改善しました。

🔍注目ポイント

バイナリおよびスカラー量子化により、埋め込みモデルのメモリ使用量と計算量を大幅に削減します。

🔮これからどうなる

企業や開発者は、より高速かつ低コストで大規模な検索システムを構築できるようになります。

埋め込みモデルは、テキストや画像をベクトルに変換し、類似度検索に利用されます。
しかし、大規模な埋め込みはメモリと計算リソースを大量に消費します。
Hugging Faceの新しい量子化技術は、これらの埋め込みを圧縮することで、メモリ使用量を最大32倍削減し、検索速度を向上させながら、精度を維持します。
これにより、より多くのユーザーが高度な検索機能を低コストで利用できるようになります。
Hugging Face Blog ★4 LLM EN

Cosmopedia: 大規模言語モデル事前学習のための大規模合成データ作成方法

要約を読む要約を閉じる
📰ニュース

Hugging Faceが大規模言語モデル事前学習用の合成データセット「Cosmopedia」を公開しました。

🔍注目ポイント

既存の高品質データセットを基に、LLMを使って多様な形式の合成データを生成する手法を提案しています。

🔮これからどうなる

高品質な合成データが利用可能になり、LLMの事前学習コスト削減や性能向上が期待されます。

Cosmopediaは、Webデータから抽出された高品質なテキストをシードとして、Mixtral 8x7Bモデルを用いて様々なスタイルの合成データを生成します。
具体的には、ブログ記事、コード、物語、ウェブページ、会話など10種類の形式で、合計300億トークン以上のデータが含まれています。
これにより、多様なタスクに対応できる汎用性の高いLLMの開発に貢献します。
Hugging Face Blog ★4 LLM EN

GaLore: 消費者向けハードウェアでの大規模モデルトレーニングを前進させる

要約を読む要約を閉じる
📰ニュース

GaLoreは、大規模言語モデルのトレーニングに必要なメモリを大幅に削減する新しい最適化手法です。

🔍注目ポイント

勾配の低ランク射影を利用することで、フルファインチューニングに近い性能を維持しつつ、メモリ消費を劇的に抑えます。

🔮これからどうなる

個人ユーザーや中小企業でも、高性能なGPUなしで大規模モデルのトレーニングが可能になり、AI開発の民主化が進みます。

GaLoreは、勾配を低ランク行列として扱うことで、勾配の保存と更新に必要なメモリ量を削減します。
これにより、RTX 3090のような消費者向けGPUでも、Llama 2 7Bのようなモデルのファインチューニングが可能になります。
従来のLoRAなどの手法と比較しても、同等以上の性能をより少ないメモリで実現できる点が特徴です。
Hugging Face Blog ★4 研究 EN

Quanto: Optimum向けPyTorch量子化バックエンド

要約を読む要約を閉じる
📰ニュース

Hugging FaceがPyTorchモデルの量子化を効率化するライブラリ「Quanto」を発表しました。

🔍注目ポイント

PyTorchのネイティブな量子化機能を活用し、Optimumライブラリと統合することで、モデルの高速化とメモリ削減を実現します。

🔮これからどうなる

開発者は、より高速で軽量なAIモデルを簡単にデプロイできるようになり、エッジデバイスでのAI活用が加速します。

Quantoは、PyTorchのfxグラフモードと統合されており、既存のPyTorchモデルに最小限の変更で量子化を適用できます。
Optimumとの連携により、Hugging Faceエコシステム内の様々なモデルに対して、最適化された量子化戦略を適用することが可能になります。
これにより、推論速度の向上とリソース消費の削減が期待されます。
Hugging Face Blog ★4 LLM EN

🤗 Optimum IntelとfastRAGによるCPU最適化埋め込み

要約を読む要約を閉じる
📰ニュース

Hugging FaceがOptimum IntelとfastRAGを使い、CPUでの埋め込み生成を大幅に高速化しました。

🔍注目ポイント

Intel CPU向けに最適化されたモデルとライブラリを組み合わせることで、推論速度が向上しました。

🔮これからどうなる

CPU環境でも効率的にRAGシステムを構築でき、より多くの企業や開発者が利用しやすくなります。

埋め込みモデルはRAGシステムにおいて重要な要素ですが、推論には計算コストがかかります。
Optimum IntelはIntel CPUのハードウェア機能を活用し、モデルの推論を最適化します。
fastRAGはRAGパイプライン全体を高速化するライブラリで、これらを組み合わせることで、CPU環境でも高速な埋め込み生成とRAGシステム構築が可能になります。
Hugging Face Blog ★4 研究 EN

WebスクリーンショットからHTMLコードへの変換を可能にするWebSightデータセット

要約を読む要約を閉じる
📰ニュース

WebスクリーンショットをHTMLコードに変換するための新しいデータセット「WebSight」が公開されました。

🔍注目ポイント

画像からWebページの構造を理解し、再現する能力をAIに与える画期的なデータセットです。

🔮これからどうなる

Web開発の自動化やアクセシビリティ向上、ノーコードツールの進化に貢献する可能性があります。

WebSightは、スクリーンショットとそれに対応するHTMLコードのペアを大量に含んでいます。
これにより、AIモデルは視覚情報からWebページの要素やレイアウトを学習し、HTMLを生成できるようになります。
これは、デザインからコーディングへのプロセスを効率化する上で非常に重要です。
Hugging Face Blog ★4 LLM EN

ConTextualの紹介:テキストリッチなシーンでマルチモーダルモデルはテキストと画像をどれだけうまく推論できるか?

要約を読む要約を閉じる
📰ニュース

テキストが豊富な画像におけるマルチモーダルモデルの推論能力を評価する新しいベンチマーク「ConTextual」が発表されました。

🔍注目ポイント

ConTextualは、テキストと画像の両方を統合的に理解し、複雑な推論を行うモデルの性能を測定します。

🔮これからどうなる

このベンチマークにより、テキストと画像が混在する現実世界の情報をより正確に理解するAIの開発が加速します。

ConTextualは、看板、ラベル、グラフなど、テキスト情報が画像に埋め込まれた多様なシーンを対象としています。
従来のベンチマークではテキストと画像の連携推論が不十分だったため、より実用的なAIモデルの評価が可能になります。
これにより、より高度な視覚的質問応答や情報抽出タスクの改善が期待されます。