研究

5297件
Hugging Face Blog ★4 LLM EN

RWKVの紹介 - トランスフォーマーの利点を持つRNN

要約を読む要約を閉じる
📰ニュース

トランスフォーマーの利点を持ちながら、RNNの特性を併せ持つ新しいモデル「RWKV」が発表されました。

🔍注目ポイント

並列計算が可能で、推論時のメモリと計算コストがシーケンス長に依存しない点が画期的です。

🔮これからどうなる

より長いシーケンスを効率的に処理できるため、大規模言語モデルの訓練と利用が改善される可能性があります。

RWKVは、トランスフォーマーのAttentionメカニズムをRNNの再帰的な構造に統合することで、両者の長所を組み合わせたモデルです。
これにより、訓練時の並列化と推論時の効率的なメモリ利用を実現し、特に長いテキストの処理において優れた性能を発揮します。
既存のトランスフォーマーモデルと比較して、推論時の計算コストがシーケンス長に比例しないため、より大規模なモデルや長いコンテキストでの利用が期待されます。
Hugging Face Blog ★4 LLM EN

アシスト生成:低遅延テキスト生成に向けた新たな方向性

要約を読む要約を閉じる
📰ニュース

Hugging FaceがLLMのテキスト生成を高速化する「アシスト生成」という新手法を発表しました。

🔍注目ポイント

小型ドラフトモデルで次のトークン候補を予測し、大型モデルで検証することで、生成速度を大幅に向上させます。

🔮これからどうなる

ユーザーはより高速な応答を得られ、LLMのリアルタイム対話やアプリケーションのUXが向上します。

従来のLLMは生成が遅く、特に大規模モデルでは顕著でした。
アシスト生成は、小さなドラフトモデルが生成する複数のトークン候補を、大きなターゲットモデルがまとめて検証することで、生成のボトルネックを解消します。
これにより、理論的には最大4倍の高速化が期待されます。
OpenAI Blog ★4 LLM EN

言語モデルは言語モデル内のニューロンを説明できる

要約を読む要約を閉じる
📰ニュース

GPT-4が大規模言語モデル(GPT-2)のニューロンの振る舞いを自動で説明し、その説明を評価しました。

🔍注目ポイント

言語モデル自身が、他の言語モデルの内部動作を人間が理解できる形で解釈する能力を示した点が画期的です。

🔮これからどうなる

AIの「ブラックボックス」問題の解明に繋がり、より信頼性・説明性の高いAI開発を促進する可能性があります。

OpenAIは、GPT-4を用いてGPT-2の全ニューロンに対する説明文とスコアを自動生成し、データセットとして公開しました。
この手法はまだ完璧ではないものの、AIがAIを理解する第一歩となり、AIの透明性向上に貢献することが期待されます。
Hugging Face Blog ★4 LLM EN

テキストから動画生成モデルの深掘り

要約を読む要約を閉じる
📰ニュース

テキストプロンプトから動画を生成するAIモデルの進化と現状が解説されています。

🔍注目ポイント

拡散モデルを基盤とし、時間軸の整合性を保ちながら高品質な動画を生成する技術が特徴です。

🔮これからどうなる

クリエイターは動画制作の効率化、一般ユーザーは手軽にオリジナル動画を作成できるようになります。

テキストから動画を生成する技術は、画像生成モデルの成功の上に成り立っています。
特に拡散モデルが主流で、テキストを条件として動画の各フレームを生成し、時間的な一貫性を保つための工夫が凝らされています。
生成される動画の品質は向上しており、様々な応用が期待されています。
Hugging Face Blog ★4 LLM EN

StarCoder: コードに特化した最先端LLM

要約を読む要約を閉じる
📰ニュース

Hugging Faceがコード生成に特化した大規模言語モデル「StarCoder」を発表しました。

🔍注目ポイント

8000億トークン以上のコードデータで学習し、HumanEvalでGPT-3.5を上回る性能を示しています。

🔮これからどうなる

開発者はより高品質なコードを効率的に生成・補完できるようになり、生産性が向上します。

StarCoderは、GitHubの公開リポジトリから収集された8000億トークン以上のコードデータで学習された、155億パラメータを持つ大規模言語モデルです。
特にPython、Java、JavaScriptなどの主要言語において高い性能を発揮し、コード生成、コード補完、バグ修正などのタスクで利用可能です。
商用利用も可能なオープンモデルとして提供されています。
Hugging Face Blog ★4 LLM EN

TensorFlowとTPUを使った🤗 Transformersでの言語モデルトレーニング

要約を読む要約を閉じる
📰ニュース

Hugging FaceがTensorFlowとTPUを活用した言語モデルのトレーニング方法を公開しました。

🔍注目ポイント

TPUの並列処理能力をTensorFlowとTransformersで最大限に引き出す技術が紹介されています。

🔮これからどうなる

大規模モデルのトレーニングがより効率的になり、研究者や開発者の開発速度が向上します。

Hugging FaceのTransformersライブラリはPyTorchでの利用が一般的ですが、TensorFlowでも強力な機能を提供しています。
Google CloudのTPUは、特にディープラーニングのトレーニングにおいて高いパフォーマンスを発揮するアクセラレータです。
この組み合わせにより、大規模な言語モデルをより高速かつ低コストでトレーニングできるようになります。
Hugging Face Blog ★3 画像生成 EN

無料版Google Colabで🧨diffusersを使ってIFを実行する

要約を読む要約を閉じる
📰ニュース

無料版Google Colab環境で、画像生成モデルIFを🧨diffusersライブラリを用いて実行する方法が紹介されました。

🔍注目ポイント

限られたリソースの無料Colabで、通常は高負荷なIFモデルを効率的に動作させる技術的工夫がポイントです。

🔮これからどうなる

個人開発者や学生でも高性能な画像生成モデルを試せるようになり、AI活用への敷居が下がります。

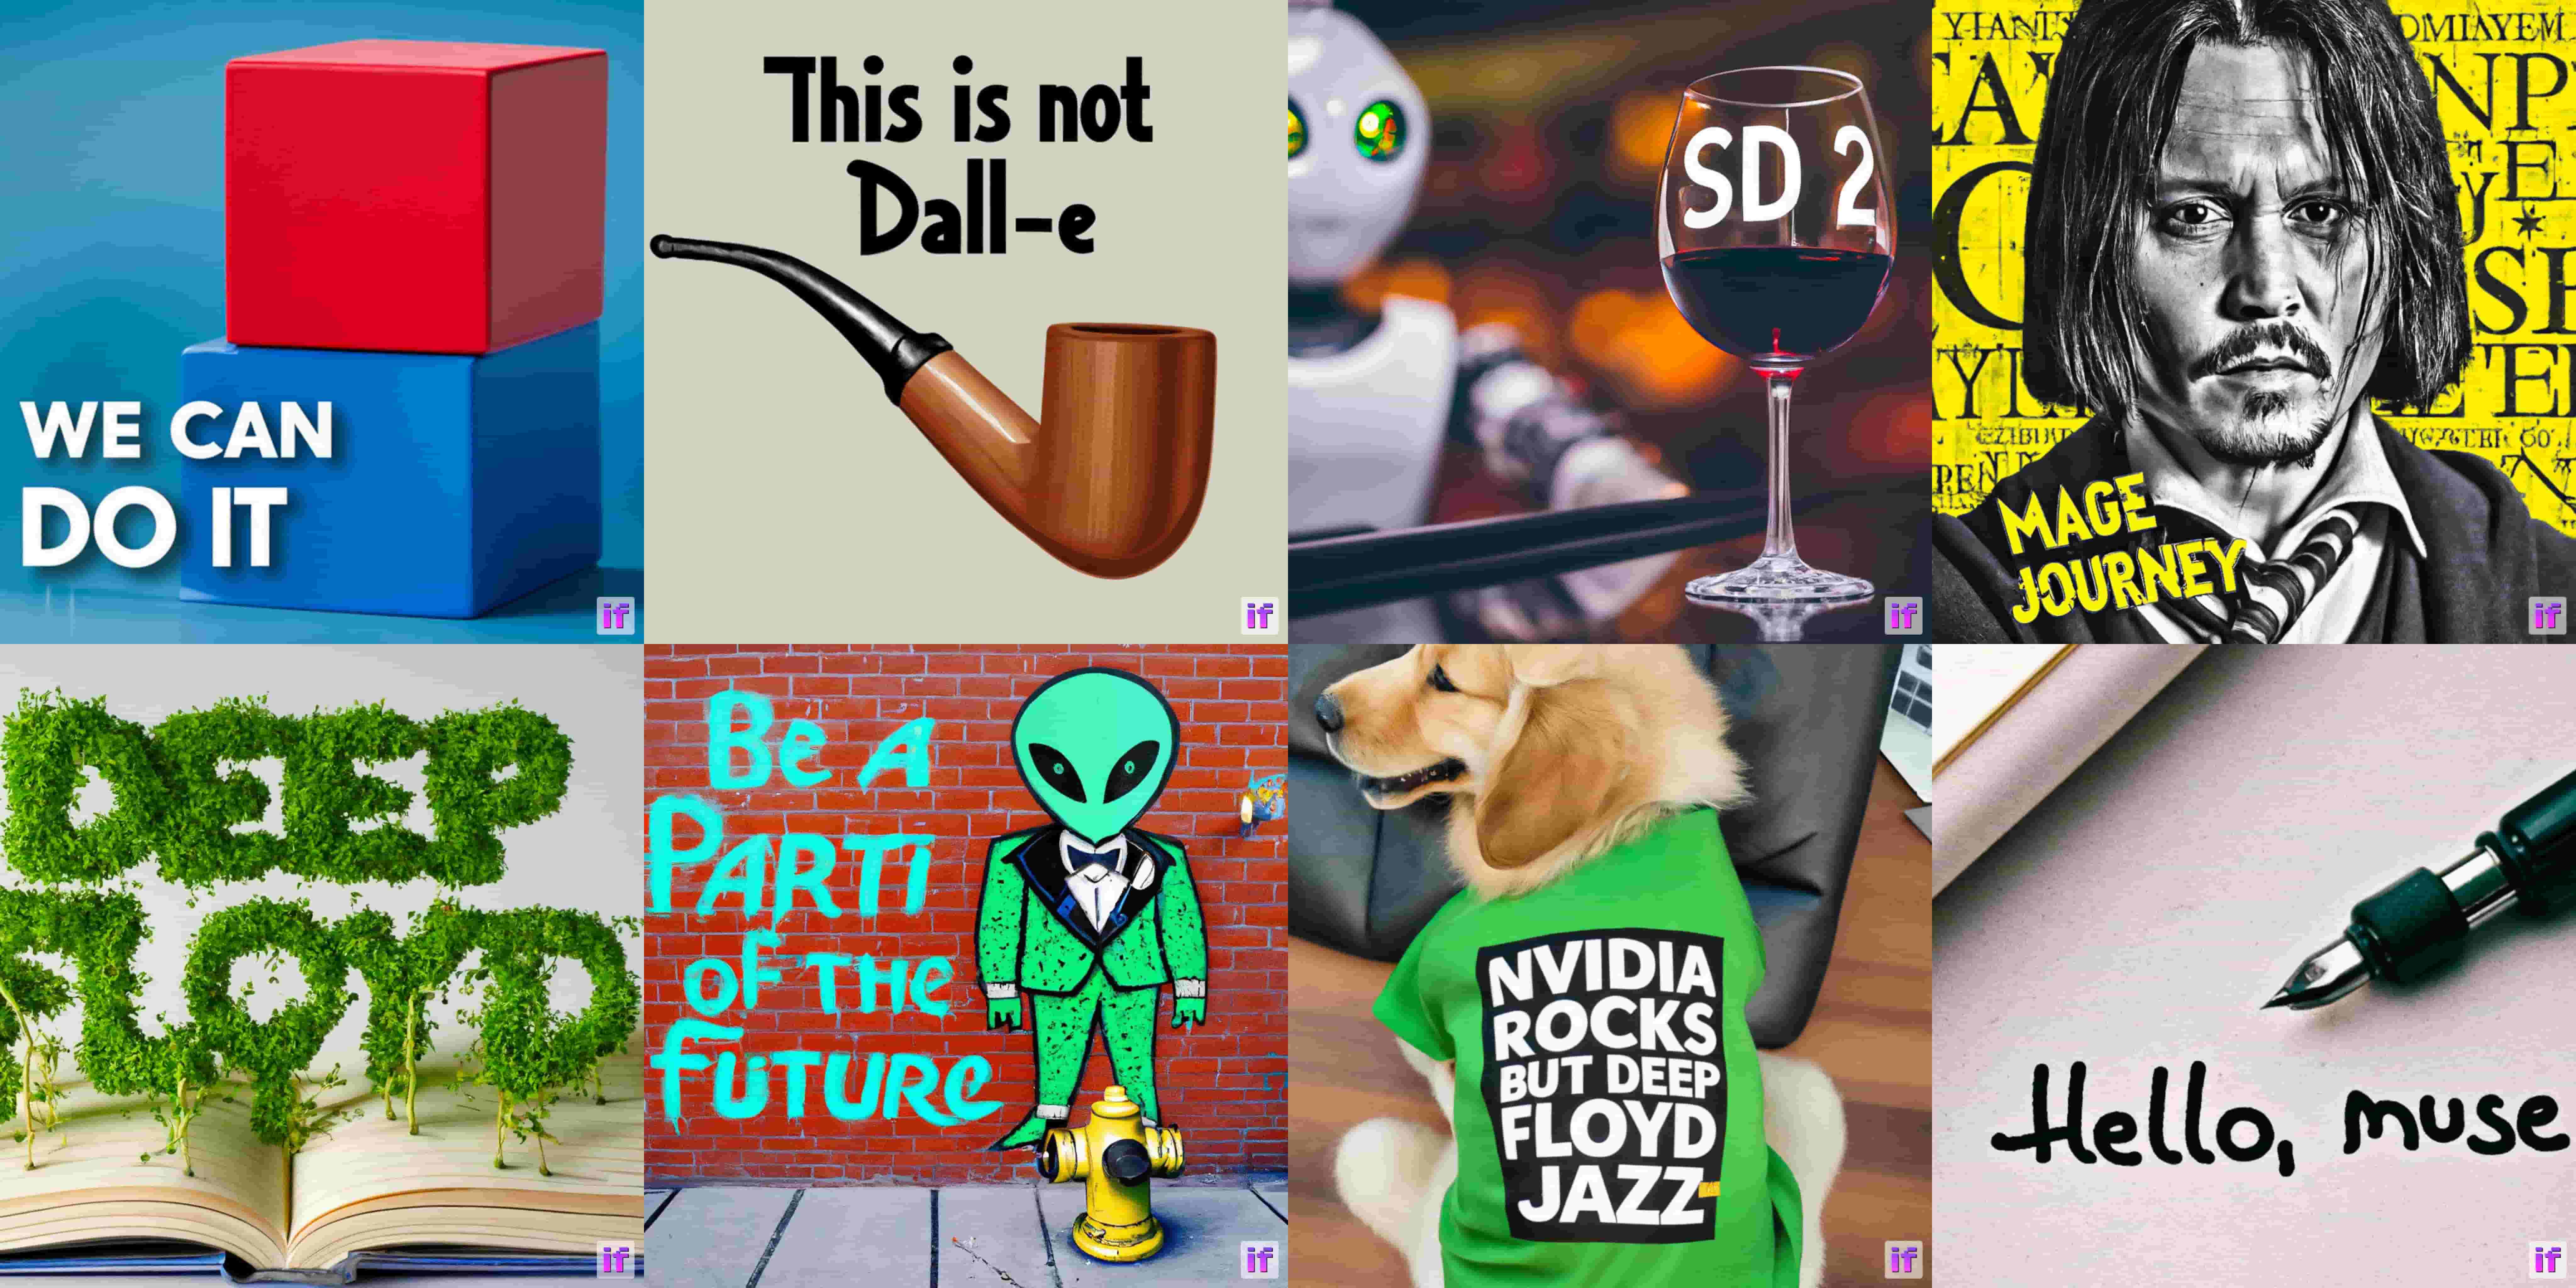
IFはGoogleが開発した画像生成モデルで、高解像度かつ高品質な画像を生成できます。
通常は高性能なGPUが必要ですが、本記事ではdiffusersライブラリの最適化やメモリ管理の工夫により、無料Colabでも実行可能にしています。
これにより、より多くの人が最新の画像生成技術にアクセスできるようになります。
Hugging Face Blog ★3 ビジネス EN

中国語話者向けHugging Faceブログ開設:中国AIコミュニティとの連携強化

要約を読む要約を閉じる
📰ニュース

Hugging Faceが中国語話者向けの公式ブログを開設しました。

🔍注目ポイント

中国のAIコミュニティとの連携を深め、情報共有と協力を促進することが狙いです。

🔮これからどうなる

中国のAI開発者がHugging Faceのリソースにアクセスしやすくなり、グローバルなAIエコシステムへの貢献が期待されます。

Hugging Faceは、AIモデルやデータセットの共有プラットフォームとして世界中で利用されています。
今回の中国語ブログ開設は、中国の広大なAIコミュニティとのコミュニケーションを強化し、より多くの開発者がHugging Faceのエコシステムに参加できるよう支援することを目的としています。
これにより、中国語圏のAI研究者や開発者が最新のAI技術やトレンドに触れる機会が増え、国際的な共同研究やオープンソース活動が活発になることが期待されます。
Hugging Face Blog ★3 研究 EN

UnityゲームをHugging Face Spacesでホストする方法

要約を読む要約を閉じる
📰ニュース

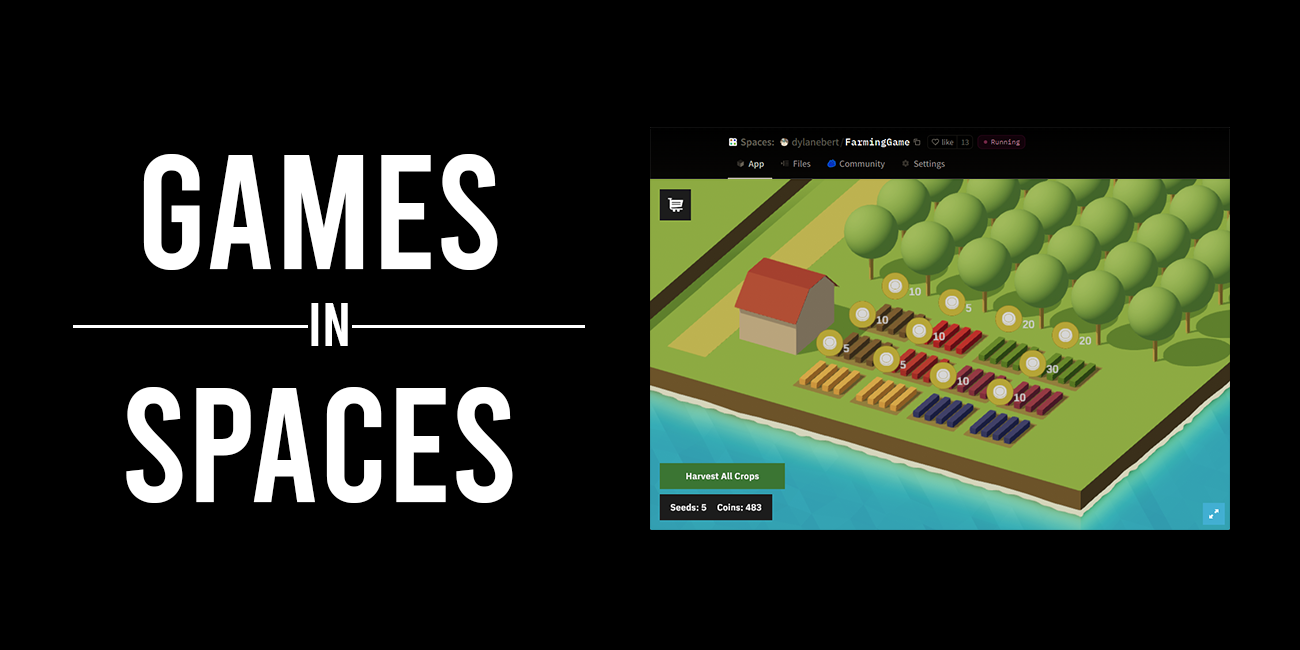
Hugging Face Spaces上でUnityゲームをホストし、ブラウザでプレイ可能にする方法が公開されました。

🔍注目ポイント

Unity WebGLビルドをSpacesにアップロードし、簡単な設定でウェブアプリケーションとして公開できるのが技術的ポイントです。

🔮これからどうなる

開発者はUnityゲームのデモやプロトタイプを簡単に共有・公開できるようになり、ユーザーは手軽にゲームを体験できます。

Hugging Face Spacesは、機械学習モデルやデモをホストするためのプラットフォームですが、今回Unity WebGLビルドにも対応しました。
これにより、複雑なサーバー設定なしに、ゲームをウェブ上で公開できる手軽な方法が提供されます。
特に、AIを活用したゲームやインタラクティブなデモの共有に役立ちます。
Hugging Face Blog ★4 LLM EN

Transformerを用いたグラフ分類

要約を読む要約を閉じる
📰ニュース

Hugging FaceがTransformerモデルをグラフ分類タスクに適用する手法を紹介しました。

🔍注目ポイント

グラフ構造をシーケンスデータに変換し、Transformerの強力な表現学習能力を活用します。

🔮これからどうなる

複雑なグラフデータの分析が容易になり、創薬やソーシャルネットワーク分析などに応用が期待されます。

グラフ分類は、グラフ全体を特定のカテゴリに分類するタスクです。
従来のグラフニューラルネットワーク(GNN)とは異なり、Transformerは自己注意機構により長距離依存関係を捉えるのに優れています。
この手法は、グラフをノードやエッジのシーケンスとして表現し、Transformerに入力することで分類を行います。
Hugging Face Blog ★4 AI倫理 EN

Substraでプライバシー保護AIを構築する

要約を読む要約を閉じる
📰ニュース

Substraは、データが分散されたままでAIモデルを共同で学習できるフレームワークです。

🔍注目ポイント

データ移動なしに連合学習とプライバシー保護技術を組み合わせ、機密データを安全に利用します。

🔮これからどうなる

医療や金融など機密性の高い分野で、プライバシーを侵害せずにAI開発が加速します。

Substraは、データが各組織のローカルに保持されたまま、モデルの更新情報のみを共有して学習を進める連合学習(Federated Learning)を実装しています。
これにより、データプライバシーを確保しつつ、複数のデータセットから恩恵を受けることが可能になります。
特に、医療分野での診断モデル開発や金融分野での不正検知など、機密性の高いデータを取り扱うAI開発において非常に有効です。
Hugging Face Blog ★4 LLM EN

StackLLaMA: RLHFでLLaMAをトレーニングする実践ガイド

要約を読む要約を閉じる
📰ニュース

Hugging FaceがRLHFを用いてLLaMAをトレーニングする具体的な手法を公開しました。

🔍注目ポイント

RLHF(人間からのフィードバックによる強化学習)をLLaMAに適用する詳細なステップとコードが提供されています。

🔮これからどうなる

研究者や開発者がLLaMAのような大規模言語モデルをより効果的に微調整できるようになります。

このガイドは、報酬モデルのトレーニング、強化学習の実行など、RLHFの各段階を網羅しています。
StackLLaMAデータセットを使用し、オープンソースツールを活用することで、誰でも実践的なトレーニングを試せるようになっています。