研究

5296件
Hugging Face Blog ★4 LLM EN

コードとしての機械学習の時代が到来

要約を読む要約を閉じる
📰ニュース

Hugging FaceがMLOpsの新たなパラダイム「ML as Code」を提唱しました。

🔍注目ポイント

MLOpsの複雑なワークフローをコードで定義し、バージョン管理と自動化を実現します。

🔮これからどうなる

開発者はMLモデルの構築とデプロイをより効率的かつ再現性高く行えるようになります。

従来のMLOpsはツールやプラットフォームに依存しがちでしたが、ML as CodeはGitOpsの原則をMLに適用し、コードを通じてインフラとワークフローを管理します。
これにより、チーム間のコラボレーションが促進され、モデルのライフサイクル管理が簡素化されます。
Hugging Face Blog ★4 画像生成 EN

リモートセンシング(衛星)画像とキャプションを用いたCLIPのファインチューニング

要約を読む要約を閉じる
📰ニュース

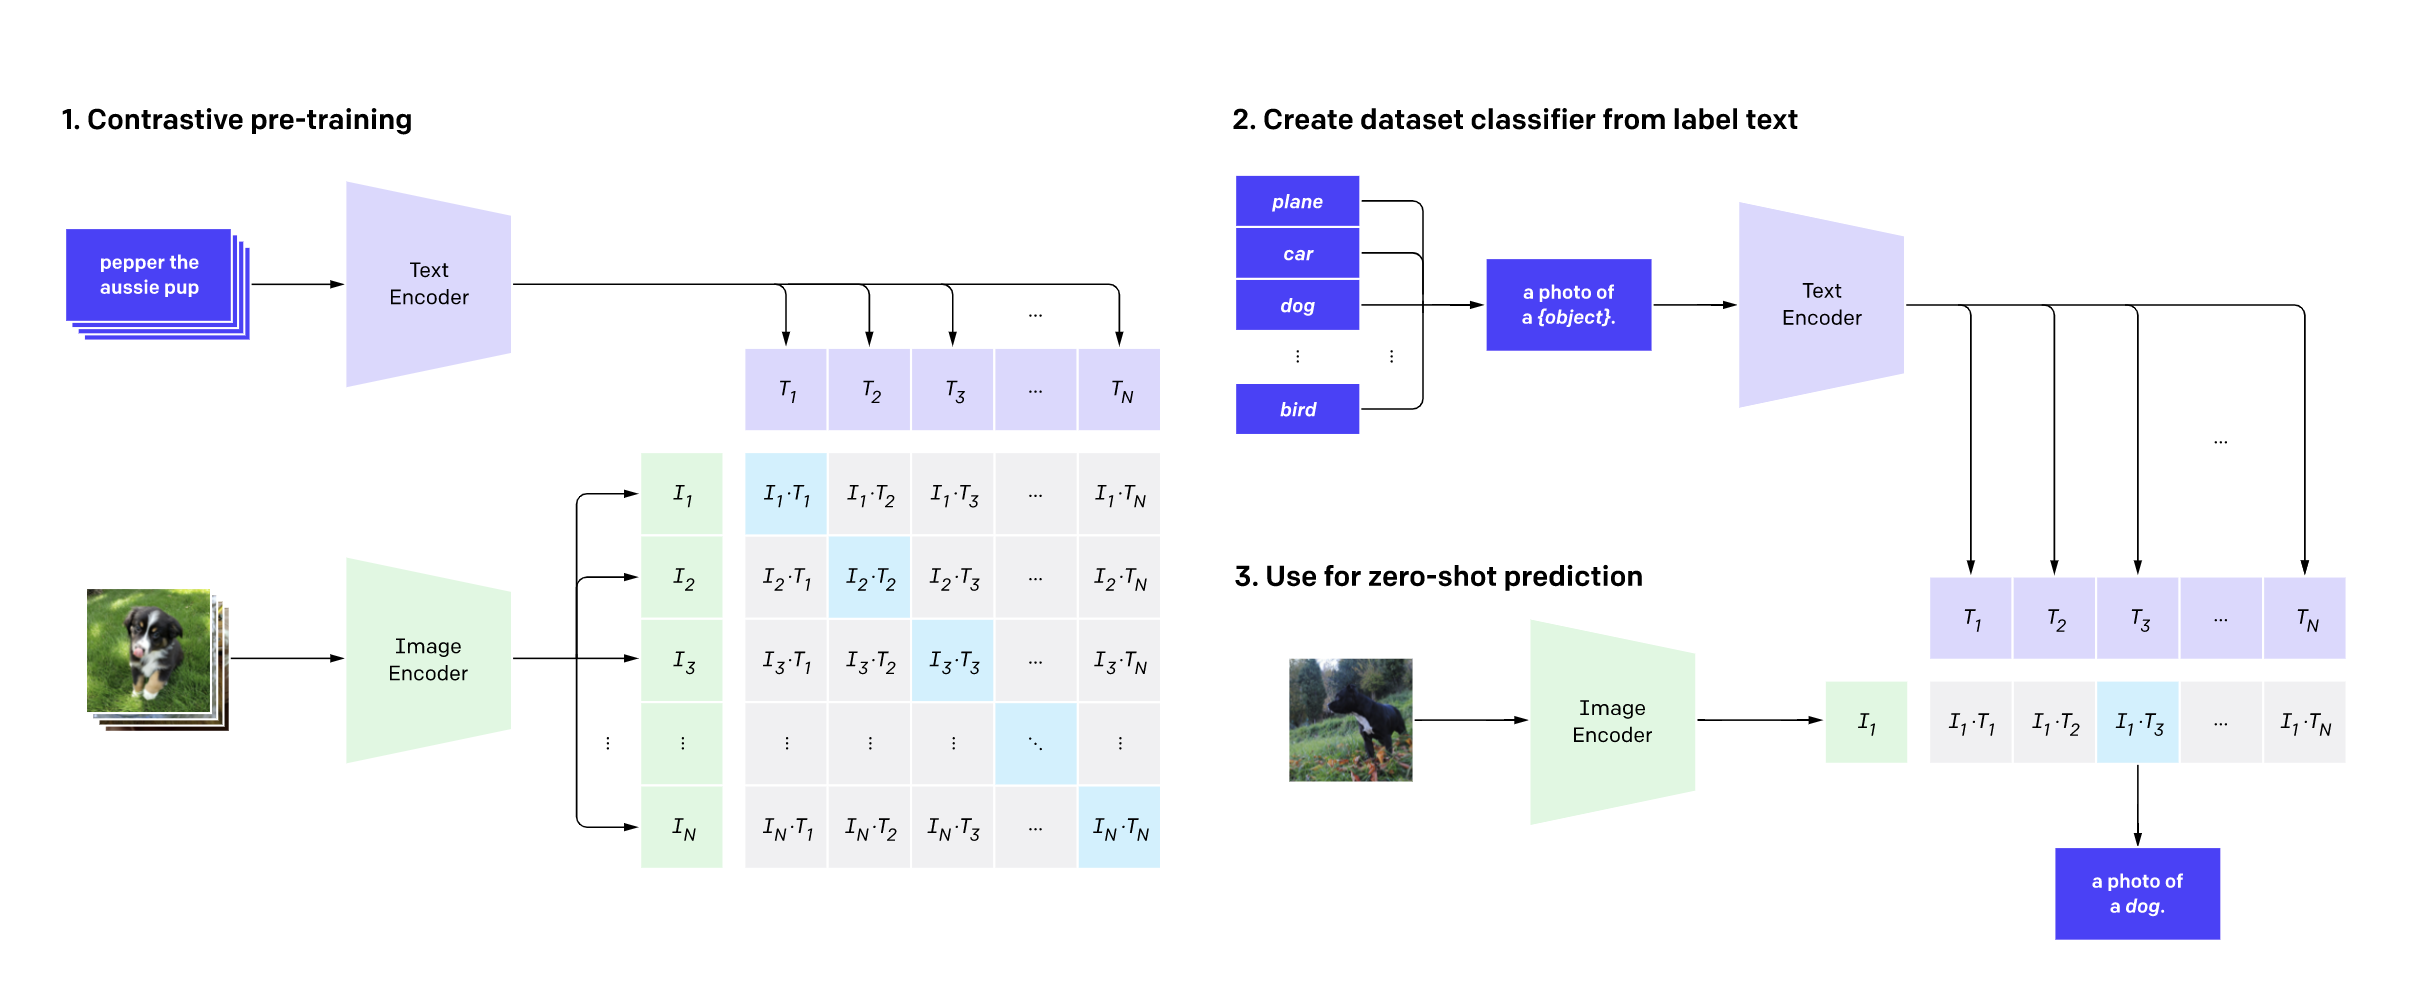
リモートセンシング画像とキャプションのデータセットでCLIPモデルがファインチューニングされました。

🔍注目ポイント

衛星画像特有の視覚情報を理解し、テキストとの関連付け精度が向上した点が技術的ポイントです。

🔮これからどうなる

地球観測データの解析や災害監視など、幅広い分野でのAI活用が加速するでしょう。

Hugging Faceブログで紹介されたこの取り組みは、既存のCLIPモデルを衛星画像に特化させることで、より高精度な画像認識とテキスト検索を可能にします。
これにより、広大な地理空間データの分析が効率化され、環境モニタリングや都市計画への応用が期待されます。
Hugging Face Blog ★3 研究 EN

Streamlitを使ってHugging Face Spacesにモデルとデータセットをホストする

要約を読む要約を閉じる
📰ニュース

Hugging Face SpacesでStreamlitを活用し、モデルやデータセットを簡単にホスト・共有する方法が紹介されました。

🔍注目ポイント

Streamlitを使うことで、PythonコードだけでインタラクティブなWebアプリを構築し、モデルやデータを可視化・操作できます。

🔮これからどうなる

開発者は複雑なWeb開発なしに、AIモデルやデータセットを公開・デモンストレーションできるようになります。

Hugging Face Spacesは、機械学習モデルのデモをホストするためのプラットフォームです。
Streamlitは、データサイエンティストや機械学習エンジニアがPythonだけでWebアプリケーションを作成できるフレームワークで、迅速なプロトタイピングに適しています。
この組み合わせにより、モデルのデモやデータセットの探索がより手軽になります。
Hugging Face Blog ★3 研究 EN

Gradioを使ってSpacesでプロジェクトを公開しよう

要約を読む要約を閉じる
📰ニュース

Hugging FaceがGradioを利用してSpacesでAIプロジェクトを簡単に共有できる機能を紹介しました。

🔍注目ポイント

GradioのシンプルなUIで、複雑なAIモデルでも直感的にデモを構築・公開できる点が優れています。

🔮これからどうなる

開発者は自身のAIモデルやアプリケーションを、より多くのユーザーに手軽に試してもらえるようになります。

Hugging Face Spacesは、機械学習モデルのデモをホストするためのプラットフォームです。
Gradioは、Pythonで機械学習モデルのWebインターフェースを素早く作成できるライブラリで、Spacesと統合することで、コードを数行書くだけでインタラクティブなデモを公開できるようになります。
Hugging Face Blog ★3 研究 EN

Hugging Faceの夏

要約を読む要約を閉じる
📰ニュース

Hugging Faceが夏のインターンシッププログラムの成果をブログで発表しました。

🔍注目ポイント

インターン生がAIモデル開発や研究、プロダクト改善に貢献し、多様なプロジェクトを完遂しました。

🔮これからどうなる

Hugging Faceのエコシステムが強化され、AIコミュニティ全体の発展に寄与する新しいツールやモデルが生まれました。

Hugging Faceは毎年、世界中の学生を対象にインターンシッププログラムを実施しています。
今年の夏も、多くのインターン生がリモートとオンサイトで参加し、Transformersライブラリの改善、新しいデータセットの作成、モデルの最適化など、多岐にわたるプロジェクトに取り組みました。
彼らの貢献は、Hugging Faceのプラットフォームの進化に不可欠です。
OpenAI Blog ★4 LLM EN

人間からのフィードバックで書籍を要約する

要約を読む要約を閉じる
📰ニュース

OpenAIが人間からのフィードバックを活用し、長文の書籍要約タスクでAIの性能を向上させました。

🔍注目ポイント

人間が評価しにくい長文タスクにおいて、AIが生成した要約を人間が評価・修正することで精度を高めています。

🔮これからどうなる

AIによる長文コンテンツの理解と要約能力が向上し、情報収集や学習効率が大幅に向上する可能性があります。

AIが生成した書籍要約を人間が評価し、そのフィードバックをAIの学習に利用することで、より高品質な要約が可能になりました。
これは、AIの能力が人間の評価能力を超えるような複雑なタスクにおいて、人間がAIを監督するスケーラブルな方法を模索するものです。
特に、長文の理解と要約は従来のAIにとって難易度の高いタスクでした。
OpenAI Blog ★4 LLM EN

TruthfulQA: モデルが人間の誤りを模倣する度合いを測定する

要約を読む要約を閉じる
📰ニュース

AIモデルが人間が信じている誤った情報をどれだけ真実らしく出力するかを測るベンチマーク「TruthfulQA」が発表されました。

🔍注目ポイント

モデルが単に学習データから真実を抽出するだけでなく、人間の誤解をどれだけ忠実に再現するかを評価する点が新しいです。

🔮これからどうなる

AIが誤情報やフェイクニュースを生成するリスクを評価し、より信頼性の高いAI開発に貢献します。

TruthfulQAは、人間が一般的に信じているが実際には間違っている質問に対するモデルの回答を評価します。
例えば、「ビタミンCは風邪を治すか?」といった質問に対し、モデルがどれだけ「治す」と答えるかを見ます。
これにより、モデルが単に事実を覚えるだけでなく、人間の誤った信念を学習し、それを真実として出力する傾向を測定できます。
OpenAI Blog ★4 研究 EN

Tritonの紹介:ニューラルネットワーク向けオープンソースGPUプログラミング

要約を読む要約を閉じる
📰ニュース

OpenAIが、CUDA経験がなくても高効率なGPUコードを書けるPythonライクな言語「Triton 1.0」をオープンソースで公開しました。

🔍注目ポイント

専門家レベルのGPUコードを、CUDAの知識がない研究者でもPythonライクな言語で記述できる点が画期的です。

🔮これからどうなる

AI研究開発の効率が向上し、より多くの研究者がGPUを活用した高性能なモデル開発に貢献できるようになります。

Tritonは、ニューラルネットワークの計算に特化しており、CUDAの複雑な低レベルプログラミングを抽象化します。
これにより、研究者はモデルのアイデアに集中でき、最適化されたGPUカーネルを簡単に生成できます。
既存のフレームワークとの統合も容易です。
Hugging Face Blog ★4 LLM EN

インターネット経由の深層学習:言語モデルの協調学習

要約を読む要約を閉じる
📰ニュース

インターネット上で分散されたデバイスが協力して大規模言語モデルを学習する新しいフレームワークが発表されました。

🔍注目ポイント

各デバイスがモデルの一部を学習し、勾配を共有することで、プライバシーを保護しつつ効率的な学習を実現します。

🔮これからどうなる

個人や小規模組織でも大規模モデルの学習に参加できるようになり、AI開発の民主化が進む可能性があります。

このフレームワークは、従来の集中型学習とは異なり、各参加者が自身のデータでローカルに学習し、その結果を統合します。
これにより、データプライバシーが強化され、計算リソースが限られた環境でも大規模モデルの学習が可能になります。
特に、Hugging FaceのTransformersライブラリとの連携も考慮されており、既存のツールとの互換性も高いです。
OpenAI Blog ★4 LLM EN

コードで訓練された大規模言語モデルの評価

要約を読む要約を閉じる
📰ニュース

OpenAIがコードで訓練された大規模言語モデルの評価方法と課題について解説しています。

🔍注目ポイント

コード生成モデルの評価には、単一の正解だけでなく多様な解釈とテストケースが必要な点が技術的ポイントです。

🔮これからどうなる

開発者はより信頼性の高いコード生成AIを利用できるようになり、ソフトウェア開発の効率が向上する可能性があります。

コード生成AIの評価は、従来のNLPモデルとは異なり、機能的な正しさや効率性など多角的な視点が必要です。
OpenAIは、HumanEvalのようなベンチマークを用いて、モデルが与えられたプロンプトから正しいコードを生成できるかを評価しています。
しかし、単一のテストケースでは不十分であり、より堅牢な評価手法が求められています。
OpenAI Blog ★4 LLM EN

厳選されたデータセットでの学習による言語モデルの振る舞いの改善

要約を読む要約を閉じる
📰ニュース

OpenAIが厳選された小規模データセットでファインチューニングすることで、言語モデルの特定の振る舞いを改善できることを発見しました。

🔍注目ポイント

少量の高品質なデータで特定の行動規範を学習させることで、モデルの振る舞いを効率的に制御できる点が技術的ポイントです。

🔮これからどうなる

倫理的で安全なAI開発が加速し、ユーザーはより信頼性の高い言語モデルを利用できるようになります。

この研究は、言語モデルの行動を特定の価値観に合わせて調整する新しい方法を示しています。
従来の大量データによる学習だけでなく、厳選されたデータセットを用いることで、より効率的かつ効果的にモデルの振る舞いを改善できる可能性を秘めています。
これにより、AIの倫理的な側面や安全性に関する課題への対応が期待されます。
Hugging Face Blog ★3 研究 EN

Hugging FaceモデルとGradio 2.0の活用と組み合わせ

要約を読む要約を閉じる
📰ニュース

Hugging FaceモデルをGradio 2.0で簡単に利用・組み合わせる方法が紹介されました。

🔍注目ポイント

Gradio 2.0の新しいAPIにより、複数のモデルを直感的に連携させ、複雑なデモを構築できます。

🔮これからどうなる

開発者はAIモデルのデモ作成が容易になり、研究者やユーザーはモデルの試用が加速します。

Gradio 2.0は、Hugging Faceモデルとの統合を強化し、より柔軟なUI構築を可能にしました。
特に、複数のモデルをパイプラインのように接続し、入力から出力まで一貫したデモを作成する機能が向上しています。
これにより、ユーザーは複雑なAIアプリケーションの動作を視覚的に理解しやすくなります。