Kubernetesを7,500ノードにスケール
要約を読む要約を閉じる
OpenAIがKubernetesクラスターを7,500ノードに拡張することに成功しました。
大規模モデルの学習・推論を支える、極めて高いスケーラビリティを持つインフラを構築しました。
GPT-3やDALL·Eのような大規模AIモデルの開発と運用がさらに効率化されます。
これにより、AI研究開発の効率と速度が大幅に向上することが期待されます。
OpenAIがKubernetesクラスターを7,500ノードに拡張することに成功しました。
大規模モデルの学習・推論を支える、極めて高いスケーラビリティを持つインフラを構築しました。
GPT-3やDALL·Eのような大規模AIモデルの開発と運用がさらに効率化されます。
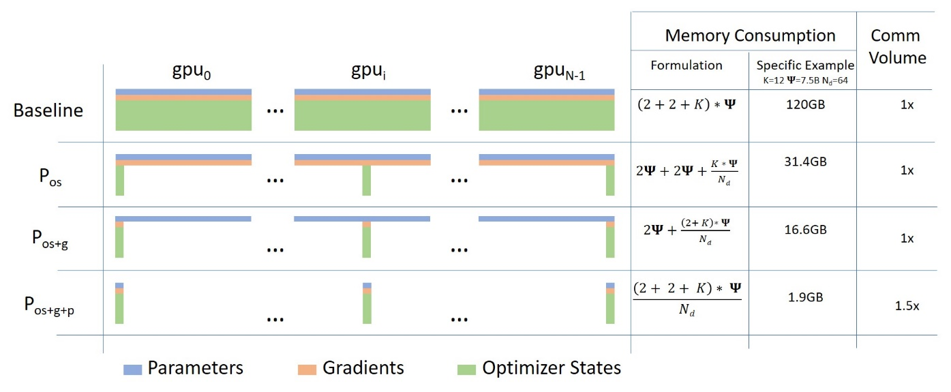
ZeRO技術を活用することで、大規模モデルの学習効率とメモリ使用量を大幅に改善しました。
ZeROはモデルのパラメータ、勾配、最適化状態を分散させ、GPUメモリを効率的に利用します。
研究者や開発者は、より大きなモデルを少ないリソースで、より速く学習できるようになります。
OpenAIがテキストキャプションから画像を生成するニューラルネットワーク「DALL·E」を発表しました。
自然言語で表現できる幅広い概念を画像として具現化できる点が画期的な技術です。
クリエイターやデザイナーがアイデアを視覚化するプロセスを劇的に変える可能性があります。
OpenAIが自然言語から視覚概念を学習するニューラルネットワーク「CLIP」を発表しました。
GPTシリーズのように、視覚カテゴリ名を与えるだけでゼロショット分類が可能な点が技術的ポイントです。
画像認識タスクにおいて、事前学習なしで多様な分類が可能になり、開発効率が向上します。
事前学習済みのエンコーダーのみ、またはデコーダーのみのモデルをエンコーダー・デコーダーモデルに変換する手法が紹介されました。
既存の事前学習済みモデルの重みを再利用することで、スクラッチからの学習よりも効率的に高性能なモデルを構築できます。
研究者や開発者は、より少ない計算リソースで多様なタスクに対応するエンコーダー・デコーダーモデルを開発できるようになります。
fairseqのWMT19翻訳システムがHugging FaceのTransformersライブラリに移植されました。
最先端の翻訳モデルがTransformersで利用可能になり、より簡単にアクセス・利用できるようになりました。
研究者や開発者が高性能な翻訳モデルをTransformers上で手軽に活用できるようになります。
Hugging Face TransformersとRay Tuneを組み合わせた効率的なハイパーパラメータ探索手法が紹介されました。
Ray Tuneの高度なスケジューリングとリソース管理により、大規模モデルの探索が効率化されます。
AI開発者はモデル性能を最大化し、開発時間を短縮できるようになります。
Transformerベースのエンコーダー・デコーダーモデルの仕組みと応用が解説されました。
自己注意機構により、入力と出力の長距離依存関係を効率的に捉える点が優れています。
機械翻訳や要約など、シーケンスからシーケンスへの変換タスクの性能が向上します。
Hugging Faceが、ブロックスパース行列を活用してLLMのサイズと推論速度を改善する手法を発表しました。
ブロックスパース行列は、モデルの重みの一部をゼロにすることで、メモリ使用量を削減し、計算効率を高めます。
より多くのユーザーが、高性能なLLMを低コストで利用できるようになり、AIアプリケーションの普及が加速します。
OpenAIが生成言語モデルを自動定理証明に応用する研究を発表しました。
GPT-4などの大規模言語モデルが、複雑な数学的証明を自動生成・検証する能力を示しました。
数学研究者やソフトウェア開発者が、より効率的に定理を発見・証明できるようになります。
OpenAIが人間のフィードバックを用いた強化学習で、より優れた要約モデルを開発しました。
人間の評価を報酬として利用する強化学習により、要約の質を大幅に向上させています。
AIによる要約の精度が向上し、情報過多な現代において効率的な情報収集が可能になります。
OpenAI Scholars 2020の参加者が5ヶ月間の研究成果を発表しました。
多様なバックグラウンドを持つ研究者が、AI分野で具体的な成果を上げた点です。
AI研究の裾野が広がり、新たな才能が業界に参入する機会が生まれます。