ロボット

627件
ITmedia AI+ ★4 ロボット

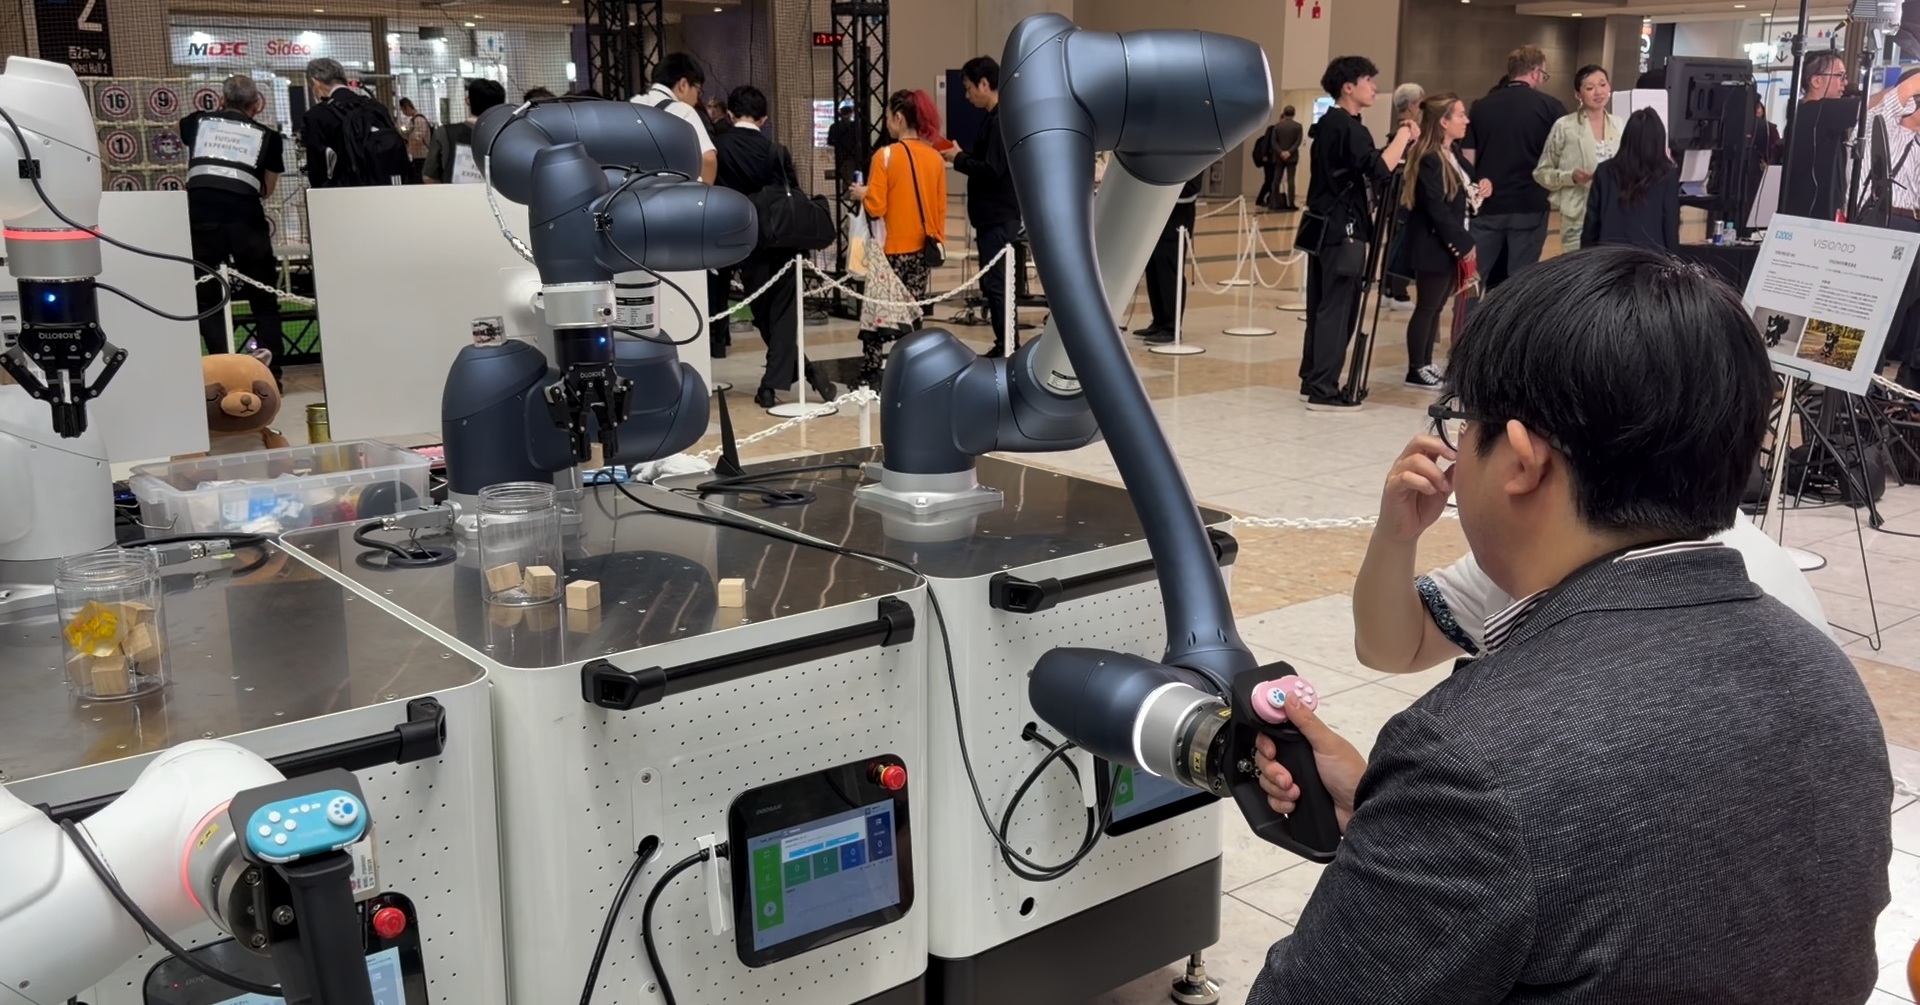
「まるで一反もめん」と話題の“人型重機” JRも活用する技術を市販ロボに 国産スタートアップ人機一体

要約を読む要約を閉じる
📰ニュース

人機一体がJRで稼働中の人型重機技術を市販ロボットへ応用する試みを進めています。

🔍注目ポイント

高所作業用人型重機の基幹技術を、既存の協働ロボットに適用し汎用性を高める点です。

🔮これからどうなる

危険な高所作業やインフラメンテナンスの自動化・効率化が加速し、作業員の安全性が向上します。

人機一体は、鉄道設備メンテナンスで実績のある「一反木綿」のような人型重機を開発したスタートアップです。
この技術を市販の産業用ロボットに組み込むことで、より多くの現場で活用されることを目指しています。
これにより、特定の用途に特化していた技術が、幅広い産業分野で利用可能になる可能性があります。
ASCII.jp ★3 ロボット

倒れている人に声をかけ家族へ通知、「LOVOT 3.0」専用機能「転倒時声かけ通知」提供開始へ

要約を読む要約を閉じる
📰ニュース

家族型ロボット「LOVOT 3.0」が、倒れている人を検知し家族へ通知する新機能を提供開始します。

🔍注目ポイント

LOVOTがAIで人の転倒を検知し、家族への通知と同時に、ロボット自身が声かけで安否確認を促します。

🔮これからどうなる

高齢者や一人暮らしの家族を持つ人々が、遠隔からでも大切な人の異変に気づきやすくなり、安心感が高まります。

GROOVE Xが提供するLOVOT 3.0の新機能「転倒時声かけ通知」は、5月中旬に提供開始予定です。
LOVOTが倒れている人を検知し、体勢に変化がない場合に家族のスマートフォンへ通知し、LOVOT自身もそばで声をかけ続けます。
これにより、緊急時の迅速な対応をサポートします。
arXiv cs.AI ★4 LLM EN

PRISM: Perception Reasoning Interleaved for Sequential Decision Making

要約を読む要約を閉じる
📰ニュース

LLMとVLMを連携させ、複雑なマルチモーダル環境でタスクを遂行するPRISMフレームワークが発表されました。

🔍注目ポイント

LLMがVLMの認識結果を批判的に評価し、目標指向の質問で再検証することで、タスクに特化した画像理解を実現します。

🔮これからどうなる

ロボットやエージェントがより複雑な現実世界タスクを効率的に実行できるようになり、私たちの生活を豊かにする可能性があります。

PRISMは、VLMの認識とLLMの意思決定を動的な質問応答パイプラインで密接に結合します。
これにより、VLMが生成した記述をLLMが受動的に受け入れるのではなく、能動的に批判・探求し、タスクに最適な情報を抽出します。
ALFWorldとRoom-to-Room (R2R) ベンチマークで、既存の画像ベースモデルを大幅に上回る性能を示し、手作業での質問設定が不要な自動化されたシステムです。
arXiv cs.AI ★4 ロボット EN

Long-Horizon Q-Learning: Accurate Value Learning via n-Step Inequalities

要約を読む要約を閉じる
📰ニュース

強化学習のQ学習において、長期的な学習の安定性と精度を向上させる「Long-Horizon Q-learning (LQL)」が提案されました。

🔍注目ポイント

LQLは、nステップの不等式を利用したヒンジ損失を導入し、誤差の伝播を防ぐことで、既存のQ学習やnステップTD学習よりも優れた性能を発揮します。

🔮これからどうなる

ロボット制御や自動運転など、長期的な意思決定が必要なAIシステムの信頼性と効率が向上する可能性があります。

Q学習はオフポリシーで任意の経験から学習できる利点がありますが、ブートストラップによる誤差伝播が長期学習の不安定さを招いていました。
LQLは、最適な行動が観測された行動よりも悪くなることはないという原理に基づき、この不等式違反を罰するメカニズムを導入しています。
これにより、追加のネットワークや計算コストなしで、既存の最先端手法と組み合わせても一貫して高い性能を示しました。
arXiv cs.AI ★4 ロボット EN

HaM-World: Soft-Hamiltonian World Models with Selective Memory for Planning

要約を読む要約を閉じる
📰ニュース

HaM-Worldは、選択的記憶とハミルトニアン構造を持つ新しい世界モデルを提案しました。

🔍注目ポイント

潜在空間を構成・運動・タスク意味に分離し、選択的記憶Mambaで安定した長期予測を実現します。

🔮これからどうなる

ロボット制御や計画タスクにおいて、より正確でロバストな行動決定が可能になります。

従来のモデルは長期予測で不安定になる課題がありましたが、HaM-Worldは潜在状態を(q, p)とcに分解し、Mambaを導入することでこの問題を解決しました。
DeepMind Control Suiteのタスクで高い性能を示し、特にOOD(分布外)の摂動下でも優れたロバスト性を発揮しています。
これにより、現実世界での複雑な環境変化にも対応しやすくなります。
arXiv cs.AI ★4 ロボット EN

Topology-Driven Anti-Entanglement Control for Soft Robots

要約を読む要約を閉じる
📰ニュース

ソフトロボットが絡まりを回避する新しい強化学習制御フレームワークが提案されました。

🔍注目ポイント

集中学習と分散実行を組み合わせ、トポロジー情報で絡まりリスクを評価・回避する点が技術的ポイントです。

🔮これからどうなる

複雑な環境でのソフトロボットの信頼性と作業効率が向上し、精密製造などへの応用が期待されます。

精密製造などの複雑な環境でソフトロボットの需要が高まる中、複数のロボットが絡まらずに協調作業を行うことが課題でした。
既存の分散型強化学習では観測性や学習の不安定さが問題でしたが、本研究はトポロジー駆動型MARLフレームワークでこれを解決します。
シミュレーション実験では、既存手法より収束性や絡まり回避効果が優れていることが示されました。
arXiv cs.AI ★4 ロボット EN

Creative Robot Tool Use by Counterfactual Reasoning

要約を読む要約を閉じる
📰ニュース

ロボットが因果推論を用いて、本来の目的外の道具を創造的に活用する技術が発表されました。

🔍注目ポイント

VLMと反実仮想生成で道具とタスクの因果関係を発見し、物理シミュレーションで道具使用スキルを転移させます。

🔮これからどうなる

ロボットが多様な環境で柔軟に道具を使いこなし、より複雑な作業を自律的に遂行できるようになります。

このフレームワークは、まず動的モデル内でシミュレーション実験を行い、道具とタスク間の因果関係を発見します。
VLMによる特徴提案と反実仮想的な道具生成により因果発見問題を分解し、特定された因果特徴に基づいて新しい物体を分類し、キーポイントマッチングでスキルを転移させます。
これにより、遠くの物を取る、お菓子をすくう、高い棚の物を取るなどのタ作業で有効性が示されました。
arXiv cs.AI ★4 ロボット EN

Unifying Goal-Conditioned RL and Unsupervised Skill Learning via Control-Maximization

要約を読む要約を閉じる
📰ニュース

目標条件付き強化学習と教師なしスキル学習を「制御最大化」という概念で統一する理論が発表されました。

🔍注目ポイント

異なる強化学習タスクとスキル学習手法が、未来の軌道が指示にどれだけ敏感かという「感度」の最大化として解釈できる点が画期的です。

🔮これからどうなる

強化学習の事前学習において、特定のタスクに最適なスキル学習手法を選択するための理論的指針が提供されるでしょう。

目標条件付き強化学習(GCRL)と相互情報スキル学習(MISL)は、それぞれ異なる目標達成基準と行動多様性の概念を持っていました。
本研究は、これらを制御最大化という共通の枠組みで捉え直し、MISLの目的がGCRLの目標感度を制限することを示しました。
これにより、事前学習が下流タスクにどのように貢献するかの理論的根拠が確立されます。
arXiv cs.AI ★4 ロボット EN

EA-WM:イベント認識型生成ワールドモデルと構造化運動学-視覚アクションフィールド

要約を読む要約を閉じる
📰ニュース

ロボットの動きを正確に予測し、視覚的に生成する新しいワールドモデル「EA-WM」が開発されました。

🔍注目ポイント

ロボットの動作を抽象的なトークンではなく、カメラ視点に直接投影する「構造化運動学-視覚アクションフィールド」を導入しました。

🔮これからどうなる

ロボットがより精密な動作計画を立て、複雑な物体操作を視覚的にシミュレーションできるようになります。

従来のワールドモデルは動画生成を補助的に扱い、ロボットの幾何学的精度や物体との相互作用の再現が不十分でした。
EA-WMは、アクション信号を動画合成に活用することで、この課題を解決します。
イベント認識型の双方向融合ブロックにより、物体状態の変化や相互作用のダイナミクスを捉えることができます。
arXiv cs.AI ★4 ロボット EN

想像をいつ信頼するか:世界行動モデルのための適応的行動実行

要約を読む要約を閉じる
📰ニュース

ロボットが予測と現実の乖離を検知し、行動計画を適応的に調整する新しい手法が開発されました。

🔍注目ポイント

FFDCという軽量な検証器が、予測される将来の行動と視覚、現実の観測、言語指示を統合し、行動計画の信頼性を評価します。

🔮これからどうなる

ロボットの作業効率と成功率が向上し、より複雑で接触の多いタスクでも信頼性の高い操作が可能になります。

従来のWAMsは固定数の行動を実行していましたが、本手法は予測と現実の一貫性に基づいて行動チャンクサイズを適応的に変更します。
これにより、長期間の実行効率を保ちつつ、困難な局面での応答性を回復させます。
RoboTwinベンチマークではWAMのフォワードパスを69.10%削減し、実世界実験では成功率を35%向上させました。
arXiv cs.AI ★3 ロボット EN

ガウス平滑化を用いたソフト決定論的方策勾配

要約を読む要約を閉じる
📰ニュース

決定論的方策勾配(DPG)の学習安定性を向上させる新しい強化学習アルゴリズムが提案されました。

🔍注目ポイント

ガウス平滑化を用いたベルマン方程式で、行動に対する批評家の勾配依存を排除し、非滑らかなQ関数でも安定した学習を可能にします。

🔮これからどうなる

ロボット制御や自動運転など、連続制御が必要なAIシステムの学習がより安定し、実用性が向上する可能性があります。

DPGは連続制御で広く使われますが、報酬が疎らな場合、批評家の行動勾配の微分可能性が問題でした。
提案されたSoft-DPGは、平滑化されたベルマン方程式に基づき、この問題を解決します。
実験では、標準的なDDPGよりも離散報酬環境で明確な性能向上を示しました。
arXiv cs.AI ★4 ロボット EN

NavOne: トップダウンマップを用いた視覚言語ナビゲーションにおけるワンステップグローバルプランニング

要約を読む要約を閉じる
📰ニュース

視覚言語ナビゲーション(VLN)において、ワンステップでグローバルな経路計画を行う新手法「NavOne」が発表されました。

🔍注目ポイント

NavOneは、トップダウンマップ上で多モーダル情報を統合し、経路確率を直接予測することで、効率的なグローバルナビゲーションを実現します。

🔮これからどうなる

ロボットや自動運転車が、より高速かつ正確に複雑な環境で目的地へ到達できるようになる可能性があります。

従来のVLN手法は、自己中心的なステップバイステップ方式で誤差が蓄積しやすく、効率性に課題がありました。
NavOneは、この問題を解決するため、ナビゲーションをトップダウンマップ上でのワンステップグローバル経路計画として再定義。
新しいR2R-TopDownデータセットも構築し、既存手法と比較して計画段階で8倍から80倍の高速化を達成しました。