新着ニュース

24372件
OpenAI Blog ★5 LLM EN

OpenAIの動画生成モデル「Sora」が公開

要約を読む要約を閉じる
📰ニュース

OpenAIの動画生成モデル「Sora」がsora.comで一般公開されました。

🔍注目ポイント

Soraは最大1080p、20秒までの動画をテキストから生成し、既存素材の拡張やリミックスも可能です。

🔮これからどうなる

クリエイターは高品質な動画コンテンツを効率的に制作できるようになり、動画制作の民主化が進みます。

Soraは、ワイドスクリーン、縦長、スクエアなど様々なアスペクト比に対応しています。
テキストプロンプトから全く新しいコンテンツを生成できるだけでなく、ユーザーが提供する既存の画像や動画を元に、それらを拡張したり、異なるスタイルにリミックスしたり、ブレンドしたりする機能も備えています。
Hugging Face Blog ★4 LLM EN

Amazon BedrockでHugging Faceモデルが利用可能に

要約を読む要約を閉じる
📰ニュース

Amazon BedrockでHugging Faceのオープンソースモデルが利用可能になりました。

🔍注目ポイント

Hugging Faceの多様なモデルをAWSのマネージドサービス上で簡単にデプロイ・利用できます。

🔮これからどうなる

開発者はより多くの選択肢から最適なモデルを選び、AIアプリケーション開発を加速できます。

Amazon Bedrockは、主要な基盤モデルをAPI経由で利用できるAWSのサービスです。
今回の統合により、Hugging Faceが提供するオープンソースの高性能モデル群がBedrockのラインナップに加わりました。
これにより、開発者はモデルのインフラ管理の手間なく、多様なAIモデルを試すことが可能になります。
Hugging Face Blog ★4 画像生成 EN

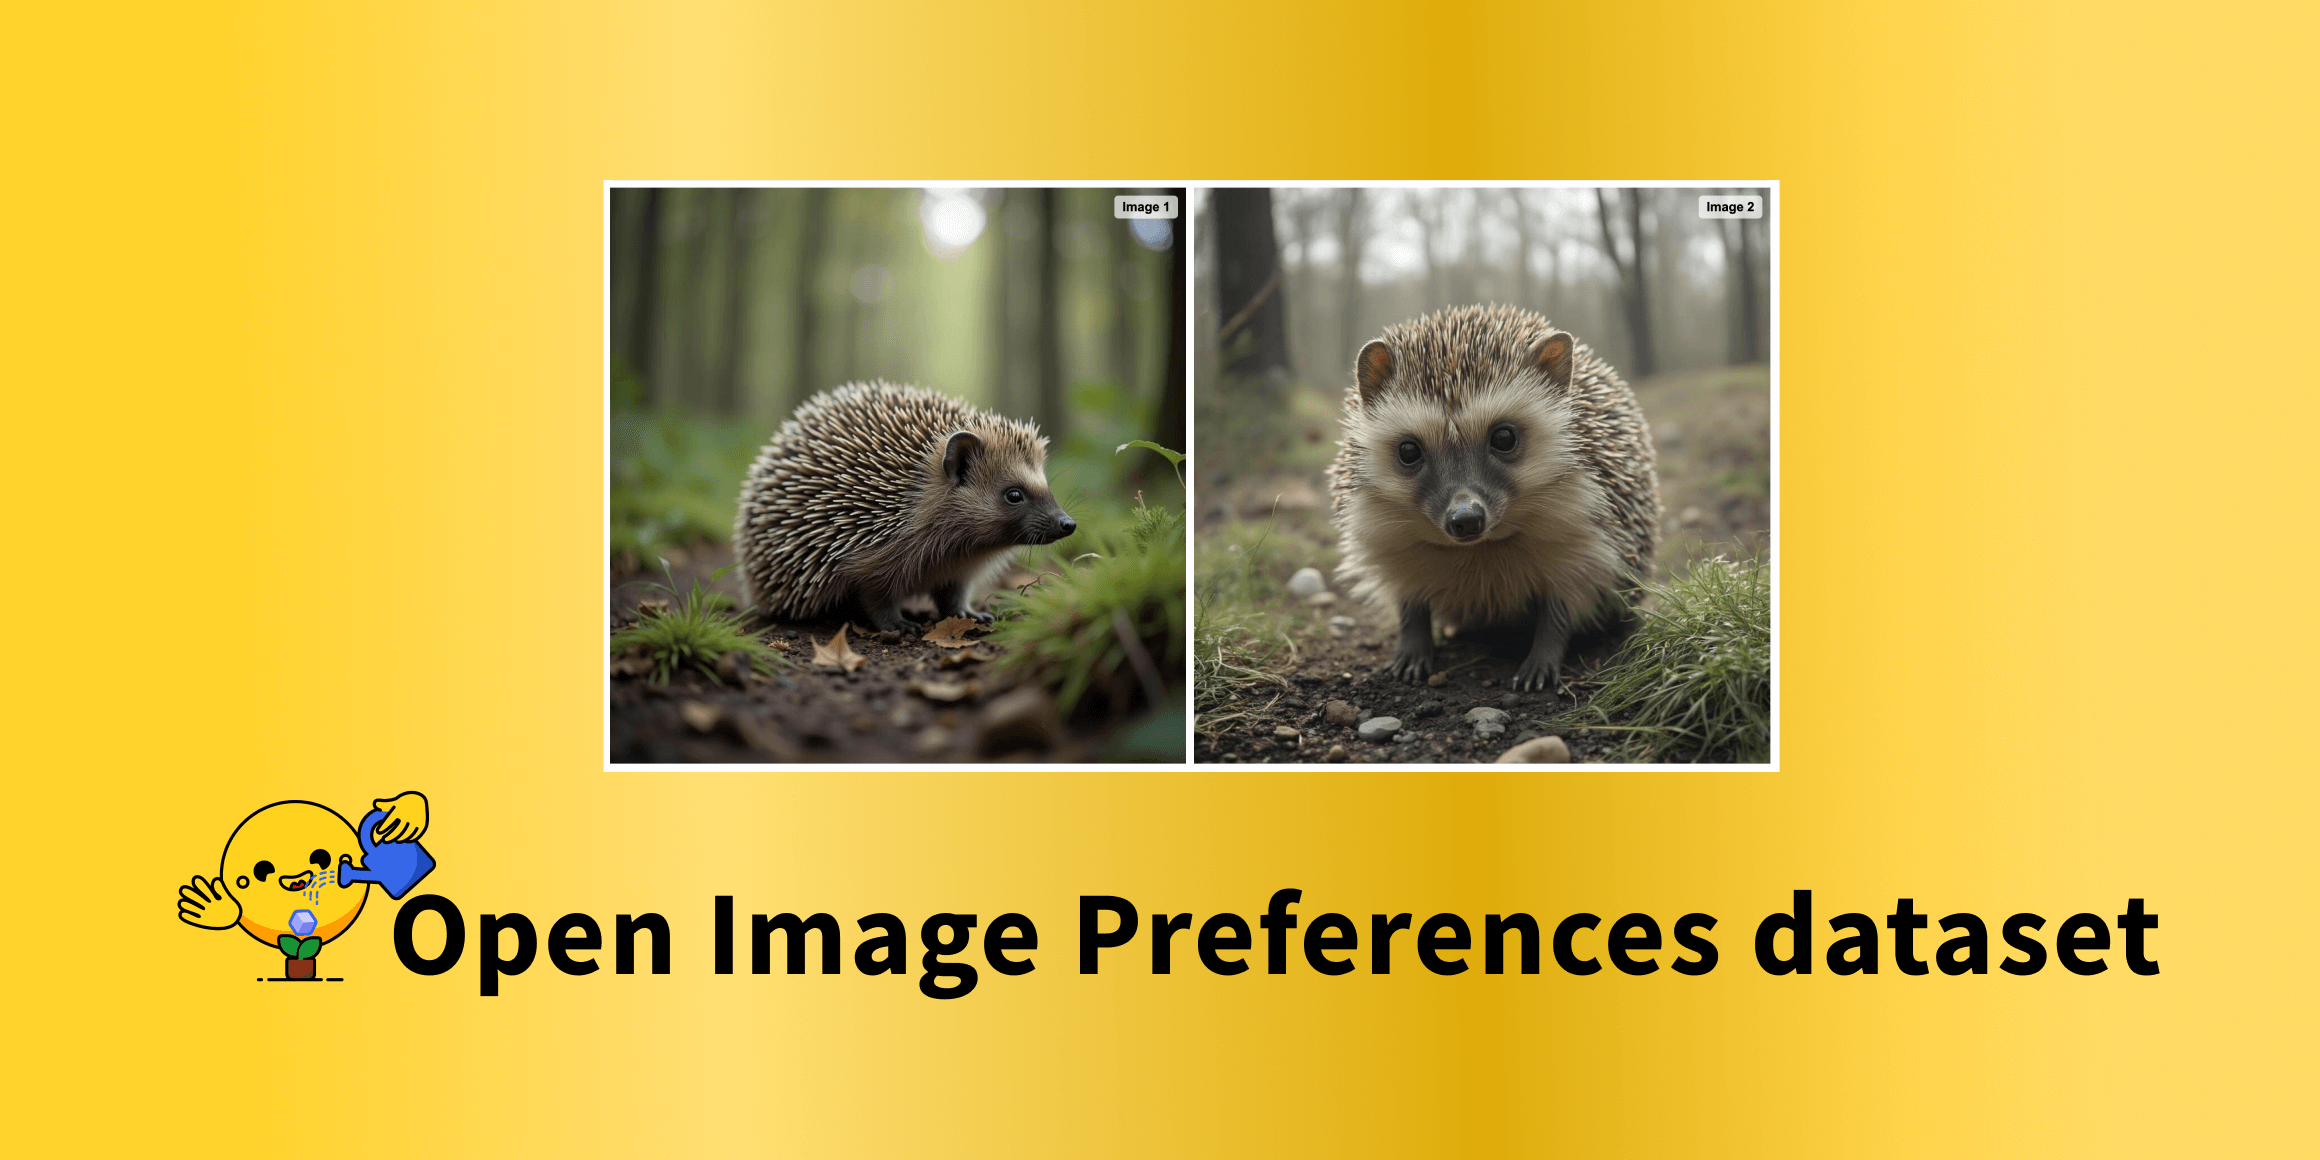
Hugging Faceコミュニティによるテキストから画像生成のためのオープンな選好データセット

要約を読む要約を閉じる
📰ニュース

Hugging Faceコミュニティがテキストから画像を生成するモデルの評価に用いるオープンな選好データセットを公開しました。

🔍注目ポイント

人間が選好した画像ペアのデータセットを公開し、モデルの性能評価と改善に役立つ透明性の高いリソースを提供します。

🔮これからどうなる

画像生成AIの品質向上と、よりユーザーの意図に沿った画像を生成するモデルの開発が加速するでしょう。

このデータセットは、ユーザーが生成された画像の中からより良いと感じた方を選択する形式で収集されました。
これにより、単なる客観的な指標だけでなく、人間の主観的な評価を反映したモデルの性能評価が可能になります。
オープンソースであるため、研究者や開発者が自由に利用し、画像生成モデルのベンチマークやファインチューニングに活用できます。
OpenAI Blog ★5 LLM EN

Soraシステムカード

要約を読む要約を閉じる
📰ニュース

OpenAIがテキスト、画像、動画から新しい動画を生成するモデル「Sora」を発表しました。

🔍注目ポイント

DALL-EとGPTの学習を基盤とし、多様な入力から高品質な動画を生成できる点が技術的ポイントです。

🔮これからどうなる

クリエイターやストーリーテラーが、より簡単にアイデアを動画として表現できるようになります。

SoraはOpenAIの動画生成モデルで、テキスト、画像、既存の動画をインプットとして受け取り、新しい動画を出力します。
これはDALL-EやGPTモデルからの学習を基に開発されており、人々に物語を語り、創造的に表現するための拡張されたツールを提供することを目指しています。
OpenAI Blog ★4 LLM EN

アニメーターのリンドン・バロワがSoraで新たな世界を創造

要約を読む要約を閉じる
📰ニュース

アニメーターのリンドン・バロワ氏がOpenAIの動画生成AI「Sora」を物語作成ツールとして活用しています。

🔍注目ポイント

Soraは、テキストプロンプトから高品質で一貫性のある長尺動画を生成できる点が画期的です。

🔮これからどうなる

クリエイターは時間とコストを大幅に削減し、これまで不可能だった表現やアイデアを具現化できるようになります。

バロワ氏は、Soraが単なるツールではなく、ストーリーテリングの可能性を広げる新しい表現媒体であると語っています。
これにより、個人クリエイターでも大規模な制作に匹敵する映像を制作できる可能性が示唆されています。
OpenAI Blog ★4 LLM EN

ヴァレ・デュアメルとSora:新しい世界を構築する

要約を読む要約を閉じる
📰ニュース

映像制作デュオのヴァレ・デュアメルが、OpenAIの動画生成AI「Sora」を活用した制作経験を語りました。

🔍注目ポイント

Soraは、既存の映像素材に縛られず、クリエイターが想像する全く新しい世界観を動画として具現化できる点が画期的です。

🔮これからどうなる

映像制作のプロセスが大きく変わり、個人クリエイターでも高品質な映像作品を制作できるようになる可能性があります。

ヴァレ・デュアメルは、Soraを使って現実には存在しないようなユニークな映像を制作しました。
これにより、従来の撮影やCG制作では困難だった表現が可能になり、クリエイティブなアイデアの実現を加速させると述べています。
Soraは、テキストプロンプトから最大1分間の動画を生成できるOpenAIの最先端AIモデルです。
OpenAI Blog ★3 画像生成 EN

Minne AtairuとSora:アーティストのビジョンを具現化するAI

要約を読む要約を閉じる
📰ニュース

学際的アーティストMinne Atairu氏が、OpenAIの動画生成AI「Sora」を活用し、自身の芸術的ビジョンを実現した。

🔍注目ポイント

Soraは、アーティストの創造性を刺激し、複雑なコンセプトや抽象的なアイデアを視覚的に表現する新たな手段を提供する。

🔮これからどうなる

アーティストは、時間やコストの制約なく、多様な表現を試せるようになり、アート制作のプロセスが大きく変化する可能性がある。

Minne Atairu氏は、Soraを用いて、自身の作品に登場するキャラクターや物語を動画として生成。
これにより、これまで実現が難しかった動きやシーンを容易に作成できた。
Soraの登場は、映像制作の民主化を加速させ、個人クリエイターの表現の幅を広げることに貢献する。
OpenAI Blog ★3 ビジネス EN

製品チームにAIを導入する

要約を読む要約を閉じる
📰ニュース

OpenAIが製品チームにAIを活用する方法を提案し、具体的な導入事例を紹介しています。

🔍注目ポイント

AIが製品開発の全段階でデータ分析、アイデア出し、ユーザーフィードバック収集を効率化します。

🔮これからどうなる

製品開発のサイクルが加速し、より顧客ニーズに合った高品質な製品が市場に投入されるでしょう。

OpenAIは、AIが製品ロードマップの策定から市場投入後の改善まで、多岐にわたるタスクで製品チームを支援できると強調しています。
特に、大量のデータを迅速に分析し、新たなインサイトを発見する能力が製品開発の質を高めます。
これにより、企業は競争力を維持し、イノベーションを推進できます。
OpenAI Blog ★4 LLM EN

ChatGPT Proの導入

要約を読む要約を閉じる
📰ニュース

OpenAIが、より高性能なAIモデルへのアクセスを提供するChatGPT Proを発表しました。

🔍注目ポイント

最先端のAIモデルをより多くのユーザーが利用できるようになり、AI技術の普及を加速させます。

🔮これからどうなる

企業や開発者は、高度なAI機能を活用して、より複雑なタスクや革新的なアプリケーションを開発できるようになります。

ChatGPT Proは、OpenAIが提供する最先端のAIモデルへの優先的なアクセスを可能にするサービスです。
これにより、既存の無料版では利用できなかった高度な機能や、より安定したパフォーマンスが期待されます。
AIの利用範囲を広げ、ビジネスや研究分野での活用を促進することが目的です。
OpenAI Blog ★3 AI倫理 EN

OpenAI o1システムカード公開

要約を読む要約を閉じる
📰ニュース

OpenAIが最新モデルo1およびo1-miniのリリースに先立ち、安全性評価結果を公開しました。

🔍注目ポイント

外部のレッドチームによる評価や、OpenAIのPreparedness Frameworkに基づくフロンティアリスク評価を実施した点が特徴です。

🔮これからどうなる

AIモデルの安全性と信頼性に関する透明性が高まり、ユーザーはより安心してAIを利用できるようになります。

このシステムカードは、OpenAIが新しいAIモデルを公開する前に実施する包括的な安全対策の概要を示しています。
外部専門家による脆弱性特定や、潜在的なリスクの評価を通じて、モデルの安全性を確保する取り組みが強調されています。
Hugging Face Blog ★4 LLM EN

Googleが新しいビジョン言語モデル「PaliGemma 2」を発表

要約を読む要約を閉じる
📰ニュース

Googleが画像とテキストを理解する新しいビジョン言語モデル「PaliGemma 2」を公開しました。

🔍注目ポイント

PaliGemma 2は、画像認識とテキスト生成を統合し、多様な視覚タスクに対応できる高性能なモデルです。

🔮これからどうなる

開発者は、より高度な画像理解AIを容易に構築できるようになり、新しいアプリケーション開発が加速するでしょう。

PaliGemma 2は、GoogleのGemmaファミリーに属するオープンモデルで、研究者や開発者が自由に利用できます。
画像キャプション生成、視覚的質問応答、オブジェクト検出など、幅広い視覚言語タスクで優れた性能を発揮します。
既存のPaliGemmaモデルをさらに進化させたものです。
Hugging Face Blog ★3 LLM EN

LLMは間違いをどの程度修正できるか?KerasとTPUを用いたチャットボットアリーナ実験

要約を読む要約を閉じる
📰ニュース

LLMが自身の誤りを修正する能力について、KerasとTPUを用いたチャットボットアリーナで実験が行われました。

🔍注目ポイント

LLMの自己修正能力を評価するため、特定のフレームワークとハードウェア環境下での具体的な実験手法が示されています。

🔮これからどうなる

LLMの信頼性と実用性が向上し、より正確で有用なAIアシスタントの実現に貢献する可能性があります。

この実験は、LLMが生成した回答の誤りを認識し、それを修正するプロセスを検証することを目的としています。
KerasとTPUを使用することで、効率的なモデルのトレーニングと評価が可能となり、大規模な言語モデルの挙動を詳細に分析できます。
これにより、将来のLLM開発における改善点が明らかになることが期待されます。