新着ニュース

24302件
Hugging Face Blog ★4 LLM EN

Hugging Face TransformersとAWS InferentiaでBERT推論を高速化

要約を読む要約を閉じる
📰ニュース

Hugging Face TransformersとAWS Inferentiaを組み合わせ、BERT推論を大幅に高速化しました。

🔍注目ポイント

AWS Inferentia専用のコンパイラと最適化により、低コストで高スループットな推論を実現しています。

🔮これからどうなる

企業はBERTモデルの運用コストを削減し、リアルタイムに近い応答速度でサービス提供が可能になります。

AWS Inferentiaは、機械学習推論に特化したAWS製のチップです。
Hugging Face Transformersライブラリは、このInferentiaの性能を最大限に引き出すための最適化を施されており、既存のBERTモデルを簡単にデプロイできます。
これにより、推論コストを最大70%削減し、スループットを2.3倍向上させることが可能になります。
Hugging Face Blog ★3 研究 EN

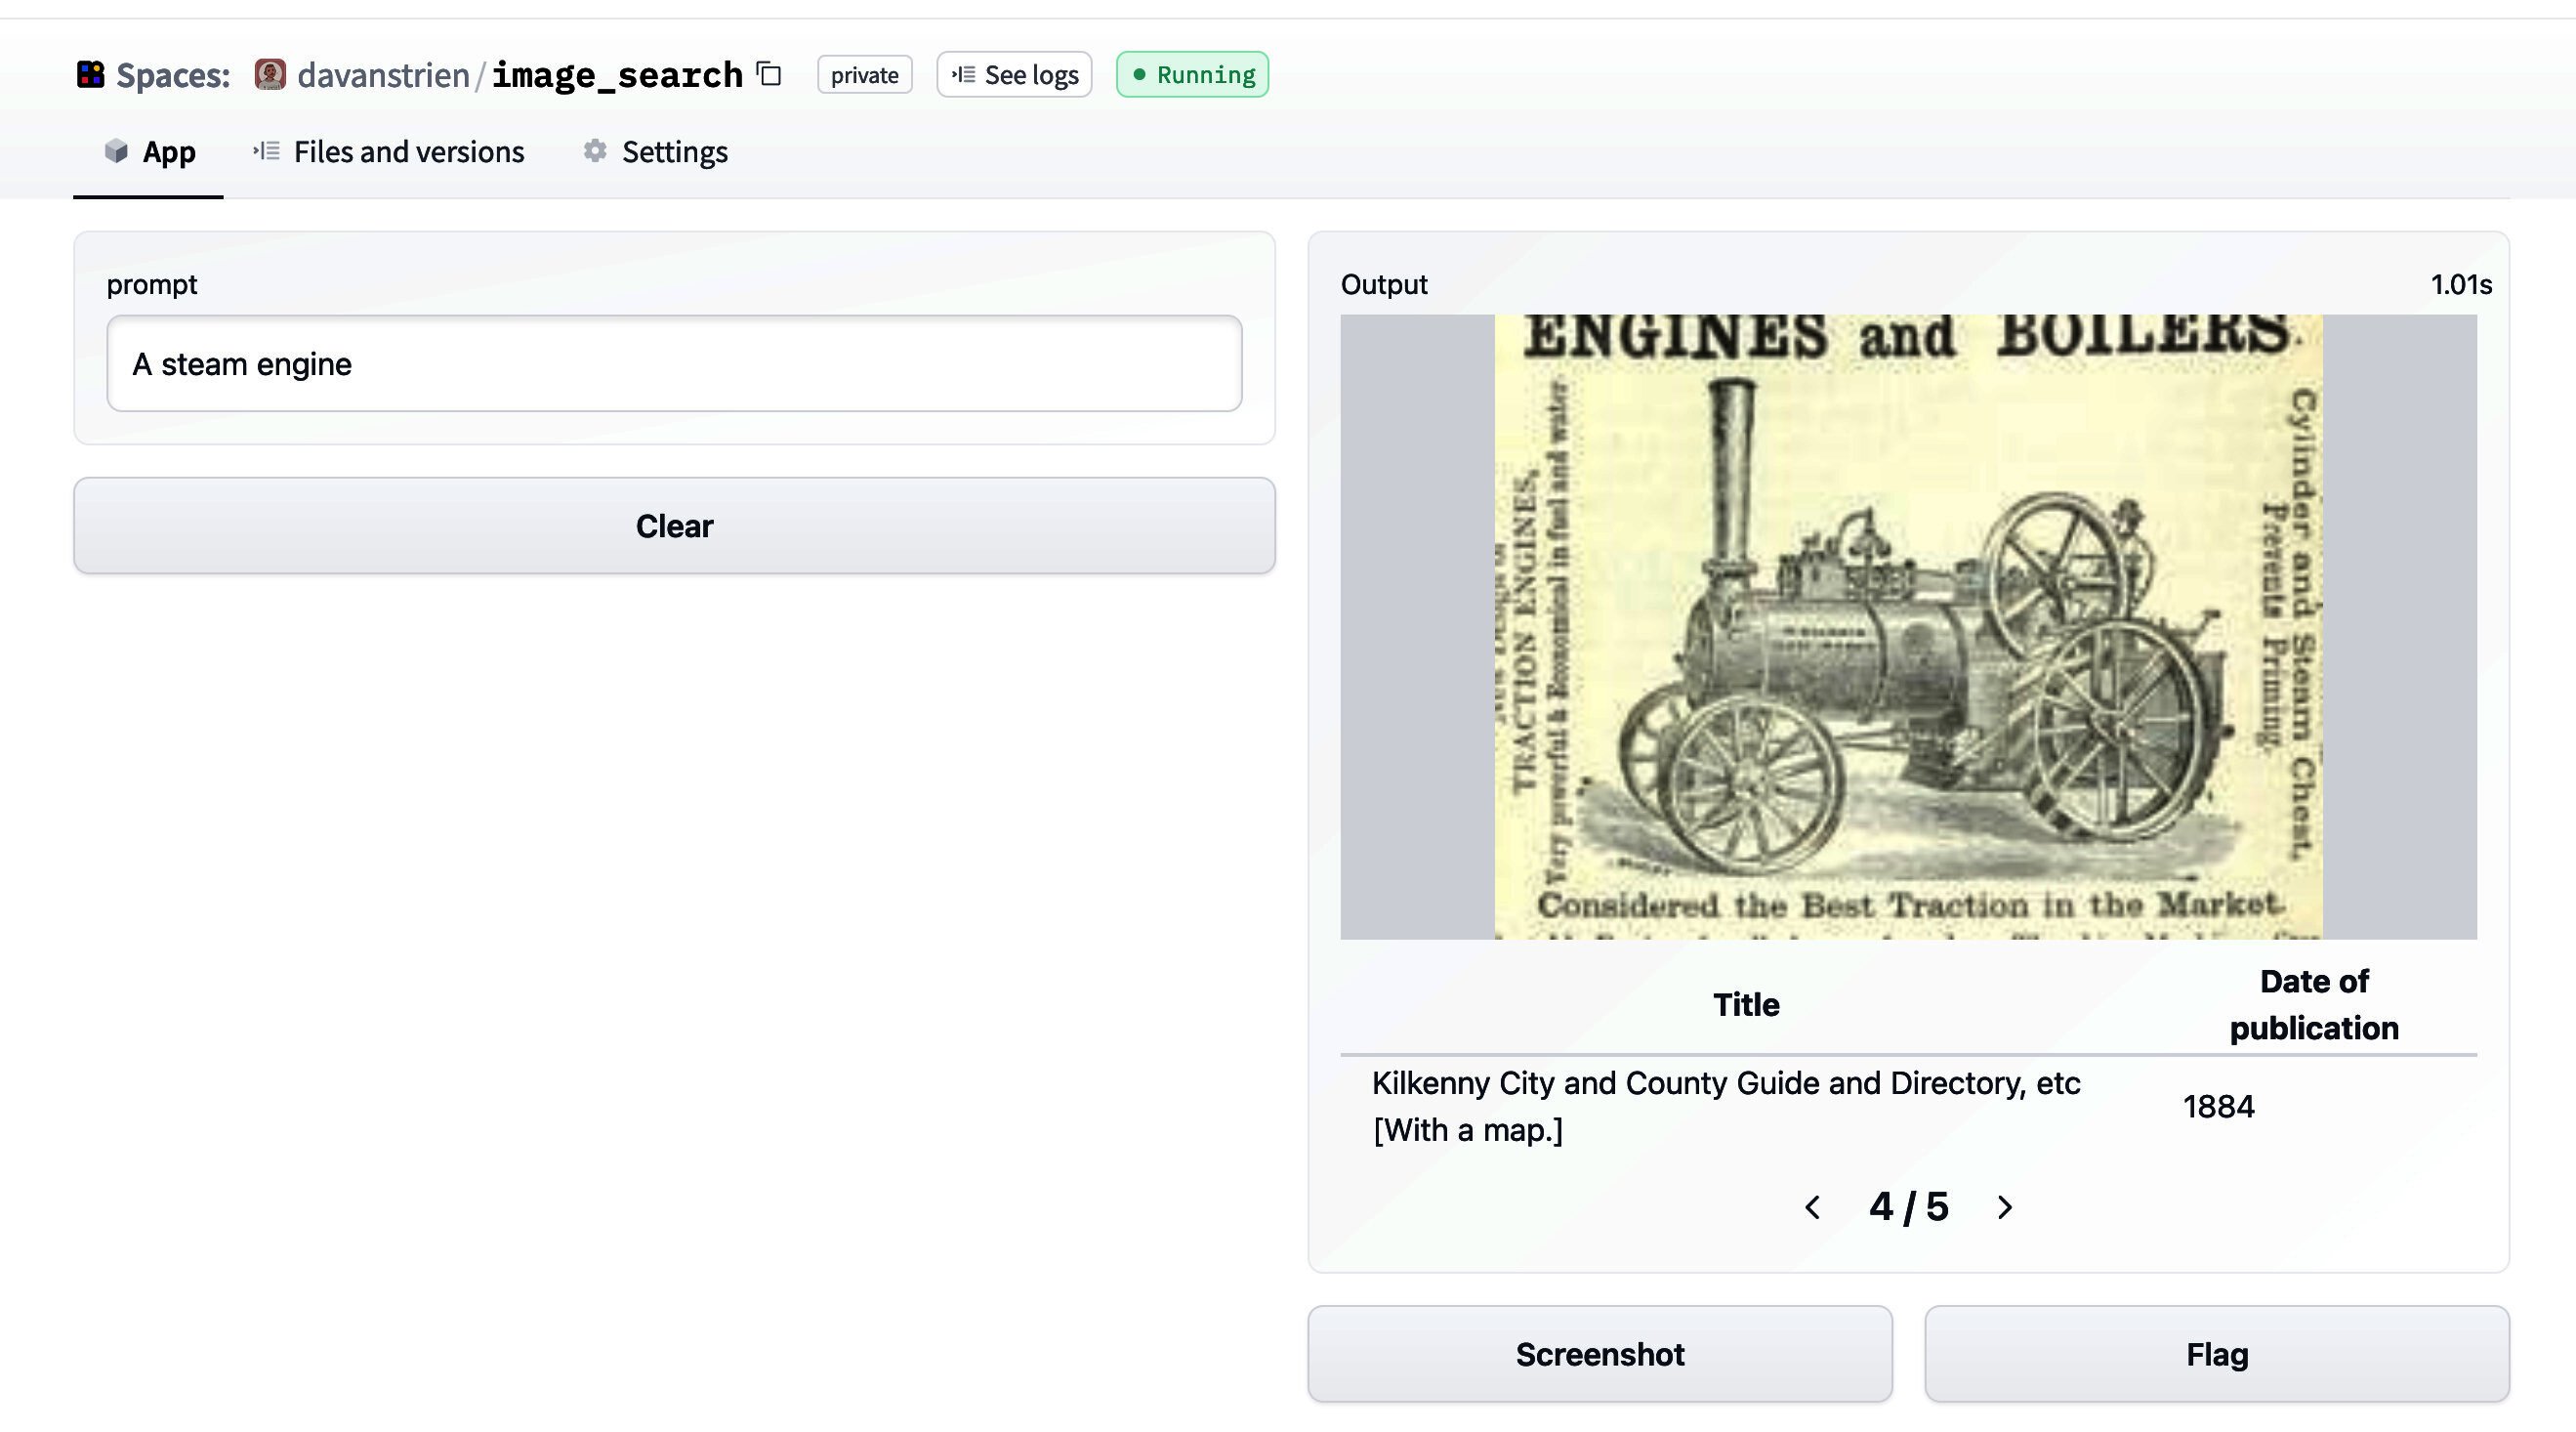
🤗データセットを使った画像検索

要約を読む要約を閉じる
📰ニュース

Hugging Faceが画像検索機能を🤗datasetsライブラリに統合しました。

🔍注目ポイント

FAISSとCLIPモデルを活用し、テキストや画像による効率的な類似画像検索を実現しています。

🔮これからどうなる

開発者は大規模な画像データセットから関連画像を素早く見つけられるようになります。

この新機能は、Hugging Faceの🤗datasetsライブラリに組み込まれており、ユーザーは既存のデータセットに対して簡単に画像検索を実行できます。
特に、FAISSによる高速なインデックス作成と、CLIPモデルによるテキスト・画像間の意味的類似度計算が特徴です。
これにより、データセットの探索やキュレーションが大幅に効率化されます。
OpenAI Blog ★4 LLM EN

GPT-3の新機能:編集と挿入

要約を読む要約を閉じる
📰ニュース

OpenAIがGPT-3とCodexに既存テキストの編集・挿入機能を追加しました。

🔍注目ポイント

これまでのテキスト補完だけでなく、既存の文章を直接修正したり、間に新しい内容を挿入できるようになりました。

🔮これからどうなる

ユーザーはより柔軟にテキストを操作でき、コンテンツ作成やコード生成の効率が向上します。

OpenAIは、GPT-3とCodexの新しいバージョンをリリースしました。
これにより、モデルは単に既存のテキストを補完するだけでなく、指定されたテキストに対して編集や挿入を行うことが可能になります。
この機能は、よりインタラクティブなテキスト操作を可能にし、様々なアプリケーションでの活用が期待されます。
Hugging Face Blog ★4 LLM EN

Hugging Face Transformersにおける制約付きビームサーチによるテキスト生成のガイド

要約を読む要約を閉じる
📰ニュース

Hugging Face Transformersライブラリに制約付きビームサーチ機能が追加されました。

🔍注目ポイント

特定の単語やフレーズの出現を強制・禁止することで、生成テキストを制御できます。

🔮これからどうなる

より意図に沿った、高品質なテキスト生成が可能になり、多様な応用が期待されます。

この新機能は、生成されるテキストに特定の制約(例:特定のキーワードを含める、特定の単語を避ける)を設けることを可能にします。
これにより、従来のビームサーチでは難しかった、より精密なテキスト生成制御が実現します。
例えば、特定のフォーマットに従う必要がある文書や、特定の情報を必ず含める必要がある要約などに活用できます。
OpenAI Blog ★4 LLM EN

コード生成モデルの経済的影響を評価するための研究課題

要約を読む要約を閉じる
📰ニュース

OpenAIがコード生成モデルの経済的影響を評価する研究アジェンダを発表しました。

🔍注目ポイント

AIによるコード生成が労働市場や生産性に与える影響を多角的に分析する枠組みを提示しています。

🔮これからどうなる

開発者や企業は、AIによるコード生成の導入戦略をより適切に計画できるようになります。

このアジェンダは、コード生成モデルが労働市場、生産性、イノベーションに与える影響を理解するための研究を促進することを目的としています。
具体的には、開発者の生産性向上、新規市場の創出、既存職務の変化などを評価するフレームワークを提案しています。
経済学者や政策立案者、AI開発者が協力して、これらのモデルの広範な影響を測定し、理解するための研究を進めることが重要だと強調されています。
OpenAI Blog ★4 LLM EN

OpenAIにおける経済影響研究

要約を読む要約を閉じる
📰ニュース

OpenAIが大規模言語モデルの経済的影響に関する研究提案を募集している。

🔍注目ポイント

LLMが労働市場や産業構造に与える具体的な影響を多角的に分析する。

🔮これからどうなる

政策立案者や企業がAIの未来に備えるための重要な知見が得られる。

OpenAIは、大規模言語モデル(LLM)が経済に与える影響について、外部の研究者からの提案を募っている。
これは、LLMの急速な発展が労働市場、生産性、産業構造、所得格差などにどのような変化をもたらすかを深く理解することを目的としている。
研究結果は、AI技術の健全な発展と社会への適応を促すための政策提言や戦略策定に役立つと期待されている。
OpenAI Blog ★4 LLM EN

言語モデルの安全性と誤用に関する教訓

要約を読む要約を閉じる
📰ニュース

OpenAIが言語モデルの安全性と誤用対策に関する最新の知見を公開しました。

🔍注目ポイント

AI開発者が展開モデルの安全性と誤用に対処するための具体的な教訓が共有されています。

🔮これからどうなる

他のAI開発者がより安全なAIシステムを構築し、社会的なリスクを低減するのに役立ちます。

OpenAIは、言語モデルの展開において直面した課題と、それに対する対策を詳細に説明しています。
これは、AI技術が社会に浸透する中で、倫理的かつ安全な利用を促進するための重要なステップです。
特に、悪用防止やバイアス軽減に焦点を当てています。
Hugging Face Blog ★5 LLM EN

BERT 101 - 最先端のNLPモデルを解説

要約を読む要約を閉じる
📰ニュース

Googleが開発したBERTは、自然言語処理の事前学習モデルです。

🔍注目ポイント

双方向の文脈を捉えるTransformerアーキテクチャにより、文脈理解が飛躍的に向上しました。

🔮これからどうなる

様々なNLPタスクの精度を向上させ、多くのAIアプリケーション開発を加速させました。

BERTは「Bidirectional Encoder Representations from Transformers」の略で、単語の前後関係を同時に学習します。
これにより、従来の単方向モデルでは難しかった曖昧な表現の理解も可能になりました。
事前学習済みモデルとして公開され、ファインチューニングによって多様なタスクに適用できます。
Hugging Face Blog ★4 研究 EN

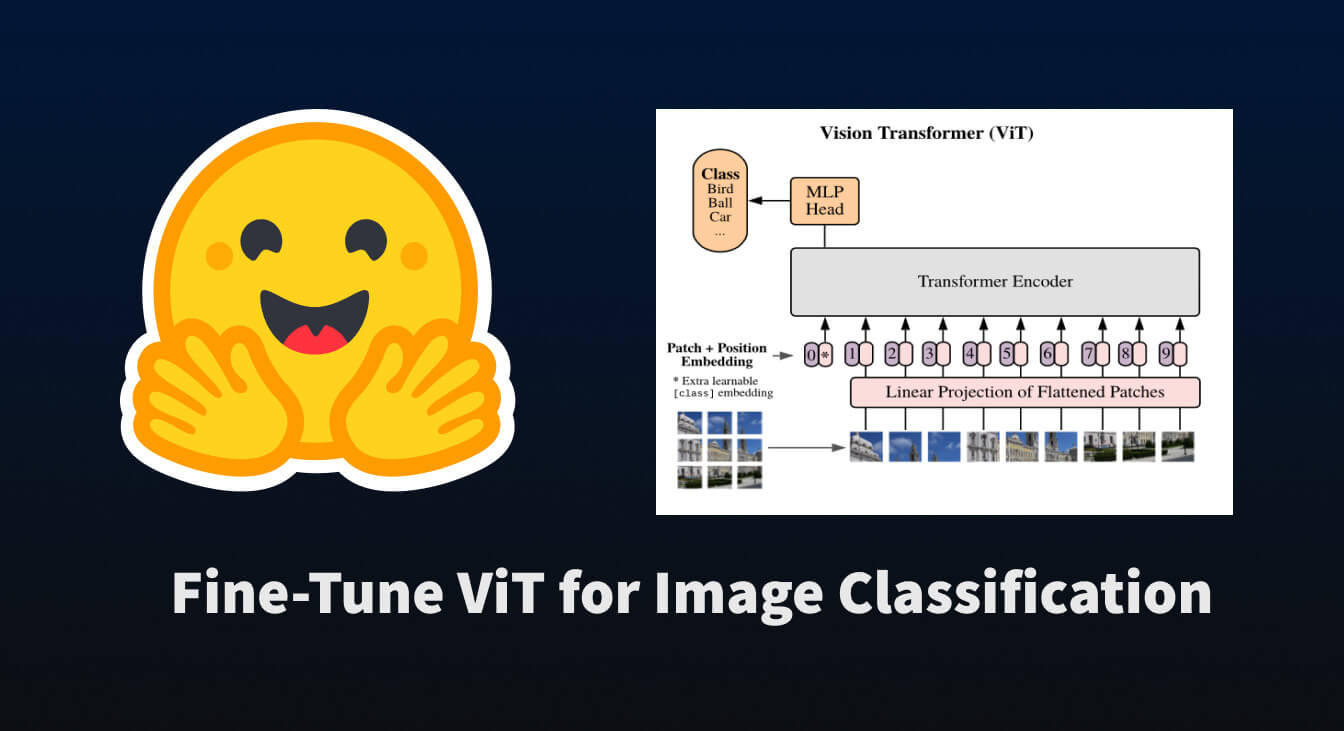
Hugging Face TransformersでViTを画像分類用にファインチューニング

要約を読む要約を閉じる
📰ニュース

Hugging Face Transformersライブラリを使って、Vision Transformer(ViT)を画像分類タスク用にファインチューニングする方法が紹介されました。

🔍注目ポイント

事前学習済みViTモデルをカスタムデータセットで効率的に再学習させ、高い精度で画像分類を行う技術が解説されています。

🔮これからどうなる

開発者は複雑なモデル構築なしに、最先端の画像分類モデルを簡単に利用・応用できるようになります。

Vision Transformer(ViT)は、Transformerアーキテクチャを画像認識に適用したモデルで、高い性能を示します。
Hugging Face Transformersは、このような大規模モデルの利用を容易にするライブラリです。
この記事では、具体的なコード例を交えながら、ViTのファインチューニング手順を詳細に解説しています。
OpenAI Blog ★4 LLM EN

一部の数学オリンピック形式問題を解くAI

要約を読む要約を閉じる
📰ニュース

OpenAIがLean用のニューラル定理証明器を開発し、数学オリンピック形式の難問を解くことに成功しました。

🔍注目ポイント

AMC12やAIME、IMO由来の問題を解ける高い推論能力を持つ定理証明AIが開発されました。

🔮これからどうなる

数学研究や教育、AIによる形式的証明の自動化に大きな進展をもたらす可能性があります。

OpenAIは、形式的証明言語Lean上で動作するニューラル定理証明器を構築しました。
このAIは、高校レベルの数学オリンピック問題(AMC12、AIME、IMO)を解く能力を示し、特に形式的な数学的推論において高い性能を発揮しています。
これは、AIが複雑な数学的問題を理解し、解決する能力の向上を示唆しています。
Hugging Face Blog ★3 LLM EN

Pythonで感情分析を始める

要約を読む要約を閉じる
📰ニュース

PythonとHugging FaceのTransformersライブラリを使って感情分析を行う方法が解説されました。

🔍注目ポイント

事前学習済みモデルを活用することで、少ないコードで高精度な感情分析を実装できる点が優れています。

🔮これからどうなる

開発者はテキストデータからユーザーの感情を効率的に把握し、サービス改善やマーケティングに活用できます。

感情分析は、テキストがポジティブかネガティブか、あるいは中立かを判断する自然言語処理の一分野です。
Hugging FaceのTransformersライブラリは、BERTやRoBERTaなどの強力なモデルを簡単に利用できるため、初心者でも高度な感情分析を実装できます。
Pythonのシンプルなコード例を通じて、モデルのロードから予測までの一連の流れが紹介されています。
Hugging Face Blog ★4 LLM EN

Hugging Face TransformersのWav2Vec2で大規模ファイルの自動音声認識を実現

要約を読む要約を閉じる
📰ニュース

Hugging Face TransformersのWav2Vec2モデルを使い、大規模な音声ファイルの自動音声認識(ASR)を効率的に行う方法が紹介されました。

🔍注目ポイント

Wav2Vec2は自己教師あり学習により大量の音声データから特徴を学習し、高精度なASRを可能にする点が技術的ポイントです。

🔮これからどうなる

開発者は大規模な音声データでも効率的に文字起こしが可能になり、音声関連アプリケーションの開発が加速します。

従来のASRシステムでは、長い音声ファイルを処理する際にメモリや計算リソースの制約がありましたが、Wav2Vec2とTransformersライブラリの組み合わせにより、これらの課題が克服されました。
特に、ストリーミング処理やバッチ処理の最適化により、リアルタイムに近い形での大規模ファイル処理が可能になります。
この技術は、ポッドキャストの文字起こしや会議録作成など、多岐にわたる応用が期待されます。