研究

5299件
Hugging Face Blog ★4 LLM EN

Big Bench Audioによる音声推論の評価

要約を読む要約を閉じる
📰ニュース

Hugging Faceが音声推論能力を評価するベンチマーク「Big Bench Audio」を発表しました。

🔍注目ポイント

このベンチマークは、音声データから複雑な推論を行うAIモデルの性能を客観的に測定します。

🔮これからどうなる

音声AIモデルの開発者は、より高度な推論能力を持つシステムを構築できるようになります。

Big Bench Audioは、音声認識だけでなく、音声に含まれる意味や文脈を理解し、推論する能力に焦点を当てています。
これにより、単なる文字起こしを超えた、より人間らしい音声理解が期待されます。
Hugging Faceは、AIコミュニティがこのベンチマークを活用し、音声AIの進化を加速させることを目指しています。
Hugging Face Blog ★4 LLM EN

ついにBERTの後継が登場:ModernBERTの紹介

要約を読む要約を閉じる
📰ニュース

Hugging Faceが、GoogleのBERTを上回る性能を持つ新しい言語モデル「ModernBERT」を発表しました。

🔍注目ポイント

ModernBERTは、BERTと同じアーキテクチャながら、より効率的な事前学習とデータセットの最適化により性能を向上させています。

🔮これからどうなる

自然言語処理の多くのタスクでより高精度なモデルが利用可能になり、AIアプリケーションの性能向上に貢献します。

BERTは2018年に登場し、自然言語処理分野に大きな影響を与えましたが、ModernBERTはその後継として期待されています。
特に、既存のBERTベースのシステムをアップグレードする際の互換性が考慮されており、移行が容易になるよう設計されています。
Hugging Face Blog ★4 LLM EN

Bamba: 推論効率の高いハイブリッドMamba2モデル

要約を読む要約を閉じる
📰ニュース

Mamba2をベースにした推論効率の高いハイブリッドモデル「Bamba」が発表されました。

🔍注目ポイント

Mamba2とTransformerの利点を組み合わせ、推論時の計算量を大幅に削減しています。

🔮これからどうなる

より高速で低コストなAIモデルの利用が可能になり、様々なアプリケーション開発が加速するでしょう。

Bambaは、Mamba2のシーケンス処理能力とTransformerの並列処理能力を融合させた新しいアーキテクチャを採用しています。
これにより、特に長いシーケンスの処理において、従来のモデルよりも少ない計算資源で高い性能を発揮します。
Hugging Face Blogで詳細が公開され、AIコミュニティからの注目を集めています。
Hugging Face Blog ★4 研究 EN

合成データジェネレーターの紹介 - 自然言語でデータセットを構築

要約を読む要約を閉じる
📰ニュース

Hugging Faceが自然言語でデータセットを生成できる「Synthetic Data Generator」を発表しました。

🔍注目ポイント

ユーザーはプロンプトを入力するだけで、多様なデータセットを簡単に作成できます。

🔮これからどうなる

データ収集やアノテーションの手間が大幅に削減され、AI開発の効率が向上します。

このツールは、特にデータが不足している分野や、プライバシー保護が必要なケースで有用です。
開発者は、より迅速にモデルのプロトタイプを作成し、テストできるようになります。
これにより、AIモデルの多様なユースケースへの適用が加速するでしょう。
Hugging Face Blog ★3 研究 EN

LeMaterial:材料発見と研究を加速するオープンソースイニシアチブ

要約を読む要約を閉じる
📰ニュース

Hugging Faceが材料科学分野のオープンソースAIプロジェクト「LeMaterial」を発表しました。

🔍注目ポイント

材料科学のデータセット、モデル、ツールを共有し、AIによる新材料開発を加速させるのが特徴です。

🔮これからどうなる

研究者はAIを活用して新素材を効率的に発見・開発できるようになり、産業界のイノベーションを促進します。

LeMaterialは、Hugging Faceのプラットフォームを活用し、材料科学コミュニティがAIモデルやデータセットを共同で開発・共有することを目的としています。
これにより、AIと材料科学の融合が進み、持続可能な社会の実現に貢献する新素材の開発が加速されると期待されています。
Hugging Face Blog ★4 画像生成 EN

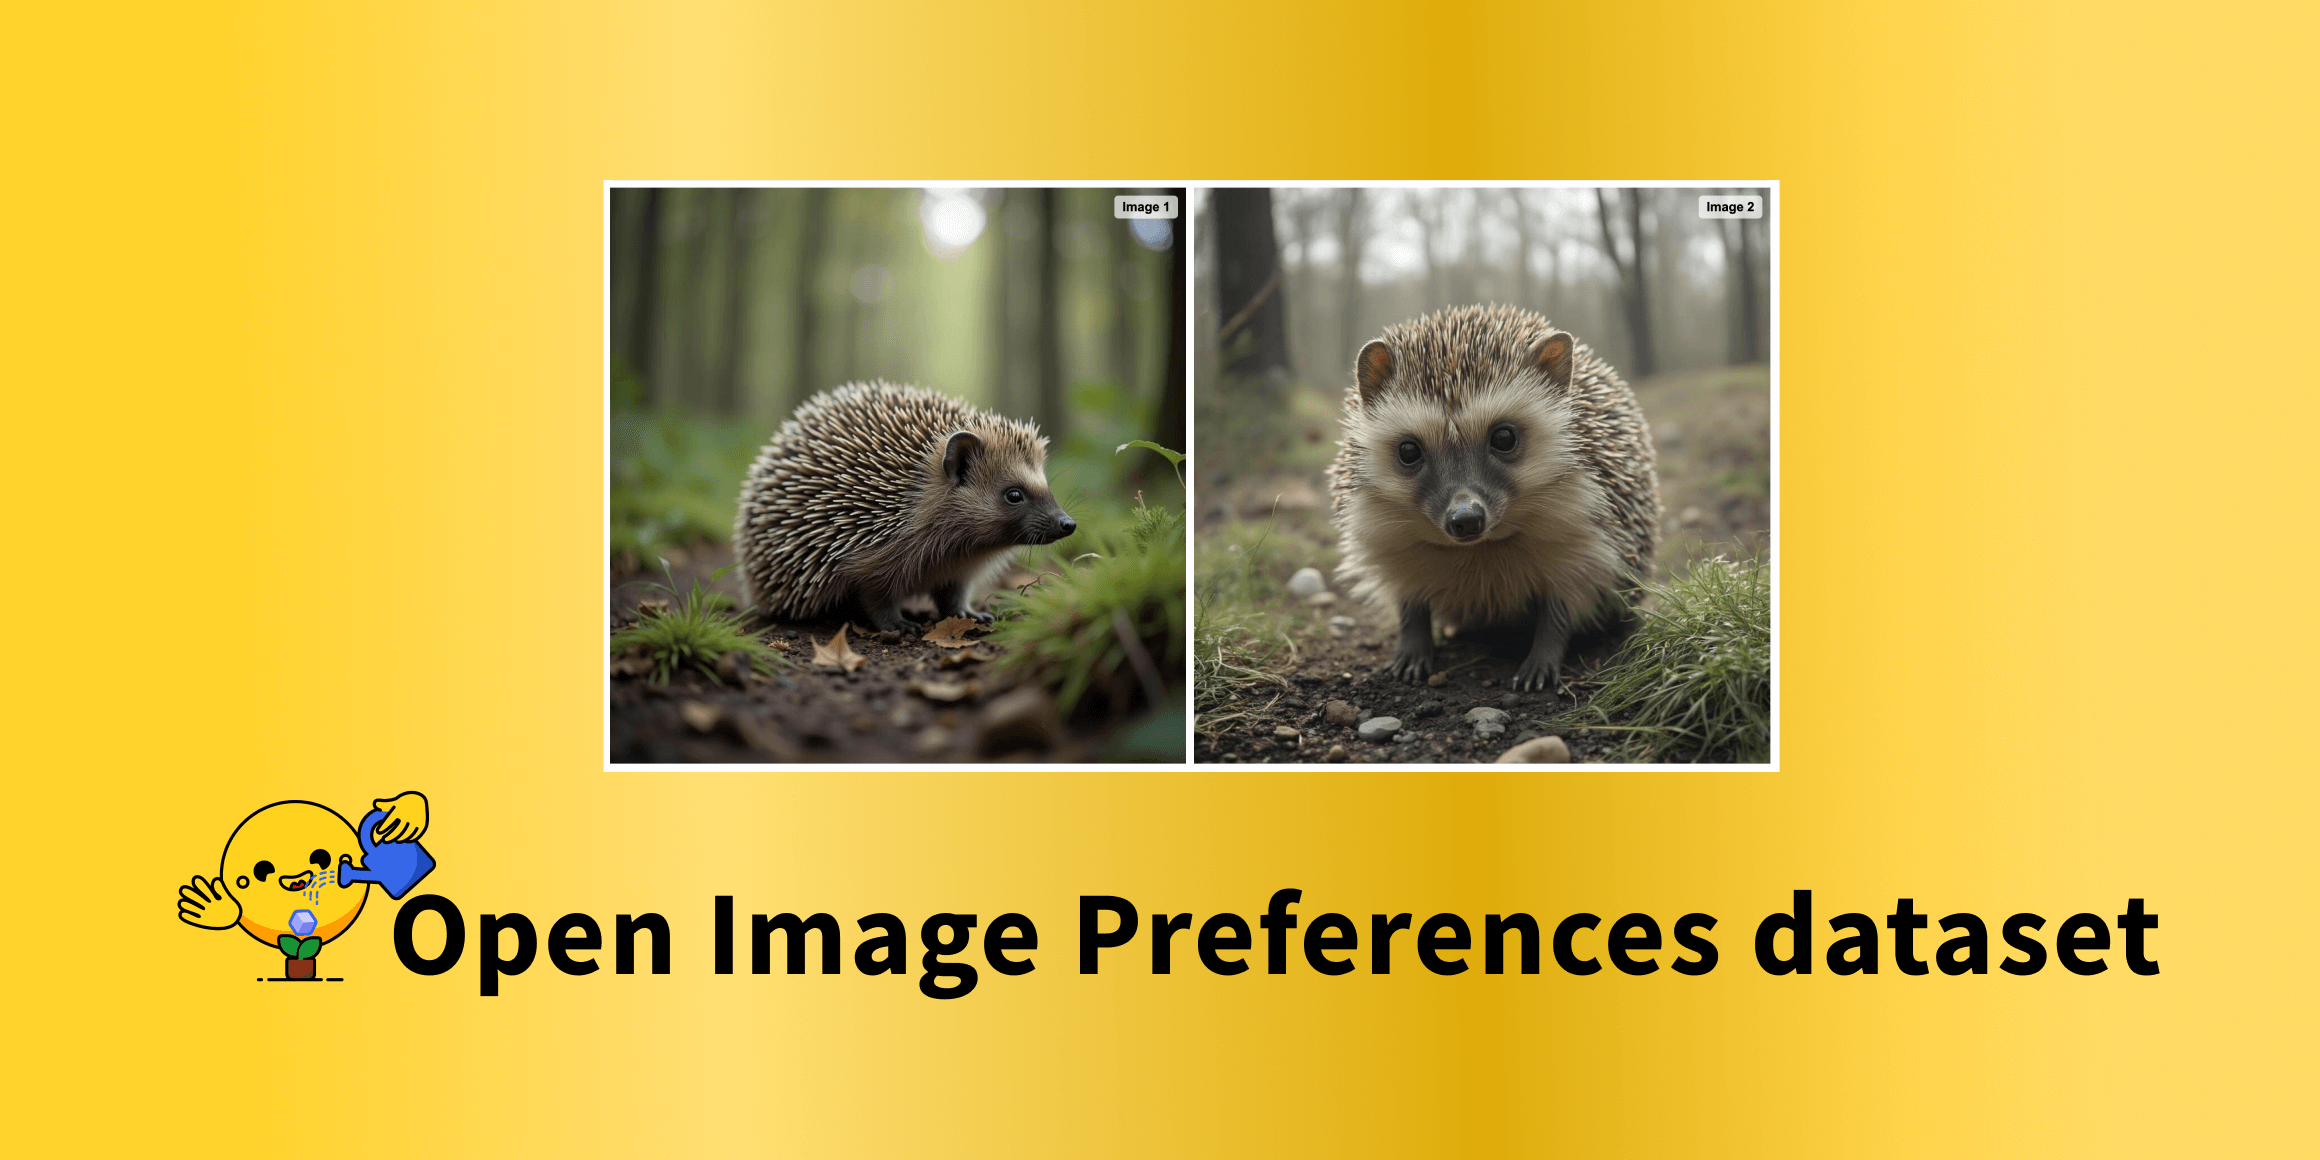
Hugging Faceコミュニティによるテキストから画像生成のためのオープンな選好データセット

要約を読む要約を閉じる
📰ニュース

Hugging Faceコミュニティがテキストから画像を生成するモデルの評価に用いるオープンな選好データセットを公開しました。

🔍注目ポイント

人間が選好した画像ペアのデータセットを公開し、モデルの性能評価と改善に役立つ透明性の高いリソースを提供します。

🔮これからどうなる

画像生成AIの品質向上と、よりユーザーの意図に沿った画像を生成するモデルの開発が加速するでしょう。

このデータセットは、ユーザーが生成された画像の中からより良いと感じた方を選択する形式で収集されました。
これにより、単なる客観的な指標だけでなく、人間の主観的な評価を反映したモデルの性能評価が可能になります。
オープンソースであるため、研究者や開発者が自由に利用し、画像生成モデルのベンチマークやファインチューニングに活用できます。
Hugging Face Blog ★4 LLM EN

Googleが新しいビジョン言語モデル「PaliGemma 2」を発表

要約を読む要約を閉じる
📰ニュース

Googleが画像とテキストを理解する新しいビジョン言語モデル「PaliGemma 2」を公開しました。

🔍注目ポイント

PaliGemma 2は、画像認識とテキスト生成を統合し、多様な視覚タスクに対応できる高性能なモデルです。

🔮これからどうなる

開発者は、より高度な画像理解AIを容易に構築できるようになり、新しいアプリケーション開発が加速するでしょう。

PaliGemma 2は、GoogleのGemmaファミリーに属するオープンモデルで、研究者や開発者が自由に利用できます。
画像キャプション生成、視覚的質問応答、オブジェクト検出など、幅広い視覚言語タスクで優れた性能を発揮します。
既存のPaliGemmaモデルをさらに進化させたものです。
Hugging Face Blog ★3 LLM EN

LLMは間違いをどの程度修正できるか?KerasとTPUを用いたチャットボットアリーナ実験

要約を読む要約を閉じる
📰ニュース

LLMが自身の誤りを修正する能力について、KerasとTPUを用いたチャットボットアリーナで実験が行われました。

🔍注目ポイント

LLMの自己修正能力を評価するため、特定のフレームワークとハードウェア環境下での具体的な実験手法が示されています。

🔮これからどうなる

LLMの信頼性と実用性が向上し、より正確で有用なAIアシスタントの実現に貢献する可能性があります。

この実験は、LLMが生成した回答の誤りを認識し、それを修正するプロセスを検証することを目的としています。
KerasとTPUを使用することで、効率的なモデルのトレーニングと評価が可能となり、大規模な言語モデルの挙動を詳細に分析できます。
これにより、将来のLLM開発における改善点が明らかになることが期待されます。
Hugging Face Blog ★4 LLM EN

3C3HによるLLM評価の再考:AraGenベンチマークとリーダーボード

要約を読む要約を閉じる
📰ニュース

Hugging FaceがLLMの評価を再考する新しいベンチマーク「AraGen」とリーダーボードを発表しました。

🔍注目ポイント

3C3Hフレームワークに基づき、LLMの複雑な推論能力と多面的な評価を可能にする点が特徴です。

🔮これからどうなる

開発者はより正確にLLMの性能を比較・改善でき、ユーザーはより信頼性の高いAIモデルを利用できるようになります。

AraGenは、従来のベンチマークがカバーしきれなかったLLMの推論能力を多角的に評価するために設計されました。
特に、複雑な質問応答や情報生成タスクにおいて、モデルの真の実力を測ることを目指しています。
この新しい評価方法は、LLMの進化をさらに加速させる可能性があります。
Hugging Face Blog ★4 LLM EN

パフォーマンスへの投資:LLMの洞察で小型モデルをファインチューニング - CFM事例研究

要約を読む要約を閉じる
📰ニュース

Hugging FaceがLLMの洞察を活用し、小型モデルの性能を向上させる手法を発表しました。

🔍注目ポイント

大規模言語モデル(LLM)の知識を小型モデルに転移させ、効率的なファインチューニングを実現します。

🔮これからどうなる

企業はコストを抑えつつ、高性能なAIモデルを開発・運用できるようになります。

この手法は、特にリソースが限られた環境や、特定のタスクに特化したモデルが必要な場合に有効です。
LLMの高度な理解力を小型モデルに注入することで、より少ない計算資源で同等以上の性能を引き出すことが可能になります。
Hugging Faceは、このアプローチを「CFMケーススタディ」として紹介しています。
Hugging Face Blog ★4 LLM EN

SmolVLM - 小さくても強力な視覚言語モデル

要約を読む要約を閉じる
📰ニュース

Hugging Faceが、小型ながら高性能な視覚言語モデル「SmolVLM」を発表しました。

🔍注目ポイント

SmolVLMは、既存の大型モデルに匹敵する性能を、はるかに少ないパラメータ数で実現しています。

🔮これからどうなる

リソースが限られたデバイスでも高度な画像理解が可能になり、AIの普及を加速させます。

このモデルは、効率的なアーキテクチャと学習手法により、推論コストを大幅に削減しつつ、多様な視覚タスクで高い精度を発揮します。
特にモバイルデバイスやエッジAIでの活用が期待されており、より多くのアプリケーションへのAI統合を促進するでしょう。
Hugging Face Blog ★4 LLM EN

最先端のTransformer位置エンコーディングを自分で設計できた可能性

要約を読む要約を閉じる
📰ニュース

Transformerモデルにおける位置エンコーディングの重要性と、その設計原理について解説されています。

🔍注目ポイント

Transformerが持つ位置情報を扱えないという課題に対し、相対位置エンコーディングが有効な解決策となることを示しています。

🔮これからどうなる

AIモデル開発者は、より効率的で高性能なTransformerモデルを設計するための理解を深められます。

Transformerは並列処理に優れる一方で、入力シーケンス内のトークンの順序情報を直接扱えません。
このため、位置エンコーディングを導入して、各トークンの相対的な位置関係をモデルに伝える必要があります。
記事では、様々な位置エンコーディング手法の進化と、その背後にある数学的・直感的なアイデアが分かりやすく説明されています。