研究

5297件
Hugging Face Blog ★4 LLM EN

Mixture of Experts (MoE) 解説

要約を読む要約を閉じる
📰ニュース

大規模言語モデルの効率と性能を向上させるMixture of Experts (MoE) アーキテクチャが注目されています。

🔍注目ポイント

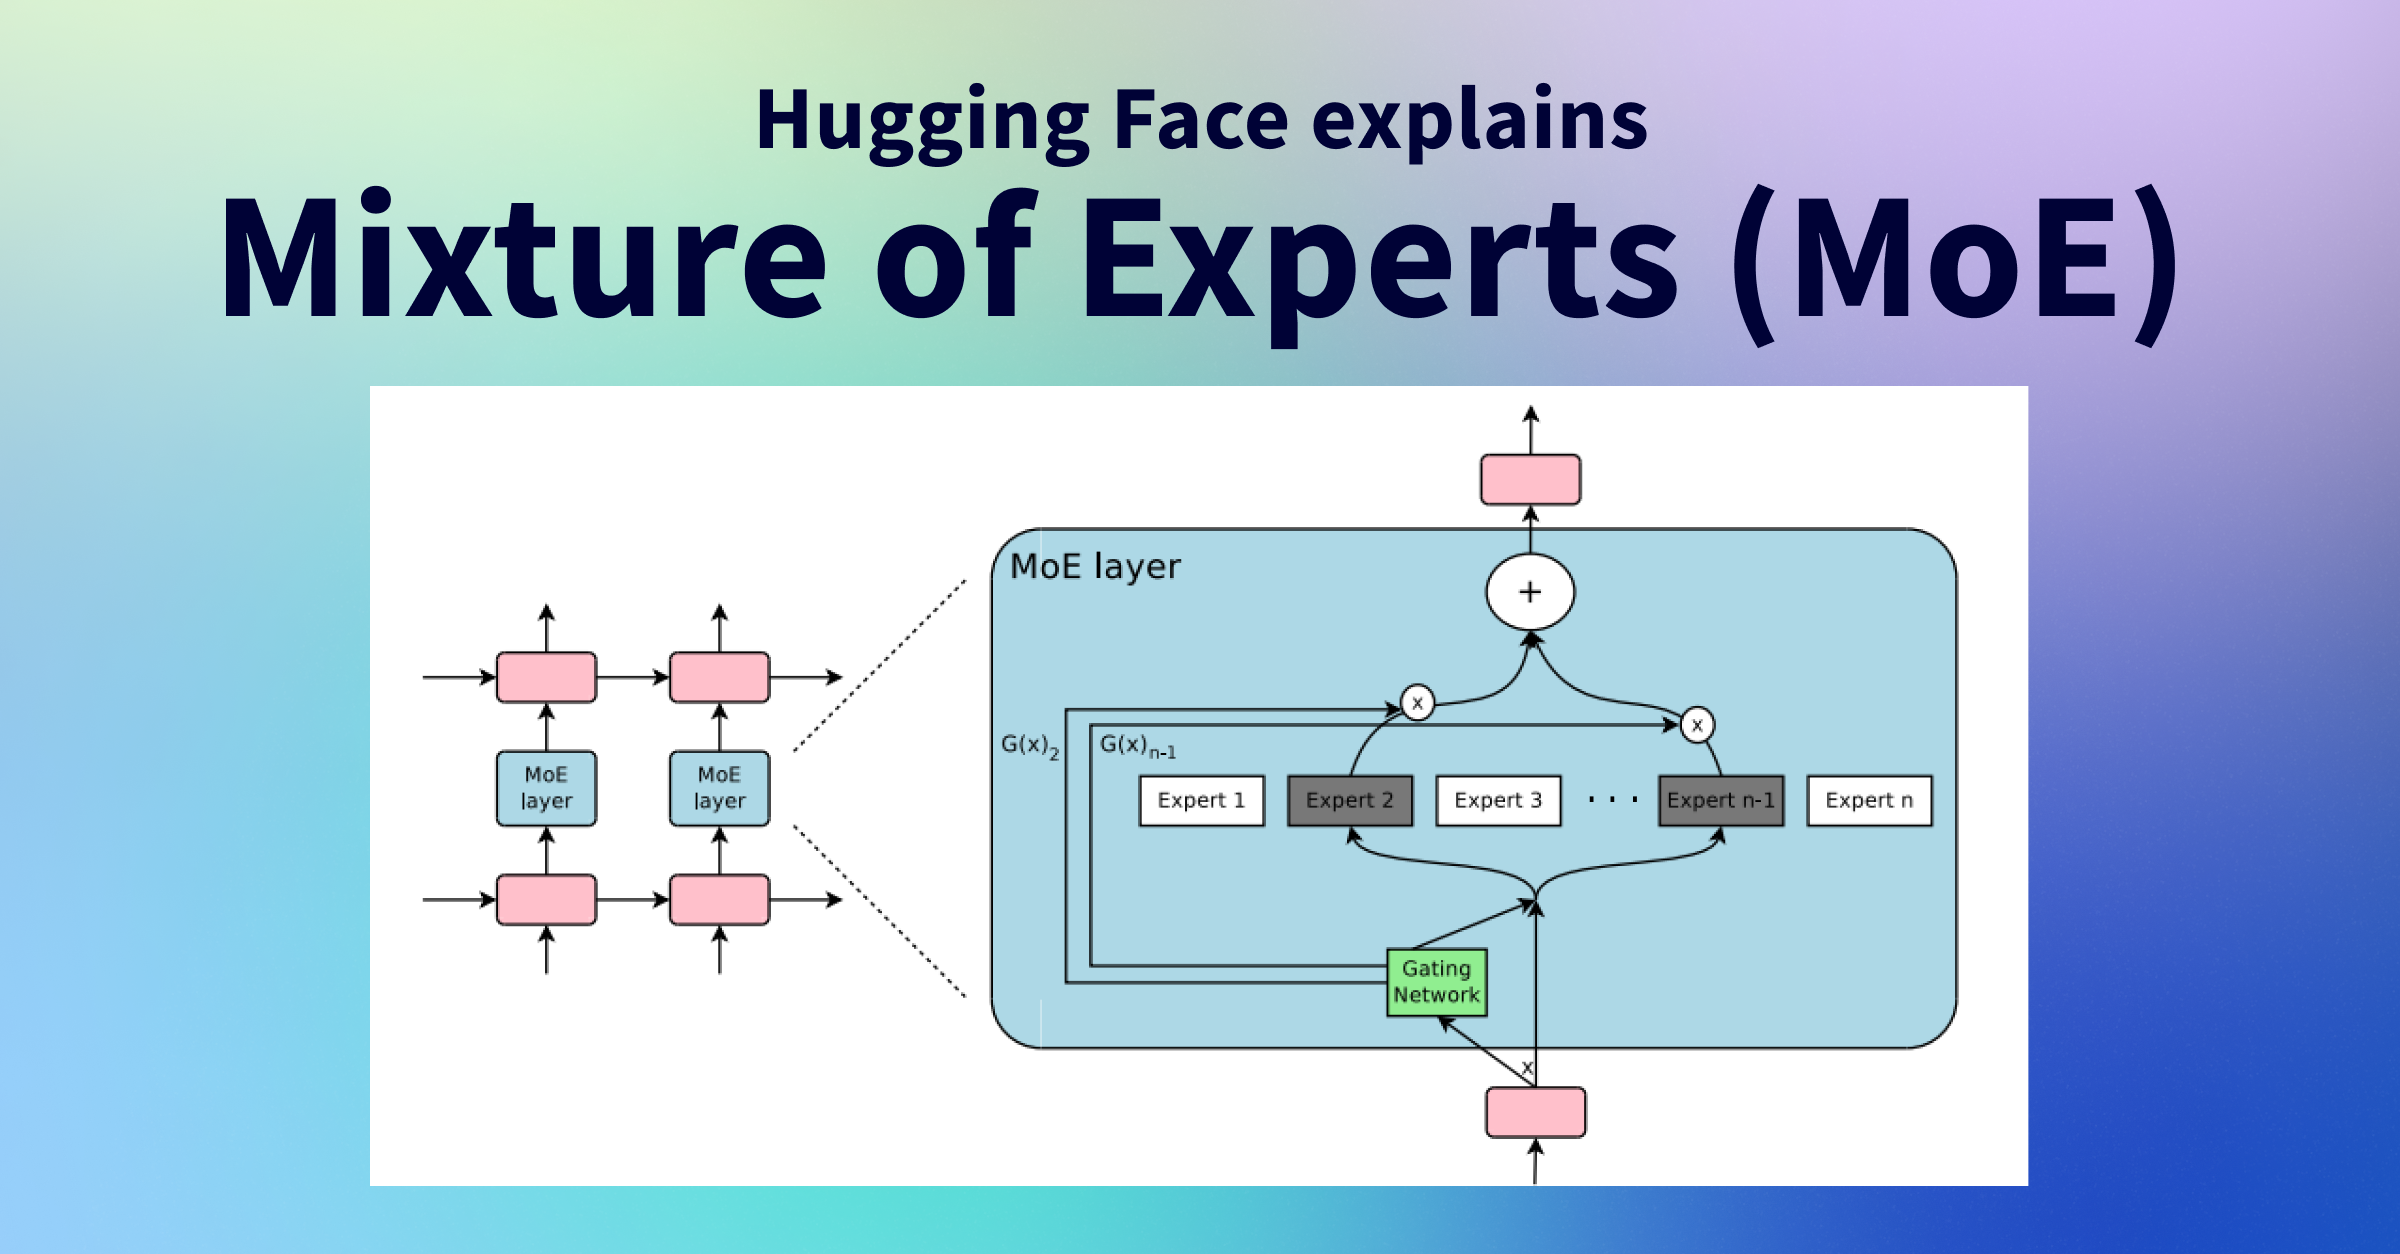
MoEは、複数の専門家(エキスパート)ネットワークから特定の入力に最適なものを選択し、計算コストを抑えつつ高い性能を実現します。

🔮これからどうなる

より大規模で高性能なAIモデルが、より少ない計算リソースで開発・運用できるようになり、AIの普及を加速させます。

MoEは、各入力トークンに対して少数のエキスパートのみを活性化させることで、モデル全体のパラメータ数は多いものの、実際に使用される計算量は削減されます。
これにより、トレーニングと推論の効率が向上し、より大きなモデルの構築が可能になります。
特にLLMの分野で、GPT-4やMixtral 8x7Bなどで採用され、その有効性が示されています。
Hugging Face Blog ★4 LLM EN

SetFitABSA: SetFitを用いたFew-Shotアスペクトベース感情分析

要約を読む要約を閉じる
📰ニュース

SetFitを応用し、少ないデータで特定のアスペクトに対する感情を分析する手法が開発されました。

🔍注目ポイント

SetFitの効率的なFew-Shot学習能力を活かし、アスペクトベース感情分析の精度を向上させています。

🔮これからどうなる

企業は顧客レビューから製品の特定機能に対する感情を効率的に把握できるようになります。

アスペクトベース感情分析(ABSA)は、文中の特定のアスペクト(例:スマートフォンのバッテリー)に対する感情を識別するタスクです。
従来のABSAモデルは大量のラベル付きデータを必要としましたが、SetFitABSAはSetFitのFew-Shot学習能力を活用することで、この課題を克服しました。
これにより、少ないデータで高精度なABSAが可能になります。
Hugging Face Blog ★4 LLM EN

コールドブートにさようなら - LoRA推論を300%高速化する方法

要約を読む要約を閉じる
📰ニュース

Hugging FaceがLoRAモデルの推論速度を300%向上させる技術を開発しました。

🔍注目ポイント

LoRAモデルの重みロードと推論を最適化し、コールドスタート時の遅延を大幅に削減しました。

🔮これからどうなる

LoRAモデルを利用するAIアプリケーションの応答性が向上し、ユーザー体験が改善されます。

LoRA(Low-Rank Adaptation)は、大規模言語モデルなどのファインチューニングに広く使われる技術です。
これまでは、新しいLoRAモデルをロードする際に発生する「コールドブート」と呼ばれる遅延が課題でした。
Hugging Faceは、この遅延を解消するための最適化を行い、推論の効率を大幅に向上させました。
Hugging Face Blog ★4 LLM EN

Open LLM Leaderboard: DROPデータセットの深掘り

要約を読む要約を閉じる
📰ニュース

Hugging FaceのOpen LLM LeaderboardにおけるDROPデータセットの評価方法と課題が解説されました。

🔍注目ポイント

DROPは複雑な推論を要する読解データセットで、LLMの多段階推論能力を測るのに適しています。

🔮これからどうなる

LLM開発者は、より高度な推論能力を持つモデルを開発するための具体的な課題と方向性を理解できます。

DROPデータセットは、質問応答タスクにおいて、テキストから直接抽出するだけでなく、複数の情報を統合し、計算や比較を行う複雑な推論を必要とします。
Hugging Faceのリーダーボードでは、このDROPデータセットを用いてLLMの性能を評価しており、モデルが単なるキーワードマッチングではなく、真の理解と推論を行えているかを測る重要な指標となっています。
しかし、DROPの評価には限界もあり、より多角的な評価の必要性も指摘されています。
OpenAI Blog ★4 LLM EN

OpenAIデータパートナーシップ

要約を読む要約を閉じる
📰ニュース

OpenAIがAIトレーニング用のオープンソースおよびプライベートデータセット作成のため、企業と提携を開始しました。

🔍注目ポイント

AIモデルの性能向上に不可欠な高品質で多様なデータセットを、外部パートナーと協力して構築する点です。

🔮これからどうなる

より高性能で汎用性の高いAIモデルが開発され、様々な産業や研究分野でのAI活用が加速するでしょう。

OpenAIは、AIモデルのトレーニングに必要なデータの質と量を向上させるため、データパートナーシッププログラムを立ち上げました。
このプログラムでは、企業や組織が持つ独自のデータを提供してもらい、それをAIトレーニングに活用することで、より高度なAIモデルの開発を目指します。
オープンソースとプライベートの両方のデータセットを対象としています。
Hugging Face Blog ★4 画像生成 EN

Latent Consistency LoRAでSDXLを4ステップで高速化

要約を読む要約を閉じる
📰ニュース

Latent Consistency LoRA (LC-LoRA) を用いて、SDXLモデルの画像生成ステップを大幅に削減しました。

🔍注目ポイント

LC-LoRAは、少ないステップで高品質な画像を生成できるよう、既存の拡散モデルを高速化する技術です。

🔮これからどうなる

ユーザーはより高速に高品質な画像を生成できるようになり、リアルタイムアプリケーションへの応用が期待されます。

拡散モデルは通常多くのステップを要しますが、LC-LoRAは潜在空間での一貫性を学習することで、わずか4ステップでの生成を可能にしました。
これにより、計算コストを削減しつつ、視覚的な品質を維持できます。
Hugging Faceは、この技術をSDXLに適用し、その効果を実証しました。
Hugging Face Blog ★3 LLM EN

LLMの性能比較:災害ツイート分析におけるRoberta、Llama 2、MistralとLoRAの活用

要約を読む要約を閉じる
📰ニュース

災害ツイート分析において、Roberta、Llama 2、MistralのLLM性能がLoRAを用いて比較されました。

🔍注目ポイント

LoRAを適用することで、限られたデータと計算資源でもLLMのファインチューニングが可能になる点が重要です。

🔮これからどうなる

災害時の情報分析精度が向上し、迅速な対応や支援活動に貢献する可能性があります。

本研究では、災害関連ツイートの分類タスクに焦点を当て、異なるLLM(Roberta、Llama 2、Mistral)の性能を評価しました。
特に、LoRA(Low-Rank Adaptation)という効率的なファインチューニング手法を用いることで、各モデルがどのように適応し、精度を向上させるかを検証しています。
これにより、リソースが限られた環境でも高性能なLLMを活用できる可能性が示されました。
OpenAI Blog ★4 AI倫理 EN

OpenAIのフロンティアリスクへのアプローチ

要約を読む要約を閉じる
📰ニュース

OpenAIがAIのフロンティアリスクに対する包括的なアプローチを発表しました。

🔍注目ポイント

AIの安全性と能力向上を両立させるため、内部研究と外部協力の両面からリスクを管理します。

🔮これからどうなる

AI開発企業や政策立案者が、より安全なAIシステムを構築・規制する上での指針となります。

OpenAIは、AIの能力が人類に壊滅的な損害を与える可能性のある「フロンティアリスク」を認識し、その管理に注力しています。
これには、モデルの安全性評価、悪用防止策、そして国際的な協力体制の構築が含まれます。
英国AI安全サミットに向けて、このアプローチが更新されました。
OpenAI Blog ★4 AI倫理 EN

フロンティアリスクと備え

要約を読む要約を閉じる
📰ニュース

OpenAIは、高性能AIシステムの壊滅的なリスクに備えるため、準備チームを設立し、課題を開始しました。

🔍注目ポイント

AIの潜在的な危険性に対し、具体的な組織体制と取り組みで事前対策を講じる点が重要です。

🔮これからどうなる

AI開発の安全性向上に貢献し、将来的な社会への負の影響を軽減する可能性があります。

OpenAIは、高度なAIシステムがもたらす可能性のある壊滅的なリスク(例:誤用、制御不能)に対処するため、専門の「Preparedness team」を立ち上げました。
このチームは、リスク評価、緩和策の開発、緊急対応計画の策定などを担当します。
また、外部からの知見も取り入れるため、関連する課題(チャレンジ)も開始しました。
Hugging Face Blog ★4 研究 EN

一行コードでHugging Faceデータセットを対話的に探索

要約を読む要約を閉じる
📰ニュース

Hugging Faceデータセットを一行のPythonコードで対話的に探索できる新機能がリリースされました。

🔍注目ポイント

データセットの構造や内容を直感的に可視化し、フィルタリングやソートが容易になります。

🔮これからどうなる

データサイエンティストやMLエンジニアがデータ理解の時間を大幅に短縮できます。

Hugging Faceの`datasets`ライブラリに統合されたこの機能は、Jupyter NotebookやColab環境で特に有用です。
データセットの各特徴量をグラフで表示したり、特定の条件でデータを絞り込んだりできるため、前処理やモデル開発の効率が向上します。
Hugging Face Blog ★4 LLM EN

PPOを用いたRLHFの実装におけるN個の詳細

要約を読む要約を閉じる
📰ニュース

強化学習と人間フィードバック(RLHF)をPPOアルゴリズムで実装する際の具体的な詳細が解説されました。

🔍注目ポイント

RLHFのPPO実装における、報酬モデルの学習やPPOのハイパーパラメータ調整など、実践的な課題と解決策が示されています。

🔮これからどうなる

大規模言語モデルの性能向上を目指す研究者や開発者が、RLHFをより効果的に実装できるようになります。

RLHFは、LLMが人間の意図に沿った応答を生成するために不可欠な技術です。
特にPPOは、RLHFで広く利用されるアルゴリズムですが、その実装には多くの細かい調整が必要です。
本記事では、報酬モデルの設計、PPOの損失関数、クリッピング、学習率、バッチサイズなど、多岐にわたる実践的なヒントが提供されています。
Hugging Face Blog ★3 画像生成 EN

SDXLのシンプルな最適化を探る

要約を読む要約を閉じる
📰ニュース

Hugging FaceがSDXLの推論速度を向上させるためのシンプルな最適化手法を公開しました。

🔍注目ポイント

モデルの構造変更なしに、推論時のメモリ使用量と計算量を削減する手法が示されています。

🔮これからどうなる

より多くのユーザーが低スペック環境でもSDXLを利用できるようになり、画像生成の敷居が下がります。

この最適化は、特にGPUメモリが限られている環境で効果を発揮します。
具体的には、モデルの一部をCPUにオフロードしたり、推論時のバッチサイズを調整したりするなどの手法が紹介されています。
これにより、より高速かつ効率的な画像生成が可能になります。