研究

5296件
OpenAI Blog ★4 LLM EN

OpenAIにおける経済影響研究

要約を読む要約を閉じる
📰ニュース

OpenAIが大規模言語モデルの経済的影響に関する研究提案を募集している。

🔍注目ポイント

LLMが労働市場や産業構造に与える具体的な影響を多角的に分析する。

🔮これからどうなる

政策立案者や企業がAIの未来に備えるための重要な知見が得られる。

OpenAIは、大規模言語モデル(LLM)が経済に与える影響について、外部の研究者からの提案を募っている。
これは、LLMの急速な発展が労働市場、生産性、産業構造、所得格差などにどのような変化をもたらすかを深く理解することを目的としている。
研究結果は、AI技術の健全な発展と社会への適応を促すための政策提言や戦略策定に役立つと期待されている。
Hugging Face Blog ★5 LLM EN

BERT 101 - 最先端のNLPモデルを解説

要約を読む要約を閉じる
📰ニュース

Googleが開発したBERTは、自然言語処理の事前学習モデルです。

🔍注目ポイント

双方向の文脈を捉えるTransformerアーキテクチャにより、文脈理解が飛躍的に向上しました。

🔮これからどうなる

様々なNLPタスクの精度を向上させ、多くのAIアプリケーション開発を加速させました。

BERTは「Bidirectional Encoder Representations from Transformers」の略で、単語の前後関係を同時に学習します。
これにより、従来の単方向モデルでは難しかった曖昧な表現の理解も可能になりました。
事前学習済みモデルとして公開され、ファインチューニングによって多様なタスクに適用できます。
Hugging Face Blog ★4 研究 EN

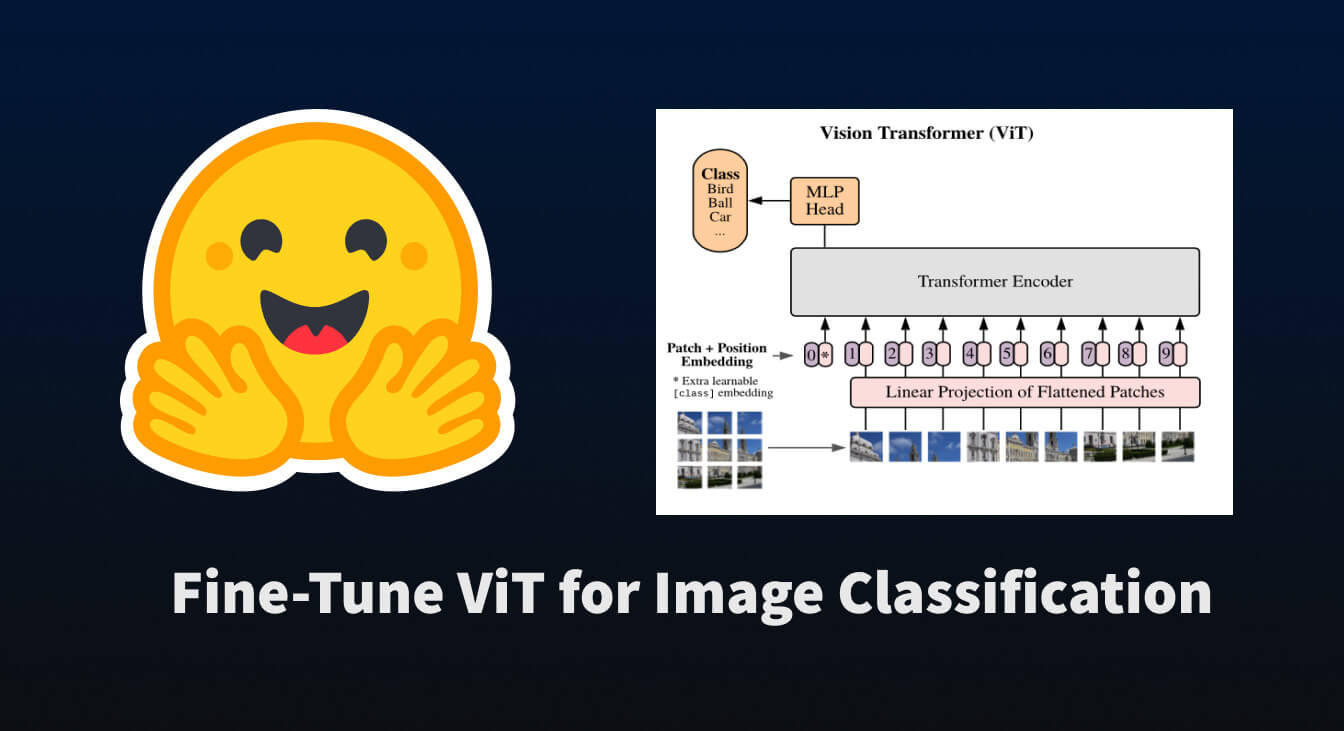
Hugging Face TransformersでViTを画像分類用にファインチューニング

要約を読む要約を閉じる
📰ニュース

Hugging Face Transformersライブラリを使って、Vision Transformer(ViT)を画像分類タスク用にファインチューニングする方法が紹介されました。

🔍注目ポイント

事前学習済みViTモデルをカスタムデータセットで効率的に再学習させ、高い精度で画像分類を行う技術が解説されています。

🔮これからどうなる

開発者は複雑なモデル構築なしに、最先端の画像分類モデルを簡単に利用・応用できるようになります。

Vision Transformer(ViT)は、Transformerアーキテクチャを画像認識に適用したモデルで、高い性能を示します。
Hugging Face Transformersは、このような大規模モデルの利用を容易にするライブラリです。
この記事では、具体的なコード例を交えながら、ViTのファインチューニング手順を詳細に解説しています。
OpenAI Blog ★4 LLM EN

一部の数学オリンピック形式問題を解くAI

要約を読む要約を閉じる
📰ニュース

OpenAIがLean用のニューラル定理証明器を開発し、数学オリンピック形式の難問を解くことに成功しました。

🔍注目ポイント

AMC12やAIME、IMO由来の問題を解ける高い推論能力を持つ定理証明AIが開発されました。

🔮これからどうなる

数学研究や教育、AIによる形式的証明の自動化に大きな進展をもたらす可能性があります。

OpenAIは、形式的証明言語Lean上で動作するニューラル定理証明器を構築しました。
このAIは、高校レベルの数学オリンピック問題(AMC12、AIME、IMO)を解く能力を示し、特に形式的な数学的推論において高い性能を発揮しています。
これは、AIが複雑な数学的問題を理解し、解決する能力の向上を示唆しています。
Hugging Face Blog ★3 LLM EN

Pythonで感情分析を始める

要約を読む要約を閉じる
📰ニュース

PythonとHugging FaceのTransformersライブラリを使って感情分析を行う方法が解説されました。

🔍注目ポイント

事前学習済みモデルを活用することで、少ないコードで高精度な感情分析を実装できる点が優れています。

🔮これからどうなる

開発者はテキストデータからユーザーの感情を効率的に把握し、サービス改善やマーケティングに活用できます。

感情分析は、テキストがポジティブかネガティブか、あるいは中立かを判断する自然言語処理の一分野です。
Hugging FaceのTransformersライブラリは、BERTやRoBERTaなどの強力なモデルを簡単に利用できるため、初心者でも高度な感情分析を実装できます。
Pythonのシンプルなコード例を通じて、モデルのロードから予測までの一連の流れが紹介されています。
Hugging Face Blog ★4 研究 EN

🤗 Hubでの超高速検索

要約を読む要約を閉じる
📰ニュース

Hugging Face Hubの検索機能が大幅に強化され、より高速で関連性の高い結果が得られるようになりました。

🔍注目ポイント

Elasticsearchとセマンティック検索を組み合わせることで、キーワードだけでなく意味に基づいた検索が可能になりました。

🔮これからどうなる

ユーザーは必要なモデルやデータセットを効率的に見つけられるようになり、開発の生産性が向上します。

以前の検索はキーワードマッチングが主で、関連性の低い結果が出ることがありました。
今回のアップデートでは、Elasticsearchによる高速なインデックス検索と、セマンティック検索による意味理解を融合。
これにより、より自然言語に近いクエリでも適切なリソースを発見できるようになりました。
OpenAI Blog ★4 LLM EN

対照的な事前学習によるテキストとコードの埋め込み

要約を読む要約を閉じる
📰ニュース

OpenAIがテキストとコードの埋め込みモデルを公開し、様々なタスクで高性能を発揮。

🔍注目ポイント

対照学習により、類似するテキストやコードを近くに配置する埋め込みを生成する。

🔮これからどうなる

開発者はより高度な検索、コード補完、意味理解機能をアプリケーションに組み込める。

OpenAIがテキストとコードの埋め込みモデルを公開しました。
これは、対照的な事前学習という手法を用いて、類似するテキストやコードを埋め込み空間上で近くに配置するように学習されます。
これにより、検索、コード補完、意味理解など、多岐にわたるタスクで高い性能を発揮します。
開発者はこれらのモデルをAPI経由で利用でき、より高度なAI機能をアプリケーションに統合することが可能になります。
Hugging Face Blog ★4 研究 EN

Hugging Face HubにStable-baselines3が登場!

要約を読む要約を閉じる
📰ニュース

強化学習ライブラリStable-baselines3がHugging Face Hubに統合されました。

🔍注目ポイント

強化学習モデルの共有、バージョン管理、再現性が大幅に向上します。

🔮これからどうなる

研究者や開発者が強化学習モデルをより簡単に共有・利用できるようになります。

Hugging Face Hubは、機械学習モデルやデータセットを共有するためのプラットフォームです。
Stable-baselines3の統合により、強化学習モデルも他の機械学習モデルと同様にHub上で管理できるようになり、コミュニティでのコラボレーションが促進されます。
モデルのアップロードやダウンロードが容易になり、学習済みモデルの再利用が加速すると期待されます。
Hugging Face Blog ★4 研究 EN

ケーススタディ: Hugging Face Infinityと最新CPUによるミリ秒レイテンシの実現

要約を読む要約を閉じる
📰ニュース

Hugging Face Infinityと最新CPUを組み合わせることで、ミリ秒単位の超低レイテンシを実現しました。

🔍注目ポイント

Infinityは、最適化された推論エンジンと最新CPUの性能を最大限に引き出し、高速なモデル実行を可能にします。

🔮これからどうなる

リアルタイム応答が求められるAIアプリケーションにおいて、ユーザー体験が大幅に向上するでしょう。

このケーススタディでは、Hugging Face Infinityがどのようにして推論レイテンシを劇的に削減できるかを示しています。
特に、最新のIntel XeonプロセッサなどのCPU上で、Transformerモデルの推論を効率的に実行するための最適化が施されています。
これにより、GPUが利用できない環境やコストを抑えたい場合に、高性能なAI推論が可能になります。
Hugging Face Blog ★4 LLM EN

AutoNLPとProdigyによるアクティブラーニング

要約を読む要約を閉じる
📰ニュース

Hugging FaceのAutoNLPとProdigyを組み合わせたアクティブラーニングのワークフローが紹介されました。

🔍注目ポイント

少量のラベル付きデータでモデルを効率的に訓練し、データラベリングのコストを削減できる点が技術的ポイントです。

🔮これからどうなる

企業や研究者は、限られたリソースで高品質なNLPモデルを開発できるようになります。

アクティブラーニングは、モデルが最も学習効果の高いデータポイントを選択し、人間がそれらをラベリングすることで、訓練データの量を最小限に抑える手法です。
AutoNLPは自動でモデルを訓練し、Prodigyは効率的なデータラベリングツールとして機能します。
この組み合わせにより、反復的なプロセスを通じてモデル性能を向上させます。
OpenAI Blog ★4 LLM EN

WebGPT: ウェブブラウジングによる言語モデルの事実正確性の向上

要約を読む要約を閉じる
📰ニュース

OpenAIがGPT-3をファインチューニングし、ウェブブラウザを使って質問への回答精度を高めました。

🔍注目ポイント

テキストベースのウェブブラウザを使い、GPT-3が情報検索し、事実に基づいた回答を生成する技術です。

🔮これからどうなる

言語モデルの誤情報生成リスクが減り、より信頼性の高い情報提供が可能になります。

WebGPTは、GPT-3にウェブ検索能力を付与することで、オープンエンドな質問に対してより正確な回答を生成できるように設計されています。
これにより、モデルが学習データにない最新情報や特定の事実を検索し、回答に反映させることが可能になりました。
従来の言語モデルが抱えていた「ハルシネーション」問題の解決に貢献します。
Hugging Face Blog ★4 LLM EN

Perceiver IO: あらゆるモダリティに対応するスケーラブルな完全アテンションモデル

要約を読む要約を閉じる
📰ニュース

Google DeepMindが、様々なデータ形式を扱える汎用的なAIモデル「Perceiver IO」を発表しました。

🔍注目ポイント

大量の入力データを効率的に処理するため、ボトルネックアテンション機構を導入している点が技術的ポイントです。

🔮これからどうなる

画像、音声、テキストなど異なるデータを統一的に扱えるため、マルチモーダルAI開発が加速する可能性があります。

Perceiver IOは、Transformerの課題である入力データ量の多さによる計算コスト増大を解決するために設計されました。
入力データを潜在表現にマッピングし、その潜在表現間でアテンションを行うことで、計算量を大幅に削減しつつ、高い性能を維持します。
これにより、単一のモデルで多様なタスクに対応できるようになります。