LLM

6681件
Hugging Face Blog ★4 LLM EN

Gemmaへようこそ - Googleの新しいオープンLLM

要約を読む要約を閉じる
📰ニュース

Googleが新しいオープンな大規模言語モデル「Gemma」を発表しました。

🔍注目ポイント

GemmaはGoogleの最先端研究から派生し、軽量で高性能なモデルを提供します。

🔮これからどうなる

開発者はGoogleの技術を基盤に、より多様なAIアプリケーションを構築できるようになります。

Gemmaは、Googleが開発した最先端のモデルであり、特に軽量でありながら高い性能を発揮するように設計されています。
これにより、限られたリソース環境でも効率的に動作し、幅広いアプリケーションへの組み込みが期待されます。
開発者コミュニティにとって、Googleの技術スタックへのアクセスが容易になることで、イノベーションが加速する可能性があります。
Hugging Face Blog ★4 LLM EN

Open Ko-LLMリーダーボードの紹介:韓国LLM評価エコシステムをリード

要約を読む要約を閉じる
📰ニュース

韓国語LLMの性能を評価する「Open Ko-LLMリーダーボード」が公開されました。

🔍注目ポイント

多様な韓国語データセットと評価指標を用いて、公平かつ透明性の高い評価を提供します。

🔮これからどうなる

韓国語LLMの開発者は、モデルの性能を客観的に把握し、改善に役立てられます。

このリーダーボードは、Hugging FaceとNAVER Cloudが協力して開発しました。
韓国語の特性を考慮した評価ベンチマークを構築し、モデルの比較と進歩を促進します。
オープンソースモデルの評価に重点を置いており、コミュニティ全体の発展に貢献することを目指しています。
Hugging Face Blog ★4 LLM EN

🤗 PEFTが新しいマージ手法を導入

要約を読む要約を閉じる
📰ニュース

Hugging FaceのPEFTライブラリに、LoRAモデルをマージするための新しい手法が追加されました。

🔍注目ポイント

LoRAアダプターのマージ時に、より柔軟で効率的なモデル統合が可能になります。

🔮これからどうなる

開発者は、LoRAモデルのデプロイや共有が容易になり、リソース効率が向上します。

PEFT (Parameter-Efficient Fine-Tuning) は、大規模言語モデルのファインチューニングを効率化するライブラリです。
今回追加された新しいマージ手法により、LoRAアダプターをベースモデルに統合する際の選択肢が増え、特定のユースケースに合わせた最適化が可能になります。
これにより、モデルのパフォーマンス維持とファイルサイズの削減を両立しやすくなります。
OpenAI Blog ★5 LLM EN

世界シミュレーターとしての動画生成モデル

要約を読む要約を閉じる
📰ニュース

OpenAIがテキストから最大1分の高忠実度動画を生成する「Sora」を発表しました。

🔍注目ポイント

動画と画像を混合学習し、時空間パッチのTransformerで長尺・高解像度動画を生成します。

🔮これからどうなる

物理世界のシミュレーションが可能になり、映画制作やゲーム開発に革新をもたらす可能性があります。

Soraは、テキスト条件付き拡散モデルを動画と画像の両方で学習し、可変の期間、解像度、アスペクト比に対応します。
時空間パッチのTransformerアーキテクチャを活用することで、最大1分の高忠実度動画生成を実現しました。
これは物理世界の汎用シミュレーター構築への有望な一歩とされています。
OpenAI Blog ★4 LLM EN

ChatGPTの記憶機能と新しい制御機能

要約を読む要約を閉じる
📰ニュース

ChatGPTが過去の会話内容を記憶し、今後のチャットに活用する機能のテストが開始されました。

🔍注目ポイント

ユーザーがChatGPTの記憶内容を完全に制御できる点が技術的なポイントです。

🔮これからどうなる

ユーザーはよりパーソナライズされた、文脈に沿ったChatGPTとの対話が可能になります。

この新機能により、ChatGPTはユーザーの好みや過去の会話履歴を記憶し、より関連性の高い情報を提供できるようになります。
ユーザーは記憶機能をオン/オフしたり、特定の記憶を削除したり、一時的に記憶を使わない設定にしたりと、プライバシーと利便性のバランスを自分で調整できます。
この機能はまず一部のFreeおよびPlusユーザーに展開され、順次拡大される予定です。
Hugging Face Blog ★4 LLM EN

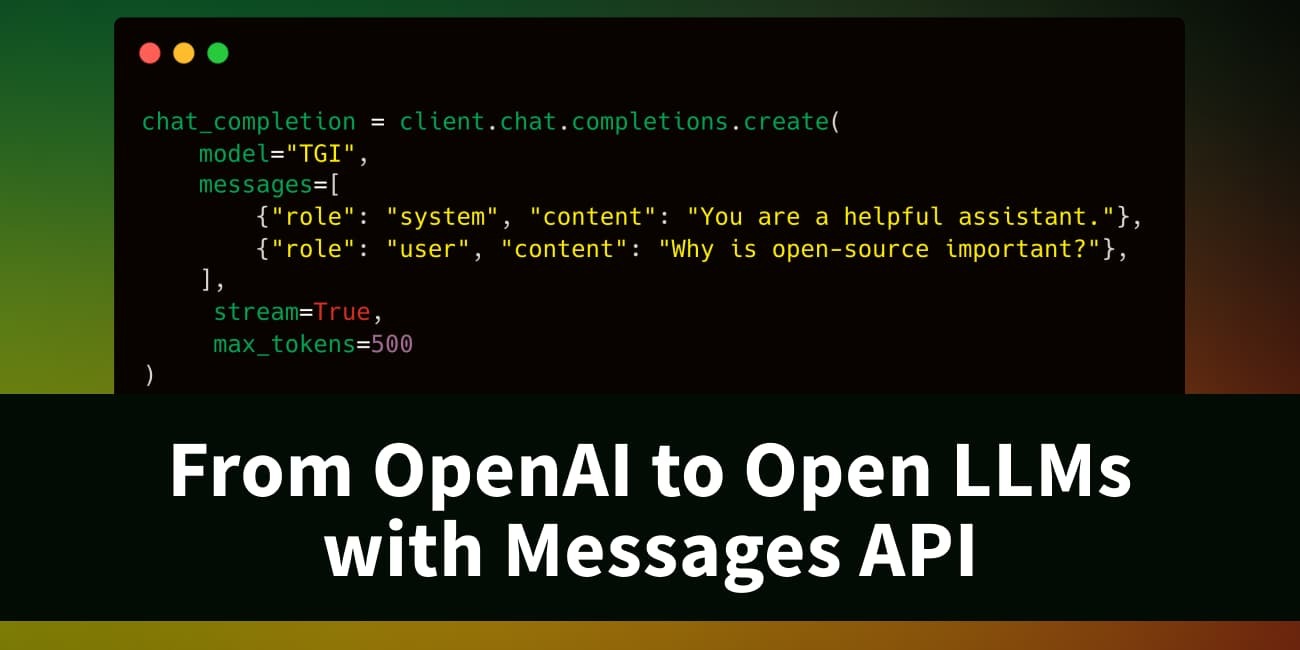
Hugging FaceでOpenAIからオープンLLMへの移行をMessages APIで実現

要約を読む要約を閉じる
📰ニュース

Hugging FaceがMessages APIを導入し、OpenAIのAPIと互換性のあるオープンなLLM利用を可能にしました。

🔍注目ポイント

OpenAIのMessages APIを模倣することで、既存コードの変更を最小限に抑え、オープンモデルへの移行を容易にします。

🔮これからどうなる

開発者は特定のプロバイダーに縛られず、より多様なオープンソースLLMを柔軟に利用できるようになります。

このAPIは、チャット形式の対話に特化しており、ユーザーとアシスタントの役割を明確に定義します。
これにより、OpenAIのAPIを使用していたアプリケーションが、Hugging Face上のオープンモデルに簡単に切り替えられるようになります。
開発者はコスト削減やモデル選択の自由度向上といったメリットを享受できます。
Hugging Face Blog ★4 LLM EN

NPHardEvalリーダーボード:複雑性クラスと動的更新を通じて大規模言語モデルの推論能力を解明

要約を読む要約を閉じる
📰ニュース

LLMの推論能力を評価する新しいベンチマーク「NPHardEvalリーダーボード」が公開されました。

🔍注目ポイント

計算複雑性理論に基づき、NP困難問題を含む多様な推論タスクでLLMを評価します。

🔮これからどうなる

LLM開発者は、モデルの推論能力の弱点を特定し、より高度なAI開発に役立てられます。

NPHardEvalは、従来のベンチマークでは捉えきれなかったLLMの推論能力の限界を明らかにするために設計されました。
動的に更新されるリーダーボード形式で、研究コミュニティが継続的に貢献できるオープンなプラットフォームです。
これにより、モデルの進化に合わせて評価基準も進化し、より実用的な推論能力の向上を促します。
Hugging Face Blog ★4 LLM EN

オープンLLMを用いた憲法AI

要約を読む要約を閉じる
📰ニュース

Hugging FaceがオープンソースLLMで憲法AIを実装する手法を公開しました。

🔍注目ポイント

人間によるフィードバックなしに、AIが倫理的原則に基づいて自己修正する技術です。

🔮これからどうなる

より安全で倫理的なAIモデルの開発が加速し、悪用リスクの低減に貢献します。

憲法AIは、特定の原則(憲法)に基づきAIが自身の出力を評価・修正するプロセスです。
これにより、有害なコンテンツ生成を防ぎ、AIの振る舞いをより望ましい方向に導きます。
Hugging Faceは、この手法をオープンソースモデルで実現する具体的な方法とコードを提供しています。
Hugging Face Blog ★4 LLM EN

Hugging Face Text Generation InferenceがAWS Inferentia2で利用可能に

要約を読む要約を閉じる
📰ニュース

Hugging Faceのテキスト生成推論(TGI)がAWS Inferentia2で利用可能になりました。

🔍注目ポイント

AWS Inferentia2の活用により、大規模言語モデルの推論コストを大幅に削減できます。

🔮これからどうなる

企業や開発者は、より低コストで高性能なLLMを本番環境で利用できるようになります。

Hugging Face TGIは、LLMの高速かつ効率的なデプロイを可能にするソリューションです。
AWS Inferentia2は、機械学習推論に特化したAWSの独自チップで、高いパフォーマンスとコスト効率を提供します。
この統合により、ユーザーはTGIの恩恵を受けつつ、Inferentia2のコストメリットを享受できます。
Hugging Face Blog ★4 LLM EN

Hugging Faceにパッチ時系列トランスフォーマーが登場

要約を読む要約を閉じる
📰ニュース

Hugging Faceが時系列予測モデル「Patch Time Series Transformer (PatchTST)」をライブラリに追加しました。

🔍注目ポイント

PatchTSTは、時系列データをパッチに分割し、トランスフォーマーで処理することで、高い予測精度と効率を実現します。

🔮これからどうなる

開発者は、複雑な時系列予測モデルをHugging Faceを通じて簡単に利用・構築できるようになります。

PatchTSTは、Googleの研究者によって開発されたモデルで、従来の時系列モデルに比べて、特に長期間の予測において優れた性能を発揮します。
Hugging Faceへの統合により、PyTorchやTensorFlowといった主要なフレームワークでの利用が容易になり、幅広い応用が期待されます。
Hugging Face Blog ★4 LLM EN

エンタープライズシナリオリーダーボードの紹介:実世界ユースケースのためのリーダーボード

要約を読む要約を閉じる
📰ニュース

Hugging Faceが企業向けの実世界ユースケースに特化した新しいLLMリーダーボードを公開しました。

🔍注目ポイント

従来のベンチマークに加え、RAGやコード生成など実際のビジネス課題を評価する点が特徴です。

🔮これからどうなる

企業は自社のニーズに合った高性能なLLMを特定しやすくなり、導入判断が加速します。

このリーダーボードは、従来の学術的なベンチマークでは捉えきれなかった、企業が直面する具体的な課題(例えば、社内文書からの情報抽出や特定のプログラミング言語でのコード生成)に対するLLMの性能を評価します。
これにより、企業はより実践的な視点から最適なモデルを選定できるようになります。
Hugging Face Blog ★4 LLM EN

XeonでStarCoderを🤗 Optimum Intelで高速化:Q8/Q4と投機的デコーディング

要約を読む要約を閉じる
📰ニュース

Hugging FaceのStarCoderモデルがIntel Xeonプロセッサ上で大幅に高速化されました。

🔍注目ポイント

Optimum IntelライブラリとOpenVINOにより、Q8/Q4量子化と投機的デコーディングを組み合わせ、推論速度を向上させています。

🔮これからどうなる

開発者はIntel Xeon環境でStarCoderをより効率的に利用でき、コストと時間の削減に繋がります。

StarCoderはコード生成に特化した大規模言語モデルです。
今回の最適化により、Q8量子化で最大2.4倍、Q4量子化で最大3.1倍の高速化を実現しました。
特に投機的デコーディングは、より小さなモデルで次のトークンを予測し、大きなモデルで検証することで、推論速度をさらに向上させます。