より小さく、より良く:Xeonで効率的な生成AI体験を実現するQ8-Chat
要約を読む要約を閉じる
📰ニュース
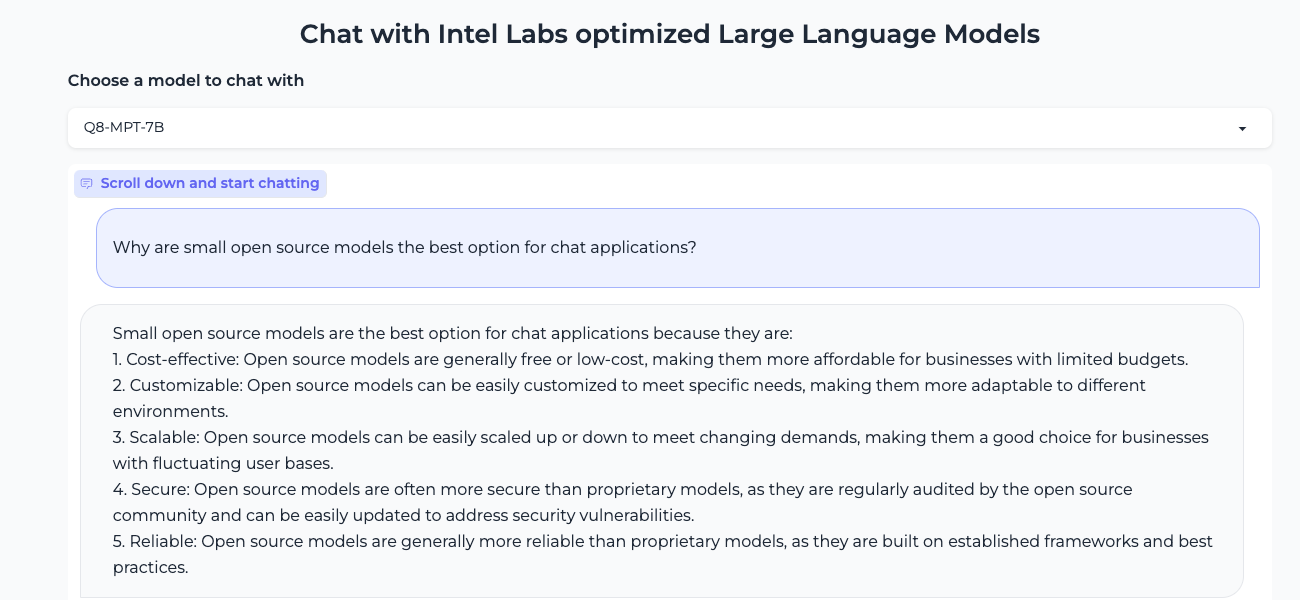
IntelとHugging Faceが、Xeonプロセッサ上で効率的に動作するQ8-Chatという新しい生成AIモデルを発表しました。
🔍注目ポイント
Q8-Chatは、8ビット量子化と最適化により、Xeon環境で高速かつ低メモリ消費で大規模言語モデルを動かすことを可能にしました。
🔮これからどうなる
企業や開発者は、高価なGPUなしで既存のXeonサーバーを活用し、コスト効率良く生成AIを導入できるようになります。
この取り組みは、IntelのAMX(Advanced Matrix Extensions)やAVX-512といったハードウェア機能を活用し、Hugging Faceのoptimum-intelライブラリを通じて実現されています。
これにより、Llama-2などの大規模モデルをXeon上で実用的な速度で実行でき、エッジデバイスやオンプレミス環境でのAI活用が加速すると期待されます。
これにより、Llama-2などの大規模モデルをXeon上で実用的な速度で実行でき、エッジデバイスやオンプレミス環境でのAI活用が加速すると期待されます。