LLM

6680件
Hugging Face Blog ★3 LLM EN

埋め込みの始め方

要約を読む要約を閉じる
📰ニュース

Hugging Faceが埋め込み(Embeddings)の基礎と活用方法を解説しました。

🔍注目ポイント

テキストや画像を数値ベクトルに変換し、類似度計算や検索に利用する技術です。

🔮これからどうなる

AIモデルの理解を深め、より高度な検索や推薦システム開発に役立ちます。

埋め込みは、単語や文章、画像などのデータを低次元の数値ベクトルに変換する技術です。
これにより、意味的に近いデータはベクトル空間でも近くに配置され、類似度計算や検索、クラスタリングなどに活用できます。
Hugging Faceは、この埋め込みの概念から実践的な利用方法までを分かりやすく解説しています。
Hugging Face Blog ★4 LLM EN

Hugging Face OptimumでTransformerモデルをONNXに変換

要約を読む要約を閉じる
📰ニュース

Hugging Face OptimumがTransformerモデルをONNX形式に変換し、推論を高速化する機能を提供しました。

🔍注目ポイント

Optimumライブラリを使うことで、PyTorchやTensorFlowのTransformerモデルを簡単にONNXにエクスポートできます。

🔮これからどうなる

開発者はTransformerモデルのデプロイメントを効率化し、様々な環境での推論パフォーマンスを向上させられます。

ONNX(Open Neural Network Exchange)は、AIモデルを表現するためのオープンフォーマットです。
これにより、異なるフレームワークで学習したモデルを、ONNX Runtimeなどの最適化されたエンジンで実行できるようになります。
Hugging Face Optimumは、この変換プロセスを簡素化し、モデルの最適化とデプロイを容易にします。
OpenAI Blog ★4 LLM EN

大規模モデルによる進化

要約を読む要約を閉じる
📰ニュース

OpenAIが大規模モデルの進化と社会への影響について考察しています。

🔍注目ポイント

大規模モデルが様々な分野で人間の能力を拡張し、新たな可能性を切り開く点が重要です。

🔮これからどうなる

研究者や開発者は、より強力なAIツールを活用し、複雑な問題解決やイノベーションを加速できます。

OpenAIは、大規模モデルが単なる技術的進歩ではなく、科学、芸術、ビジネスなど多岐にわたる領域で変革をもたらすと強調しています。
これらのモデルは、人間の創造性や生産性を高めるための強力なパートナーとなり得ると述べています。
Hugging Face Blog ★4 LLM EN

IntelとHugging Faceが機械学習ハードウェアアクセラレーションの民主化で提携

要約を読む要約を閉じる
📰ニュース

IntelとHugging Faceが提携し、機械学習のハードウェアアクセラレーションをより多くの開発者に提供します。

🔍注目ポイント

IntelのGaudi2 AIアクセラレーターをHugging Faceプラットフォームに統合し、大規模モデルの学習と推論を最適化します。

🔮これからどうなる

開発者は高性能なAIハードウェアにアクセスしやすくなり、AIモデルの開発と展開が加速されます。

この提携により、Hugging FaceユーザーはIntel Gaudi2の高性能なAIアクセラレーターをクラウド上で利用できるようになります。
特に大規模言語モデル(LLM)の学習や推論において、コスト効率とパフォーマンスの向上が期待されます。
オープンソースAIコミュニティへの貢献も視野に入れています。
OpenAI Blog ★4 LLM EN

AIによる批評が人間の欠陥発見を支援

要約を読む要約を閉じる
📰ニュース

AIが生成した批評文が、人間が要約文の欠陥を見つける能力を大幅に向上させました。

🔍注目ポイント

大規模モデルほど自己批評能力が高く、要約作成よりも批評作成においてスケールが効果的でした。

🔮これからどうなる

AIが人間のAI監視を支援する可能性を示し、複雑なタスクでのAIシステムの信頼性向上に貢献します。

OpenAIは「批評作成モデル」を訓練し、要約文の欠陥を記述させました。
その結果、人間の評価者はAIの批評文を見ることで、より頻繁に要約文の欠陥を発見できるようになりました。
この研究は、AIがAIシステムの監視を支援する有望な方法を示唆しています。
OpenAI Blog ★4 LLM EN

大規模ニューラルネットワークのトレーニング技術

要約を読む要約を閉じる
📰ニュース

大規模ニューラルネットワークのトレーニングは、複雑なエンジニアリングと研究課題です。

🔍注目ポイント

複数のGPUを同期させて単一計算を行うことで、大規模モデルのトレーニングを可能にします。

🔮これからどうなる

AIの進歩を加速させ、より高性能なAIモデルの開発に貢献します。

大規模ニューラルネットワークは、近年のAIにおける多くの進歩の中心にあります。
しかし、それらをトレーニングするには、GPUクラスターを調整して単一の同期計算を実行する必要があり、これは非常に困難な課題です。
この技術は、この課題を克服するためのものです。
Hugging Face Blog ★4 LLM EN

アノテーション付き拡散モデル

要約を読む要約を閉じる
📰ニュース

拡散モデルの動作原理を、コードと数式を用いて詳細に解説した記事が公開されました。

🔍注目ポイント

複雑な拡散モデルの概念を、PyTorchコードと数学的導出を並行して示すことで理解しやすくしています。

🔮これからどうなる

AI研究者や開発者が拡散モデルをより深く理解し、応用するための学習リソースとなります。

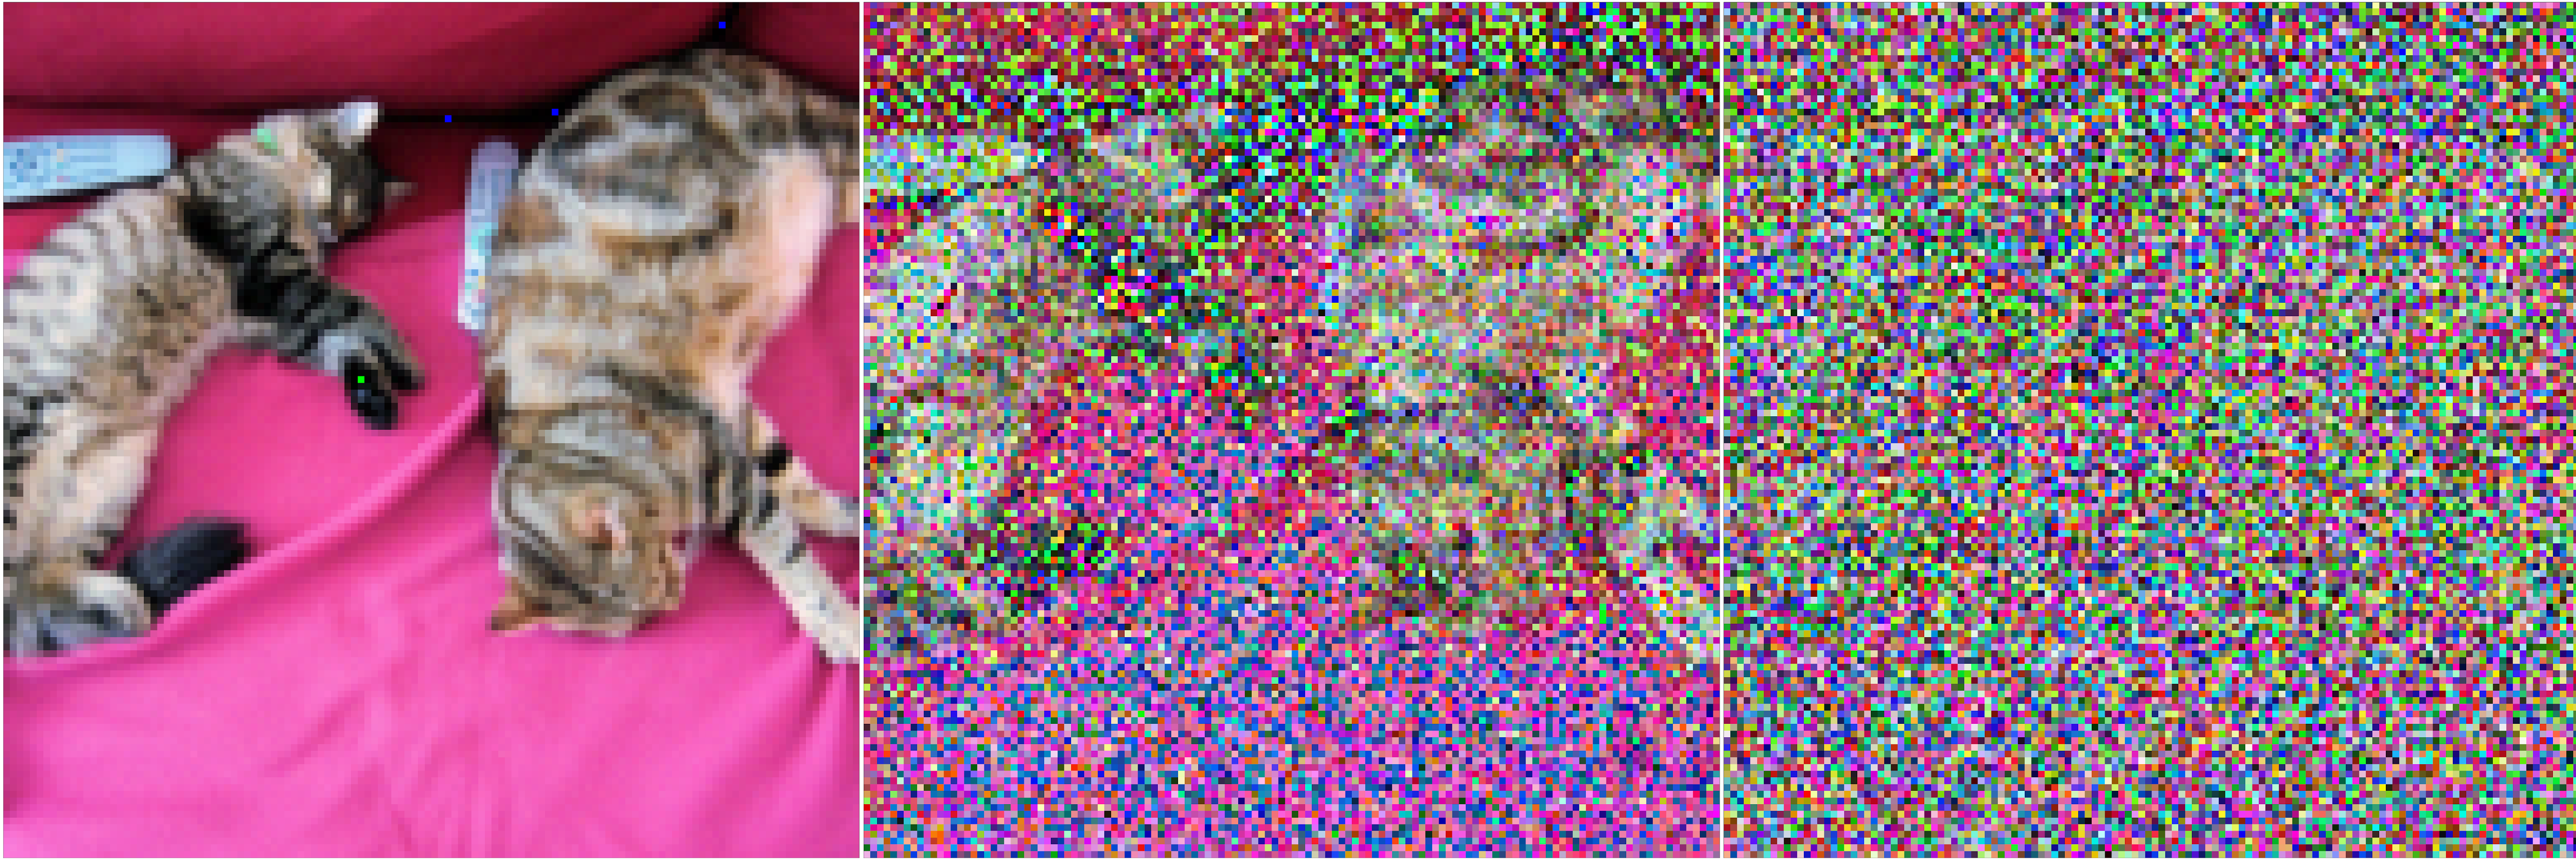
Hugging Faceが公開したこの解説は、拡散モデルの基本から応用までを網羅しており、特にノイズ除去、サンプリング、学習プロセスに焦点を当てています。
理論と実践を結びつけることで、読者がモデルの内部動作を把握しやすくなっています。
OpenAI Blog ★4 LLM EN

言語モデル展開のためのベストプラクティス

要約を読む要約を閉じる
📰ニュース

主要AI企業が言語モデルの展開に関するベストプラクティスを発表しました。

🔍注目ポイント

OpenAI、Cohere、AI21 Labsが共同で、安全なLLM利用の指針を策定しました。

🔮これからどうなる

LLMを開発・利用する全ての組織が、より安全かつ責任ある運用が可能になります。

このベストプラクティスは、言語モデルの安全性と責任ある利用を促進することを目的としています。
特に、モデルの誤用や悪用を防ぎ、倫理的なガイドラインに沿った開発・展開を促す内容となっています。
これにより、AI技術の信頼性と社会受容性の向上が期待されます。
OpenAI Blog ★4 LLM EN

モデルに不確実性を言葉で表現させる

要約を読む要約を閉じる
📰ニュース

OpenAIがモデルに自身の不確実性を言葉で表現させる手法を開発しました。

🔍注目ポイント

モデルが自信の度合いを数値だけでなく、自然言語で説明できるようになりました。

🔮これからどうなる

AIの回答の信頼性が向上し、ユーザーはより適切にAIの情報を利用できるようになります。

この技術は、モデルが「わからない」と正直に伝えたり、回答の根拠や限界を説明したりすることを可能にします。
これにより、ハルシネーション(誤情報生成)のリスクを軽減し、より安全で信頼性の高いAIシステムに繋がります。
特に、医療や法律など、正確性が求められる分野での応用が期待されます。
Hugging Face Blog ★3 LLM EN

GraphcoreとHugging FaceがIPU対応Transformerの新しいラインナップを発表

要約を読む要約を閉じる
📰ニュース

GraphcoreとHugging Faceが、GraphcoreのIPUに最適化されたTransformerモデル群を公開しました。

🔍注目ポイント

Hugging FaceのモデルがGraphcoreのIPUで高速かつ効率的に動作するよう最適化された点が技術的ポイントです。

🔮これからどうなる

AI開発者は、TransformerモデルをIPU上でより高速に実行でき、研究開発が加速するでしょう。

GraphcoreはAIワークロードに特化したプロセッサであるIPU(Intelligence Processing Unit)を開発しています。
Hugging Faceは、Transformerモデルをはじめとする機械学習モデルのハブとして広く利用されています。
今回の提携により、Hugging Faceの人気のTransformerモデルがIPU上で最大限の性能を発揮できるようになりました。
OpenAI Blog ★4 LLM EN

OpenAI Codexで次世代アプリケーションを強化

要約を読む要約を閉じる
📰ニュース

OpenAIのCodexがAPIを通じて70種類のアプリケーションで活用されています。

🔍注目ポイント

Codexは多様なユースケースで、次世代アプリケーションの基盤技術として機能しています。

🔮これからどうなる

開発者はCodexを利用することで、より高度で革新的なアプリケーションを構築できます。

OpenAI Codexは、自然言語をコードに変換する能力を持つAIモデルです。
当初はGitHub Copilotの基盤技術として知られていましたが、現在ではAPIを通じて幅広い開発者が利用できるようになっています。
これにより、コード生成だけでなく、データ分析、コンテンツ生成など、様々な分野での応用が進んでいます。
Hugging Face Blog ★4 LLM EN

実データなしで効率的なテーブル事前学習:TAPEXの紹介

要約を読む要約を閉じる
📰ニュース

実データを使わずにテーブルデータに対する効率的な事前学習手法TAPEXが開発されました。

🔍注目ポイント

合成データと新しい事前学習タスクにより、実データなしでテーブル理解モデルを効率的に学習できます。

🔮これからどうなる

データプライバシーを保護しつつ、多様なテーブル理解タスクの性能向上に貢献します。

TAPEXは、合成データ生成と新しい事前学習タスクを組み合わせることで、実データに依存せずにテーブル理解モデルを訓練します。
これにより、データ収集の課題を解決し、プライバシー懸念を軽減しながら、様々なテーブル関連タスクで高い性能を発揮します。
特に、データが少ないドメインでの応用が期待されます。