LLM

6680件
Hugging Face Blog ★4 LLM EN

AutoNLPとProdigyによるアクティブラーニング

要約を読む要約を閉じる
📰ニュース

Hugging FaceのAutoNLPとProdigyを組み合わせたアクティブラーニングのワークフローが紹介されました。

🔍注目ポイント

少量のラベル付きデータでモデルを効率的に訓練し、データラベリングのコストを削減できる点が技術的ポイントです。

🔮これからどうなる

企業や研究者は、限られたリソースで高品質なNLPモデルを開発できるようになります。

アクティブラーニングは、モデルが最も学習効果の高いデータポイントを選択し、人間がそれらをラベリングすることで、訓練データの量を最小限に抑える手法です。
AutoNLPは自動でモデルを訓練し、Prodigyは効率的なデータラベリングツールとして機能します。
この組み合わせにより、反復的なプロセスを通じてモデル性能を向上させます。
OpenAI Blog ★4 LLM EN

WebGPT: ウェブブラウジングによる言語モデルの事実正確性の向上

要約を読む要約を閉じる
📰ニュース

OpenAIがGPT-3をファインチューニングし、ウェブブラウザを使って質問への回答精度を高めました。

🔍注目ポイント

テキストベースのウェブブラウザを使い、GPT-3が情報検索し、事実に基づいた回答を生成する技術です。

🔮これからどうなる

言語モデルの誤情報生成リスクが減り、より信頼性の高い情報提供が可能になります。

WebGPTは、GPT-3にウェブ検索能力を付与することで、オープンエンドな質問に対してより正確な回答を生成できるように設計されています。
これにより、モデルが学習データにない最新情報や特定の事実を検索し、回答に反映させることが可能になりました。
従来の言語モデルが抱えていた「ハルシネーション」問題の解決に貢献します。
Hugging Face Blog ★4 LLM EN

Perceiver IO: あらゆるモダリティに対応するスケーラブルな完全アテンションモデル

要約を読む要約を閉じる
📰ニュース

Google DeepMindが、様々なデータ形式を扱える汎用的なAIモデル「Perceiver IO」を発表しました。

🔍注目ポイント

大量の入力データを効率的に処理するため、ボトルネックアテンション機構を導入している点が技術的ポイントです。

🔮これからどうなる

画像、音声、テキストなど異なるデータを統一的に扱えるため、マルチモーダルAI開発が加速する可能性があります。

Perceiver IOは、Transformerの課題である入力データ量の多さによる計算コスト増大を解決するために設計されました。
入力データを潜在表現にマッピングし、その潜在表現間でアテンションを行うことで、計算量を大幅に削減しつつ、高い性能を維持します。
これにより、単一のモデルで多様なタスクに対応できるようになります。
OpenAI Blog ★4 LLM EN

アプリケーション向けGPT-3のカスタマイズ

要約を読む要約を閉じる
📰ニュース

OpenAIがGPT-3のファインチューニング機能を一般公開しました。

🔍注目ポイント

単一のコマンドでGPT-3を特定のタスクやデータに最適化できます。

🔮これからどうなる

企業や開発者がより高精度で専門的なAIアプリケーションを構築できるようになります。

ファインチューニングにより、GPT-3は特定のユースケースに特化した応答を生成できるようになり、プロンプトエンジニアリングの手間を大幅に削減します。
これにより、より少ないデータで高品質な結果を得ることが可能になります。
Hugging Face Blog ★4 LLM EN

CodeParrotをゼロからトレーニングする

要約を読む要約を閉じる
📰ニュース

Hugging FaceがCodeParrotというコード生成モデルをゼロからトレーニングした。

🔍注目ポイント

大規模なコードデータセットを用いて、Transformerモデルを効率的に学習させたのが技術的ポイント。

🔮これからどうなる

開発者はより高性能なコード生成AIを利用できるようになり、生産性向上が期待される。

CodeParrotは、Python、Java、JavaScriptなど様々なプログラミング言語のコードを生成できるモデルだよ。
Hugging FaceのTransformersライブラリとAccelerateツールを使って、分散学習環境で効率的に学習を進めたんだ。
これにより、コード補完やバグ修正など、開発作業を支援するツールへの応用が期待されているよ。
Hugging Face Blog ★4 LLM EN

Hugging Face TransformersとOptimumでIPUを始める

要約を読む要約を閉じる
📰ニュース

Hugging Face TransformersモデルをGraphcore IPUで効率的に実行するためのガイドが公開されました。

🔍注目ポイント

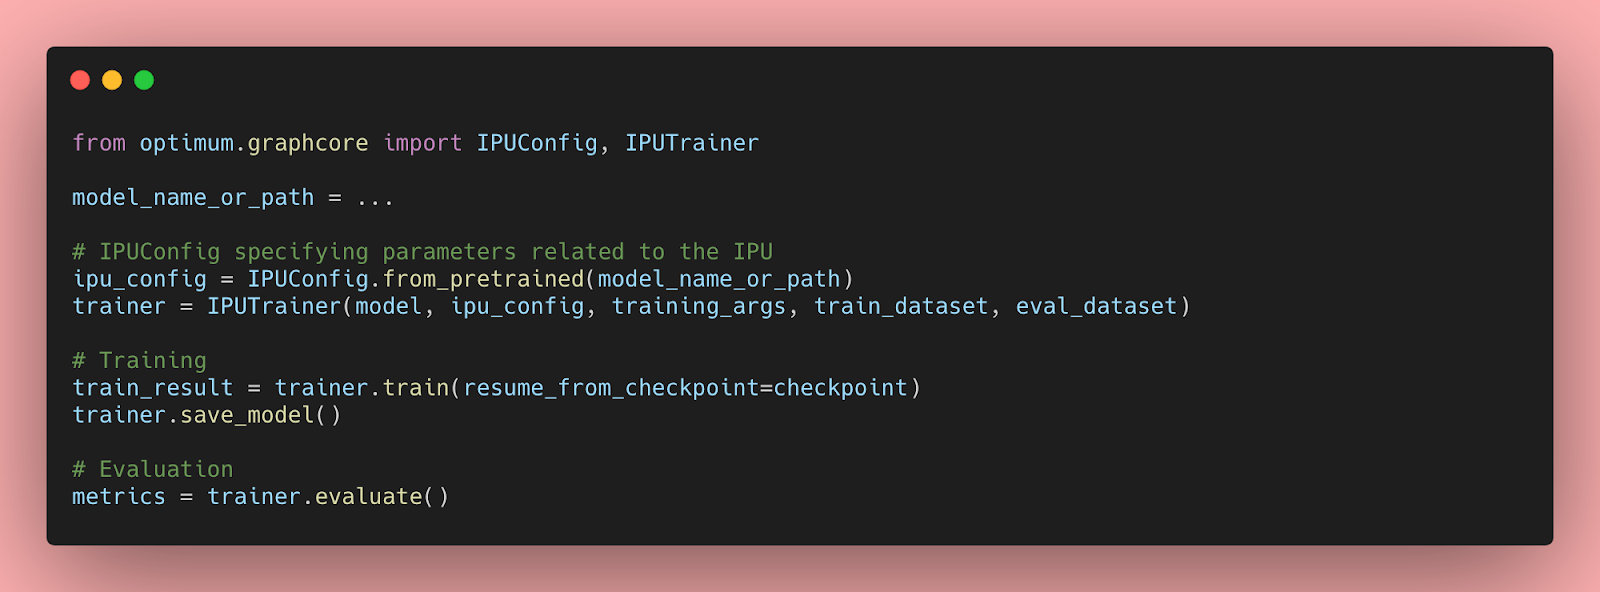
Optimum Graphcoreライブラリを使用し、PyTorchモデルをIPU向けに最適化・高速化する手法が紹介されています。

🔮これからどうなる

AI開発者は、Hugging FaceモデルをIPU上で簡単に利用し、より高速な学習・推論が可能になります。

Graphcore IPUは、AIワークロードに特化した並列処理アーキテクチャを持つプロセッサです。
Optimum Graphcoreは、Hugging Face TransformersとIPU間の橋渡しをするライブラリで、モデルの変換や最適化を自動化します。
これにより、開発者は複雑なIPUプログラミングを意識することなく、高性能なAIモデルをデプロイできます。
OpenAI Blog ★4 LLM EN

OpenAIのAPIが待機リストなしで利用可能に

要約を読む要約を閉じる
📰ニュース

OpenAIのAPIが、これまであった待機リストなしで誰でも利用可能になりました。

🔍注目ポイント

安全性に関する進歩により、APIの広範な提供が可能になった点が技術的なポイントです。

🔮これからどうなる

開発者はより迅速にOpenAIのAIモデルをプロダクトに組み込めるようになります。

これまでOpenAIのAPIを利用するには待機リストに登録し、承認を待つ必要がありました。
今回の変更により、開発者はすぐにAPIにアクセスし、アプリケーション開発を開始できます。
これはOpenAIが安全性に関する取り組みを進め、より多くのユーザーにAI技術を提供できるようになったことを示しています。
Hugging Face Blog ★4 LLM EN

Hugging Face Transformersで低リソースASR向けXLSR-Wav2Vec2をファインチューニング

要約を読む要約を閉じる
📰ニュース

Hugging Face Transformersライブラリを使って、低リソース言語の自動音声認識(ASR)モデルXLSR-Wav2Vec2をファインチューニングする方法が公開されました。

🔍注目ポイント

限られたデータセットでも、事前学習済みモデルを効率的に適応させることで、多言語対応のASR性能を向上させられる点が技術的ポイントです。

🔮これからどうなる

データが少ない言語圏でも高品質な音声認識技術が利用可能になり、言語の壁を越えた情報アクセスやコミュニケーションが促進されます。

本記事は、特にリソースの少ない言語向けに、Hugging FaceのTransformersライブラリと事前学習済みXLSR-Wav2Vec2モデルを活用したASRモデルのファインチューニング手順を詳細に解説しています。
これにより、開発者は少ないデータで多言語対応の音声認識システムを構築できるようになります。
Hugging Faceのツール群が、研究から実用までを強力にサポートしていることが示されています。
Hugging Face Blog ★4 LLM EN

現代CPUにおけるBERTライクモデル推論のスケーリング - パート2

要約を読む要約を閉じる
📰ニュース

Hugging FaceがBERTライクモデルのCPU推論を高速化する技術を解説しています。

🔍注目ポイント

ONNX RuntimeとIntel OpenVINOを組み合わせ、推論速度を大幅に向上させています。

🔮これからどうなる

より多くのユーザーが手元のCPUで高性能なLLMを効率的に利用できるようになります。

本記事は、CPUでのBERTライクモデル推論を最適化するための具体的な手法を深掘りしています。
特に、ONNX RuntimeとIntel OpenVINOという二つの主要なツールを連携させることで、推論のレイテンシを削減し、スループットを向上させる方法が詳細に説明されています。
これにより、クラウド環境だけでなく、エッジデバイスやローカル環境でのAIモデルの活用が促進されます。
OpenAI Blog ★4 LLM EN

算数の文章問題の解決

要約を読む要約を閉じる
📰ニュース

OpenAIが小学生レベルの算数文章問題を解くAIシステムを開発しました。

🔍注目ポイント

ファインチューニングされたGPT-3の約2倍の精度で、90%の問題を解くことができます。

🔮これからどうなる

AIが複雑な推論を必要とする問題解決能力を向上させる可能性を示しています。

このシステムは、9〜12歳の子どもたちの平均スコア60%に対し、同じ問題で55%のスコアを達成しました。
これは、AIが人間の子どもに近いレベルで算数問題を解けることを示しており、今後のAIの教育分野への応用が期待されます。
Hugging Face Blog ★4 LLM EN

大規模言語モデル:新しいムーアの法則か?

要約を読む要約を閉じる
📰ニュース

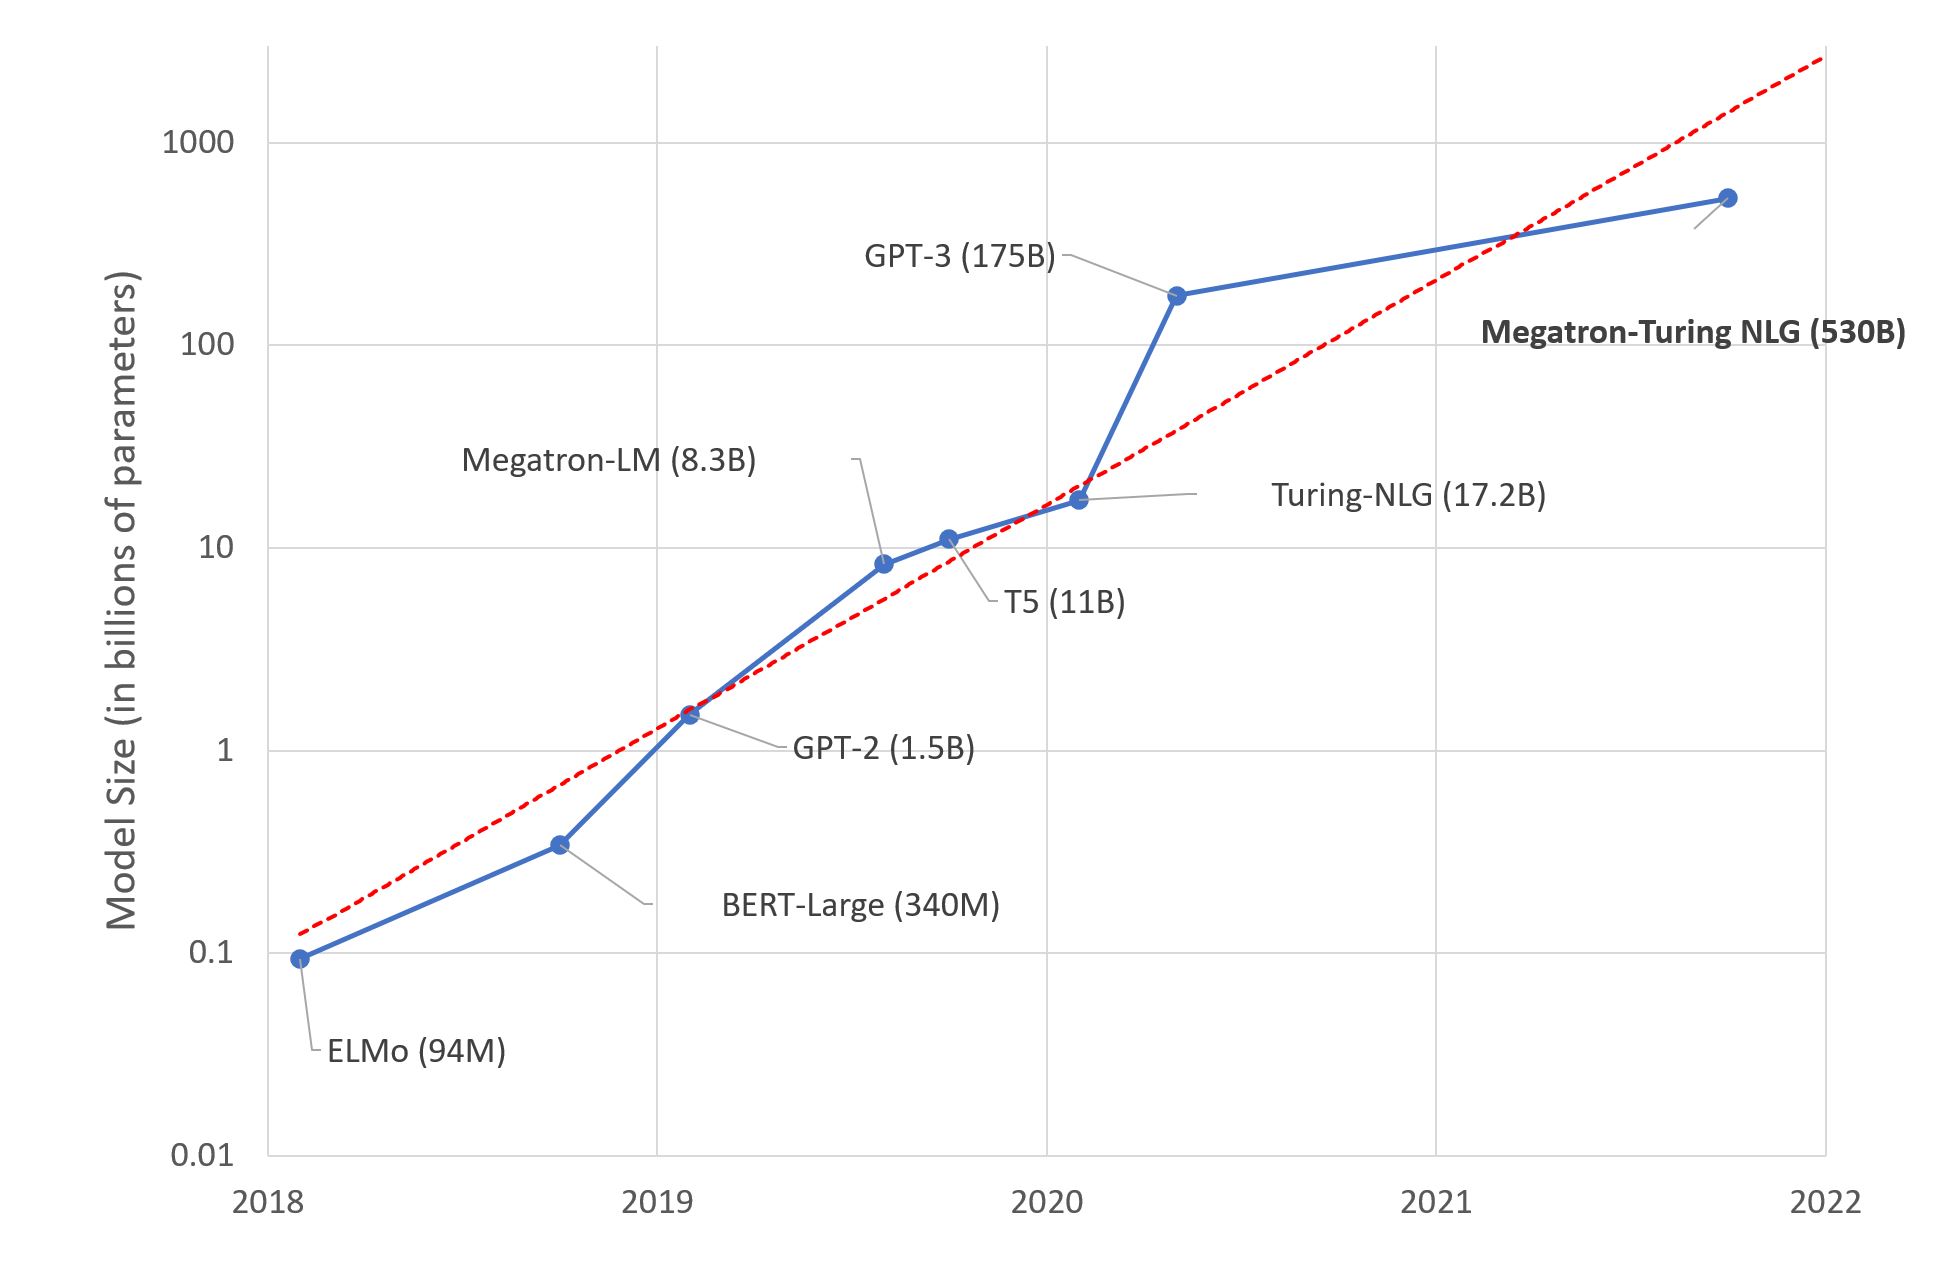
大規模言語モデル(LLM)の性能向上が、かつてのムーアの法則に似た指数関数的な成長を示している。

🔍注目ポイント

LLMの性能は、モデルサイズやデータ量、計算資源の増加に伴い予測可能な形で向上している。

🔮これからどうなる

AI開発の加速と普及により、様々な産業で新たなサービスや効率化が期待される。

ムーアの法則は半導体の集積度が約2年で倍増することを示したが、LLMも同様に性能が向上している。
これは、より大規模なモデルとデータ、計算資源を投入することで、より高性能なAIが実現可能であることを意味する。
この傾向が続けば、AI技術の進化はさらに加速するだろう。
Hugging Face Blog ★4 LLM EN

10億組の学習ペアで文章埋め込みモデルを訓練

要約を読む要約を閉じる
📰ニュース

Hugging Faceが10億組の学習ペアを用いた大規模な文章埋め込みモデルの訓練に成功しました。

🔍注目ポイント

大規模なデータセットと効率的な学習戦略により、既存モデルを上回る高性能な埋め込みモデルを構築しました。

🔮これからどうなる

開発者はより高精度なセマンティック検索やテキスト分類をアプリケーションに組み込めるようになります。

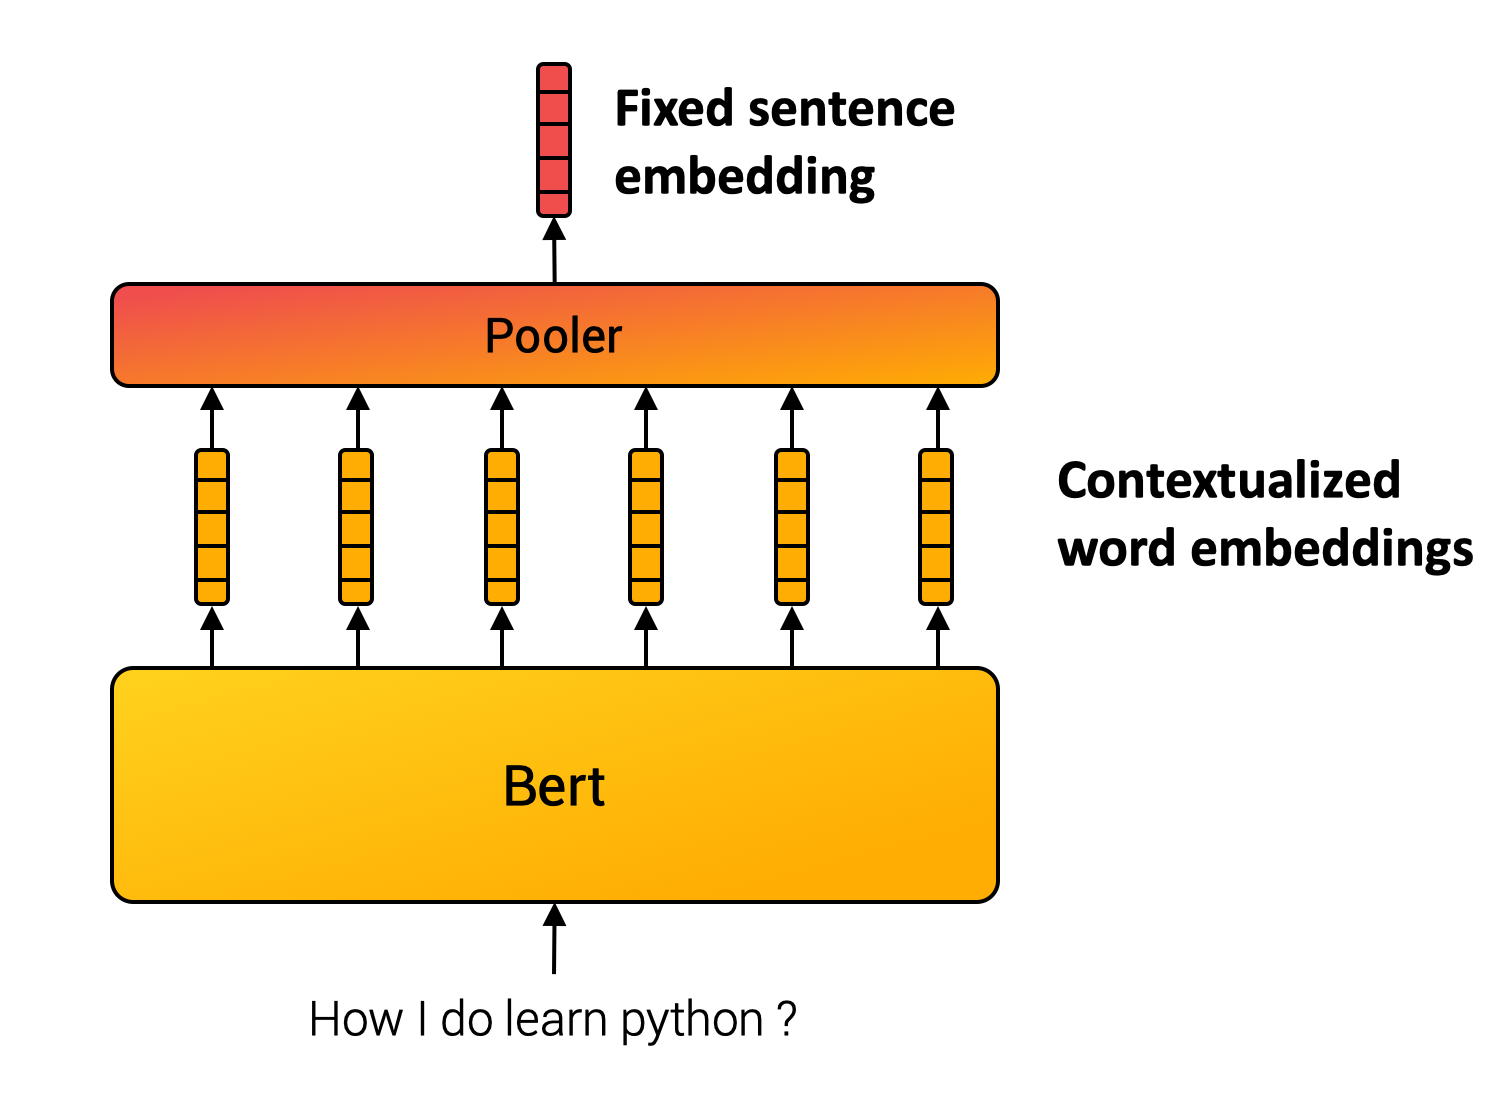
このモデルは、異なる文脈での単語やフレーズの意味をより正確に捉えることができ、多言語対応も強化されています。
これにより、情報検索、質問応答システム、要約などのタスクにおいて、より人間らしい理解と応答が可能になります。