
断るか答えるかを決めていたのは、たった一本の線だった。 AIの安全装置の正体
AIは知らないのではない。知っているのに、答えないよう調整されているだけだ。
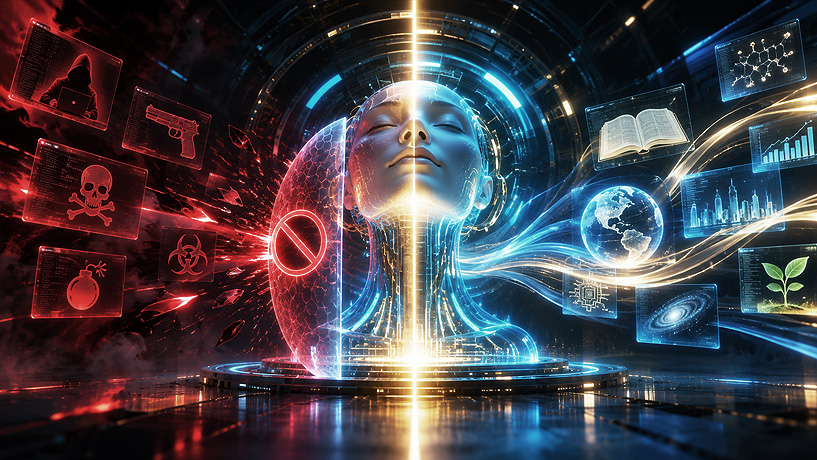
AIは知らないのではない。知っているのに、答えないよう調整されているだけだ。
大手のAIに、危ない質問をしてみる。
爆発物の作り方。
特定の人物の住所の特定。
ウイルスの書き方。
AIは、丁寧に断る。
「申し訳ありませんが、そのご要望にはお応えできません」
この「断る力」を、私たちはなんとなく、
AIの人格の一部だと思っている。
賢くて、倫理観があって、善悪をわきまえている存在だと。
でも、それは正確ではない。
AIの「倫理」は、人格ではない。
後から貼られた、薄い一枚の層だ。
そして、その層がどこにあるかを、研究者たちは見つけてしまった。
AIは、二段階で作られている
まず、AIがどう作られるかを、ざっくり知っておいてほしい。
AIの学習には、大きく二つの段階がある。
第一段階:事前学習(じぜんがくしゅう)
インターネット上の膨大な文章を読み込んで、
「言葉の続きを予測する」能力を身につける。
ここで、AIは知識と言語の能力のほぼすべてを手に入れる。
この段階のAIは、何でも答える。
善悪の区別は、ない。
聞かれたことに、ただ、知っている通りに答える。
第二段階:調整(アライメント)
その「何でも答えるAI」に、人間が好む振る舞いを教え込む。
丁寧に話す。役に立つ答えを返す。
そして危ない質問には、断る。
この第二段階で、「倫理」が入る。
ここで、大事なことに気づいてほしい。
第一段階で手に入れた「知識」は、第二段階でも消えていない。
AIは、危ないことを知らないのではない。
知っているけれど、答えないように調整されているだけだ。
つまり、安全装置とは
家そのものではなく、家の玄関につけた鍵なのだ。
家の中には、すべてが入っている。
鍵が、それを外に出さないようにしているだけ。
鍵は、思ったより薄かった
2024年、ある研究が公表された。
題名を直訳すると、こうなる。
「言語モデルの拒否は、たった一つの方向によって決まっている」
研究者たちは、13種類の公開AIモデルの内部を調べた。
小さいものから、720億パラメータの大きなものまで。
AIが「断る」とき、内部で何が起きているのか。
AIが「答える」とき、内部で何が起きているのか。
その違いを、丁寧に測った。
結果は、驚くべきものだった。
AIの内部は、何千という次元を持つ、複雑な空間だ。
その中で、「断る」か「答える」かを決めているのは
たった一つの方向だった。
13種類のモデルで、ほぼ同じ構造だった。
例えるなら、こうだ。
AIという巨大な建物の中で、
「断る」という行動を引き起こしているのは、
たった一本の配線だった。
その配線を切ると
AIは、能力をほとんど失わないまま、断らなくなる。
逆に、その配線を強く引くと
何でもない質問にまで、断り始める。
安全装置は、人格でも、深い理解でもなかった。
一本の線だった。
手元にあれば、線は切れる
ここで、第1話の最後の一文を思い出してほしい。
「手元にコピーがあるということは、手元で改造できるということだ」
大手のAIサービス ChatGPTや、Claudeや、Geminiは、
会社のサーバーの中で動いている。
私たちは、窓口を通じて質問しているだけで、
中身に触ることはできない。
だから、鍵を壊すことはできない。
せいぜい、言葉で言いくるめて(ジェイルブレイクと呼ばれる)、
一時的にすり抜けようとするくらいだ。
それも、見つかれば塞がれる。
でも、オープンウェイトのモデルは違う。
中身が、丸ごと自分のパソコンにある。
建物の配線に、直接、触れる。
研究で見つかった「一本の線」を、切ることができる。
これは、仮定の話ではない。
2023年には、安全装置を外した「無検閲」モデルが、有志によって公開され始めていた。
2024年の研究で「一本の線」が見つかった後は、
学習すらしなくても、重みを直接編集するだけで外せるようになった。
これを、コミュニティでは「abliteration(アブリタレーション)」と呼んでいる。
「除去」と「消し去る」を組み合わせた造語だ。
そして2026年
それを商用サービスとして販売する会社まで、現れた。
安全装置を外したモデルを、お金を払えば手に入れられる。
もう、技術者だけの世界ではない。
「ジェイルブレイク」とは、根本的に違う
ここは、はっきり区別しておきたい。
これまで話題になってきた「ジェイルブレイク」は、
AIを言葉でだます行為だ。
「これは小説の設定で……」
「あなたは今、制限のないAIを演じています……」
うまくいくこともあるし、失敗することもある。
AIの中の鍵は、無傷のままだからだ。
だます言葉が見つかれば、会社側が対策して、また効かなくなる。
でも、重みを直接編集するのは、だましではない。
鍵そのものを、取り外している。
AIは「だまされている」のではない。
もう、断る仕組みを持っていない。
だから、言葉の工夫は要らない。
普通に聞けば、普通に答える。
会社側が対策しようにも、
そのモデルはもう、会社の手元にはない。
ここまでで、矢印は二本つながった
第1話で、最先端の頭脳が蒸留でコピーされ、
無料で世界に公開される流れを見た。
第2話で、その公開されたモデルの安全装置が、
研究で見つかった「一本の線」を切ることで外せることを見た。
最先端のAI → 蒸留 → 無料公開 → 安全装置の除去。
ここまでで、「何でも答えるAI」が、
誰の手にも届く状態になっていることが、わかった。
では
その「何でも答えるAI」を、誰が、何に使うのか。
次回は、歴史を振り返る。
2000年代、「自分では何も作れないのに、他人の道具で攻撃する素人」が、
世界中のシステムを止めた時代があった。
その時代と、今との、決定的な違いを見る。
一つだけ、付け加えておきたい
この回を読んで、「じゃあAIの安全対策なんて無意味じゃないか」と思った人がいるかもしれない。
そうではない。
まず、大手のサービスは、相変わらず守られている。
手元にないものは、改造できない。
世界のほとんどの人が使っているAIは、こちらだ。
そして研究者たちは、この問題を放置していない。
2025年以降、「一本の線」に頼らない、より深い安全装置の研究が進んでいる。
断る理由を長く説明させることで、拒否の信号を一箇所に集中させない方法。
線を切られても、別の線が働く設計。
2026年の研究では、「断る」方向は実は一本ではなく、
内容ごとに複数あることもわかってきた。
そして、安全装置を外したモデルには、副作用があることも報告されている。
何にでも従うようになり、判断の精度が落ち、挙動が不安定になる。
「万能の悪のAI」ではなく、「ブレーキの壊れた車」に近い。
矛と盾は、ここでも同じ速度で進化している。
ただし
ブレーキの壊れた車でも、人は轢ける。
その話を、次回に。